BAB 26: Hutan dalam Film Pendek: Deret Waktu, Perubahan, dan Klasifikasi dengan Skrip
Studi kasus: "Apa yang terjadi sejak dua tahun lalu?" #
Kepala Seksi menaruh dua puluh empat citra satelit KPH Contoh di meja Anda. Pertanyaannya bertubi-tubi. Di mana hutan hilang, kapan, dan seberapa luas? Mana yang terbakar, dan benarkah titik panas itu? Kalau semua dijawab lewat klik, Anda mengulang pekerjaan dua puluh empat kali. Dengan skrip, tiap pertanyaan menjadi satu berkas Python yang bisa dijalankan ulang kapan saja.
Konsep: deret waktu dalam tiga kalimat #
Deret waktu itu seperti buku lipat bergambar: tiap lembar hampir sama, dan gerakan baru terlihat saat lembarnya dibalik berurutan. Satu citra hanya memotret satu hari. Puluhan citra yang ditumpuk menurut tanggal memberi tiap piksel sebuah riwayat angka, dan riwayat itu bisa dibaca seperti detak jantung.
Lima istilah yang perlu Anda kenal sekarang:
- Deret waktu: kumpulan citra lokasi yang sama pada tanggal berbeda. Di bab ini ada 24 tanggal, dari 5 Januari 2024 sampai 25 Desember 2025.
- NDVI: angka kehijauan tumbuhan, dihitung dari cahaya merah dan inframerah dekat. Hutan sehat bernilai sekitar 0,85. Awan, tanah terbuka, dan air bernilai jauh lebih rendah.
- SCL: peta penanda yang menyertai tiap citra. Isinya kode kelas tiap piksel, misalnya vegetasi, air, atau awan.
- Fitur: angka ringkas yang menggambarkan perilaku satu piksel. Fitur menjadi bahan belajar bagi mesin.
- Validasi: pemeriksaan apakah peta hasil boleh dipercaya.
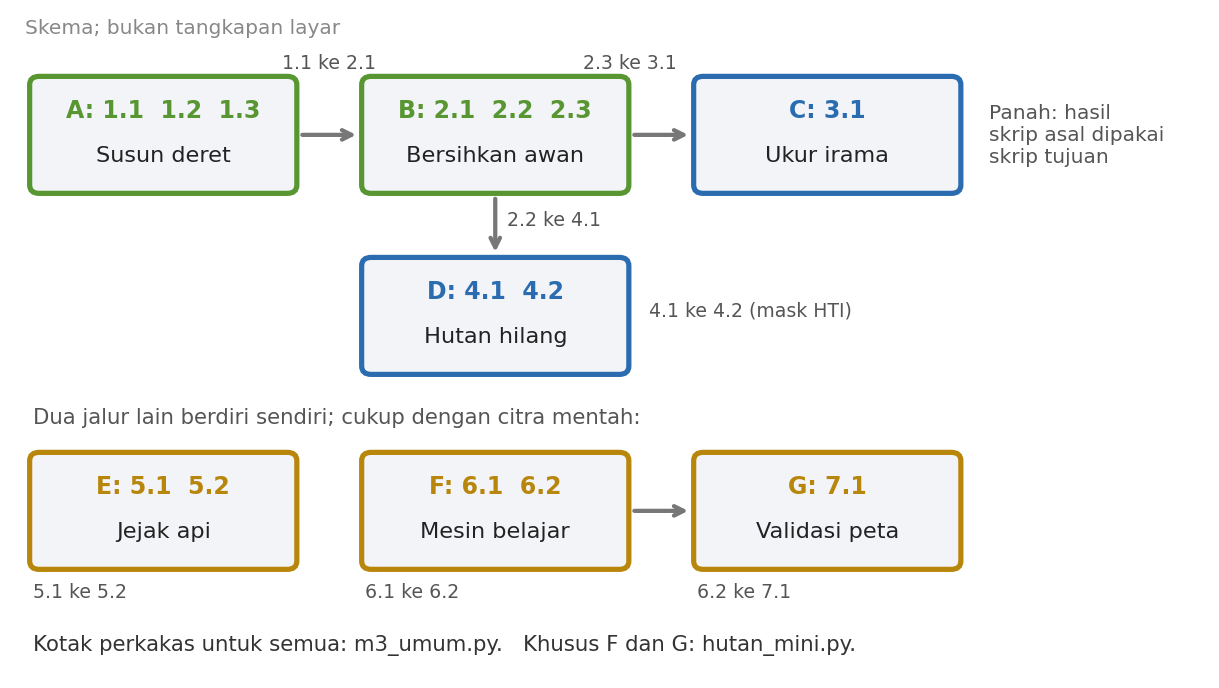
Bab ini panjang karena isinya empat belas skrip. Bacalah per kelompok, dan jangan terburu-buru ingin menghafal. Tiap kelompok punya Konsep dan gambar sendiri.
| Kelompok | Skrip | Pertanyaan yang dijawab |
|---|---|---|
| A. Menyusun deret | 26.1 sampai 26.3 | Bagaimana 24 berkas menjadi satu tumpukan bertanggal? |
| B. Membersihkan awan | 26.4 sampai 26.6 | Bagaimana membuang awan dan menambal lubangnya? |
| C. Mengukur irama | 26.7 | Seperti apa irama normal tiap tutupan lahan? |
| D. Hutan hilang | 26.8 dan 26.9 | Di mana, seberapa luas, dan kapan hutan hilang? |
| E. Jejak api | 26.10 dan 26.11 | Berapa hektare yang terbakar, dan titik panas mana yang benar? |
| F. Mesin belajar | 26.12 dan 26.13 | Bisakah satu peta menyebut semua kelas sekaligus? |
| G. Validasi | 26.14 | Seberapa boleh peta itu dipercaya? |
Tiap skrip bernomor Skrip 26.n. Di dalam berkasnya mungkin tertulis nomor lain, misalnya SKRIP 1.1, mengikuti penomoran Buku M3. Bab ini selalu menyebut nama berkas aslinya.
Persiapan: folder, data, dan cara menjalankan #
Semua skrip bab ini memakai satu paket data dan satu folder hasil. Ketiganya harus Anda atur sebelum menjalankan skrip pertama.
Bahan. Paket data paket-m3. Isinya 24 citra Sentinel-2 buatan (berkas _refl.tif berisi enam band, berkas _SCL.tif berisi kode kelas), folder acuan (kunci jawaban), folder vektor (titik panas, titik latih, kawasan hutan tanaman), dan daftar tanggal Daftar_Citra.csv. Semua data sintetis, jadi hasilnya bukan kondisi hutan nyata. Luas area 400 m kali 400 m, atau 40 kali 40 piksel, dengan piksel 10 m.
- Buat satu folder untuk skrip, misalnya
D:/Latihan_M3/skrip. Salin ke sana keempat belas skrip dan dua berkas pembantu (m3_umum.py,hutan_mini.py). Semuanya harus satu folder. - Letakkan
paket-m3di tempat yang Anda tahu, misalnyaD:/Latihan_M3/paket-m3. - Tentukan folder hasil, misalnya
D:/Latihan_M3/hasil. Skrip membuatnya sendiri bila belum ada. - Beri tahu skrip lokasi paket dan hasil lewat dua variabel lingkungan (pengaturan di komputer yang bisa dibaca program):
M3_PAKETdanM3_HASIL. Cara kerjanya dibahas di Bab 8.
Dari Konsol Python QGIS (Bab 3), langkah 4 dan menjalankan skrip pertama kira-kira seperti ini. Ketik tiap blok, lalu Enter. Konsol ini belum saya coba di jendela QGIS; urutannya saya ambil dari pola Bab 3 [CEK].
import os, sys
os.environ["M3_PAKET"] = r"D:/Latihan_M3/paket-m3"
os.environ["M3_HASIL"] = r"D:/Latihan_M3/hasil"
sys.path.append(r"D:/Latihan_M3/skrip")
exec(open(r"D:/Latihan_M3/skrip/1_1_susun_ndvi.py", encoding="utf8").read())
Urutan itu penting. Kedua variabel harus diisi sebelum skrip pertama dijalankan, karena m3_umum.py membacanya saat pertama kali diimpor. Bila Python sudah terlanjur mengimpornya, mulai ulang Konsol.
Bila Anda menjalankan lewat terminal, pakai pola "menyalakan QGIS tanpa jendela" dari Bab 3. Semua hasil di bab ini saya uji dengan pola itu, pada QGIS 4.0.2, dengan paket data di folder kerja saya. Karena itu, jalur yang muncul di blok HASIL saya tuliskan sebagai D:/Latihan_M3/hasil. Jalur di layar Anda akan mengikuti folder Anda sendiri.
Urutan menjalankan. Beberapa skrip memerlukan hasil skrip lain. Jalankan sesuai urutan di tabel ini, dan baca baris pertama keluarannya sebelum lanjut.
| Skrip | Memerlukan hasil | Menghasilkan |
|---|---|---|
26.1 1_1 | tidak ada | NDVI_deret.tif, folder ndvi |
26.2 1_2, 26.3 1_3 | 26.1 | grafik PNG, layer bertanggal |
26.4 2_1 | 26.1 | folder ndvi_bersih |
26.5 2_2 | 26.4 | enam komposit komposit_ndvi_... |
26.6 2_3 | tidak ada | NDVI_isi.tif |
26.7 3_1 | 26.6 | metrik_ndvi.tif, anomali_ndvi.tif |
26.8 4_1 | 26.5 | mask_hti.tif, deforestasi_2waktu.tif |
26.9 4_2 | 26.8 | tanggal_deforestasi.tif |
26.10 5_1 | tidak ada | bekas_bakar.tif |
26.11 5_2 | 26.10 | bekas_bakar.gpkg |
26.12 6_1 | tidak ada | fitur_deret.tif |
26.13 6_2 | 26.12 | peta_rf.tif |
26.14 7_1 | 26.12 dan 26.13 | peta_ndvi_saja.tif |
Dua kebiasaan akan menyelamatkan Anda sepanjang bab ini. Pertama, baca baris pertama keluaran. Kedua, jangan percaya skrip yang tidak berteriak: skrip yang tidak dijaga bisa tetap jalan dengan masukan yang salah dan menghasilkan angka yang keliru tanpa pesan galat. Skrip 26.4 memberi contoh penjagaannya: ia berhenti dengan pesan bila masukannya tidak terbaca. Bagian Jebakan Skrip 26.4 menjelaskannya.
Kotak perkakas: m3_umum.py #
Empat belas skrip bab ini memulai dengan baris import m3_umum as U. Berkas m3_umum.py adalah kotak perkakas buatan penulis: kumpulan fungsi kecil yang dipakai bersama, supaya tiap skrip tidak mengulang pekerjaan yang sama. Bayangkan bengkel dengan satu lemari alat. Semua tukang mengambil obeng dari lemari itu, dan tidak ada yang membuat obeng sendiri.
Kata U hanyalah nama pendek (alias) untuk kotak itu. U.daftar_citra() berarti: "ambil perkakas daftar_citra dari kotak U". Cara kerja import dan alias dibahas di Bab 8, dan cara membuat fungsi sendiri di Bab 7.
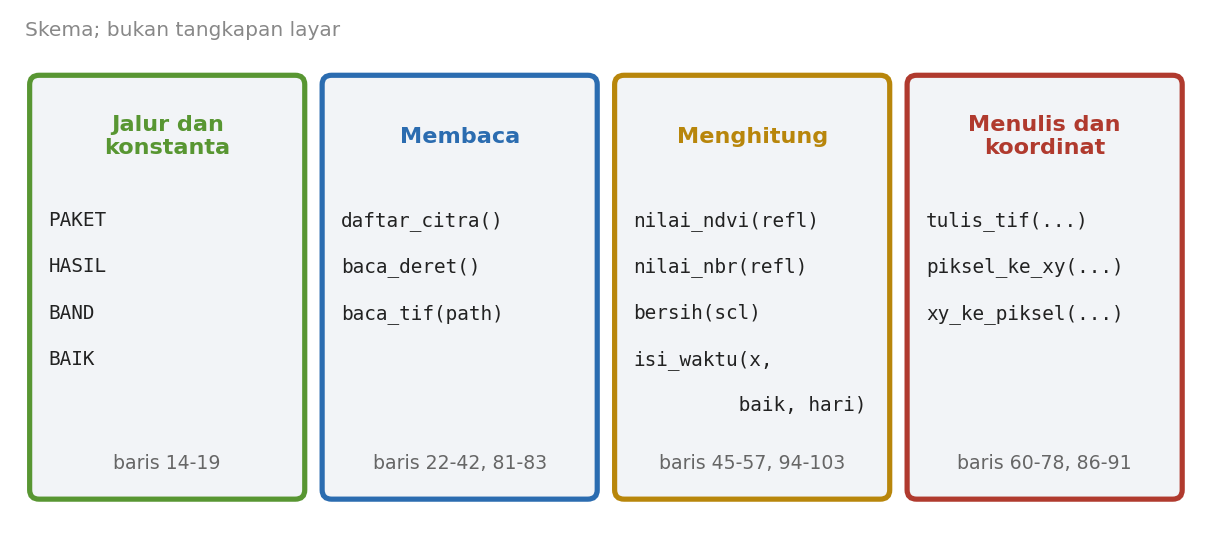
Tujuan. Menyediakan jalur data, daftar citra, pembaca dan penulis GeoTIFF, rumus NDVI dan NBR, serta penambal lubang awan, untuk dipakai semua skrip.
Bahan. Berkas ini tidak dijalankan sendiri. Ia diimpor oleh skrip lain dan harus satu folder dengan mereka. Ia memakai numpy dan osgeo.gdal (dibahas di Bab 12).
Skrip utuh:
# -*- coding: utf-8 -*-
"""m3_umum.py: fungsi bantu bersama untuk skrip Seri M3. Penulis: Badar Mubarok Yogaswara
Letakkan berkas ini satu folder dengan skrip lain. Ubah PAKET dan HASIL sesuai komputer Anda,
atau isi variabel lingkungan M3_PAKET dan M3_HASIL."""
import csv
import datetime as dt
import os

import numpy as np
from osgeo import gdal

gdal.UseExceptions()

PAKET = os.environ.get("M3_PAKET", r"D:/Latihan_M3/paket-m3")     # folder paket data sintetis
HASIL = os.environ.get("M3_HASIL", r"D:/Latihan_M3/hasil")        # folder keluaran Anda
os.makedirs(HASIL, exist_ok=True)

BAND = {"B02": 0, "B03": 1, "B04": 2, "B08": 3, "B11": 4, "B12": 5}   # urutan band di berkas *_refl.tif
BAIK = (4, 5, 6)                                                       # kode SCL: vegetasi, bukan vegetasi, air


def daftar_citra():
    """Baca Daftar_Citra.csv: kembalikan daftar (tanggal, jalur_refl, jalur_scl)."""
    hasil = []
    with open(os.path.join(PAKET, "citra", "Daftar_Citra.csv"), encoding="utf8") as f:
        for r in csv.DictReader(f):
            hasil.append((dt.date.fromisoformat(r["tanggal"]),
                          os.path.join(PAKET, "citra", r["berkas_refl"]),
                          os.path.join(PAKET, "citra", r["berkas_scl"])))
    return hasil


def baca_deret():
    """Kembalikan tanggal (daftar), refl (T,6,H,W), scl (T,H,W), geotransform, proyeksi."""
    tgl, refl, scl = [], [], []
    for d, pr, ps in daftar_citra():
        a = gdal.Open(pr)
        refl.append(a.ReadAsArray().astype("float32"))
        scl.append(gdal.Open(ps).ReadAsArray())
        gt, prj = a.GetGeoTransform(), a.GetProjection()
        tgl.append(d)
    return tgl, np.array(refl), np.array(scl), gt, prj


def nilai_ndvi(refl):
    nir, red = refl[:, BAND["B08"]], refl[:, BAND["B04"]]
    return (nir - red) / (nir + red + 1e-9)


def nilai_nbr(refl):
    nir, swir = refl[:, BAND["B08"]], refl[:, BAND["B12"]]
    return (nir - swir) / (nir + swir + 1e-9)


def bersih(scl):
    """True di piksel yang boleh dipakai (bukan awan, bayangan, atau cirrus)."""
    return np.isin(scl, BAIK)


def tulis_tif(path, arr, gt, prj, nodata=None, deskripsi=None, tipe=None):
    """Tulis larik (H,W) atau (B,H,W) ke GeoTIFF."""
    arr = np.asarray(arr)
    if arr.ndim == 2:
        arr = arr[None]
    if tipe is None:
        tipe = gdal.GDT_Float32 if arr.dtype.kind == "f" else gdal.GDT_Byte
    os.makedirs(os.path.dirname(path), exist_ok=True)
    ds = gdal.GetDriverByName("GTiff").Create(path, arr.shape[2], arr.shape[1], arr.shape[0], tipe, ["COMPRESS=LZW"])
    ds.SetGeoTransform(gt)
    ds.SetProjection(prj)
    for i in range(arr.shape[0]):
        b = ds.GetRasterBand(i + 1)
        b.WriteArray(arr[i])
        if nodata is not None:
            b.SetNoDataValue(nodata)
        if deskripsi:
            b.SetDescription(deskripsi[i])
    ds = None


def baca_tif(path):
    ds = gdal.Open(path)
    return ds.ReadAsArray(), ds.GetGeoTransform(), ds.GetProjection()


def piksel_ke_xy(gt, baris, kolom):
    return gt[0] + (kolom + 0.5) * gt[1], gt[3] + (baris + 0.5) * gt[5]


def xy_ke_piksel(gt, x, y):
    return int((gt[3] - y) / -gt[5]), int((x - gt[0]) / gt[1])


def isi_waktu(x, baik, hari):
    """Interpolasi linear sepanjang waktu. x dan baik berbentuk (T,H,W); hari = hari ke- tiap tanggal."""
    T, H, W = x.shape
    hasil = np.full(x.shape, np.nan, dtype="float64")
    for i in range(H):
        for j in range(W):
            ok = baik[:, i, j]
            if ok.any():
                hasil[:, i, j] = np.interp(hari, hari[ok], x[ok, i, j])
    return hasil
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-4 | # -*- coding... dan teks tiga kutip | Baris 1 memberi tahu Python bahwa berkas berisi huruf UTF-8. Baris 2-4 adalah docstring (keterangan modul, dibahas di Bab 7). |
| 5-10 | import csv sampai from osgeo import gdal | Panggil lima perkakas: csv (membaca tabel teks), datetime (tanggal, diberi nama pendek dt), os (jalur dan folder), numpy (hitungan larik, diberi nama pendek np), dan gdal (membaca serta menulis raster). |
| 12 | gdal.UseExceptions() | Minta GDAL berteriak (memunculkan galat) bila ada masalah, bukan diam-diam gagal. |
| 14 | PAKET = os.environ.get("M3_PAKET", r"D:/Latihan_M3/paket-m3") | Isi kotak PAKET dengan lokasi paket data. Python mencari pengaturan M3_PAKET dulu. Bila tidak ada, ia memakai jalur cadangan di ujung baris, yang menunjuk komputer penulis. |
| 15 | HASIL = os.environ.get("M3_HASIL", ...) | Sama seperti baris 14, untuk folder hasil. |
| 16 | os.makedirs(HASIL, exist_ok=True) | Buat folder hasil bila belum ada. exist_ok=True berarti: bila sudah ada, tidak apa-apa. |
| 18 | BAND = {"B02": 0, ...} | Kamus (Bab 5): nama band lalu nomor urutnya di berkas _refl.tif. Nomor mulai dari 0. |
| 19 | BAIK = (4, 5, 6) | Tuple (Bab 5): kode SCL yang dianggap piksel bersih, yaitu vegetasi (4), bukan vegetasi (5), dan air (6). |
| 22-30 | def daftar_citra(): | Fungsi yang membaca Daftar_Citra.csv. Baris 25-26 membuka berkas dan membaca tiap baris tabel sebagai kamus. Baris 27-29 menambahkan satu tuple ke daftar: tanggal, jalur berkas refl, jalur berkas SCL. Baris 30 mengembalikannya. |
| 25 | with open(...) as f: | Buka berkas dan tutup otomatis saat blok selesai (Bab 9). |
| 27 | dt.date.fromisoformat(r["tanggal"]) | Ubah teks seperti 2024-01-05 menjadi objek tanggal sungguhan. |
| 33-42 | def baca_deret(): | Fungsi yang membaca semua citra sekaligus. Hasilnya lima benda: daftar tanggal, larik reflektansi, larik SCL, geotransform, dan proyeksi. |
| 36-41 | for d, pr, ps in daftar_citra(): | Untuk tiap tanggal: buka berkas refl (baris 37), simpan lariknya sebagai bilangan desimal 32 bit (baris 38), simpan larik SCL (baris 39), catat geotransform dan proyeksi (baris 40), simpan tanggal (baris 41). |
| 42 | return tgl, np.array(refl), np.array(scl), gt, prj | Susun daftar menjadi larik besar. Bentuk refl adalah (24, 6, 40, 40): tanggal, band, baris, kolom. |
| 45-47 | def nilai_ndvi(refl): | NDVI = (inframerah dekat dikurangi merah) dibagi (inframerah dekat ditambah merah). 1e-9 adalah angka sangat kecil agar tidak terjadi pembagian dengan nol. |
| 50-52 | def nilai_nbr(refl): | NBR = (inframerah dekat dikurangi SWIR2) dibagi (jumlahnya). Memakai band B08 dan B12. |
| 55-57 | def bersih(scl): | Hasilnya larik benar atau salah: benar bila kode SCL ada di BAIK. np.isin berarti "apakah angka ini termasuk dalam daftar". |
| 60-78 | def tulis_tif(...) | Menulis larik ke berkas GeoTIFF. Baris 63-64 menambah sumbu band bila larik hanya dua dimensi. Baris 65-66 memilih tipe data: desimal menjadi Float32, selain itu menjadi Byte. Baris 68 membuat berkas terkompres. Baris 71-77 menulis tiap band, nilai kosong (nodata), dan namanya. Baris 78 menutup berkas. |
| 81-83 | def baca_tif(path): | Membaca satu GeoTIFF. Mengembalikan tiga benda: larik, geotransform, proyeksi. |
| 86-87 | def piksel_ke_xy(...) | Mengubah nomor baris dan kolom piksel menjadi koordinat peta (titik tengah piksel). |
| 90-91 | def xy_ke_piksel(...) | Kebalikannya: koordinat peta menjadi nomor baris dan kolom. |
| 94-103 | def isi_waktu(x, baik, hari) | Menambal lubang awan dengan interpolasi linear sepanjang waktu, piksel demi piksel. Skrip 26.6 membuat versi sendiri yang hampir sama. |
Hasil. Perkakas ini bisa Anda coba langsung di Konsol, setelah dua variabel lingkungan terisi:
import m3_umum as U
d = U.daftar_citra()
print(len(d), d[0][0])
tgl, refl, scl, gt, prj = U.baca_deret()
print(refl.shape, scl.shape)
print(U.xy_ke_piksel(gt, 312100, 9996100))
Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
24 2024-01-05
(24, 6, 40, 40) (24, 40, 40)
(30, 10)
Artinya: ada 24 tanggal, tiap tanggal enam band berukuran 40 kali 40, dan titik 312100, 9996100 jatuh di baris 30, kolom 10.
Bagian yang boleh diubah.
- Baris 14-15, jalur cadangan. Ganti dengan folder di komputer Anda, supaya tidak perlu mengisi variabel lingkungan tiap kali.
- Baris 19,
BAIK. Tuple kelas SCL yang dianggap bersih. Menghapus angka 6 membuang piksel air dari analisis. Skrip 26.4 punya ekspresi sendiri, jadi ubahan ini tidak memengaruhinya. - Baris 68,
COMPRESS=LZW. Pilihan kompresi berkas hasil. Hapus bila Anda ingin berkas tanpa kompresi.
Jebakan.
- Folder dibuat saat impor. Baris 16 berjalan begitu
import m3_umumdilakukan. Saya mengujinya: denganM3_HASILmenunjuk folder yang belum ada, folder itu langsung muncul setelah impor, walau belum ada hasil apa pun. Salah ketik jalur akan menghasilkan folder baru yang salah. - Tipe data diam-diam berubah. Baris 65-66 hanya mengenal Float32 dan Byte. Larik bilangan bulat besar terpotong tanpa pesan, kecuali Anda menyebut
tipesendiri. Kasus nyatanya ada di Skrip 26.9, yang memilihgdal.GDT_Int32. Buktinya saya tunjukkan di sana. - Jalur cadangan menunjuk komputer penulis. Bila Anda lupa mengisi
M3_PAKET, galatnyaFileNotFoundErrorsaat membukaDaftar_Citra.csv. Saya mengujinya dengan jalur paket yang salah, dan galat itu muncul dari baris 25. - Semua citra dianggap sebidang. Baris 40 hanya mengingat geotransform citra terakhir. Bila citra Anda berbeda ukuran atau lokasi, hasilnya keliru tanpa peringatan.
Latihan variasi.
- Cetak tanggal dan jalur berkas SCL untuk tanggal terakhir.
- Hitung berapa persen piksel bersih (menurut
bersih) pada seluruh deret.
Contoh jawaban:
print(d[-1][0], d[-1][2])
print(round(float(U.bersih(scl).mean()), 3))
Baris pertama mencetak tanggal terakhir dan jalur SCL-nya. Baris kedua mencetak 0.747 pada data ini: sekitar 75 persen piksel-tanggal bersih, sisanya (25 persen) tertutup awan, bayangan, atau cirrus.
Kelompok A: Menyusun deret, dari 24 berkas menjadi satu tumpukan #
Konsep: tumpukan bertanggal dalam tiga kalimat #
Bayangkan 24 foto yang dijilid menjadi album bertanggal: satu halaman satu tanggal. Di komputer, album itu disebut tumpukan (stack): satu berkas raster dengan 24 band, dan tiap band adalah satu tanggal. Bila Anda menusuk album itu dengan jarum di satu titik, nilai-nilai yang tertusuk membentuk profil waktu titik itu.
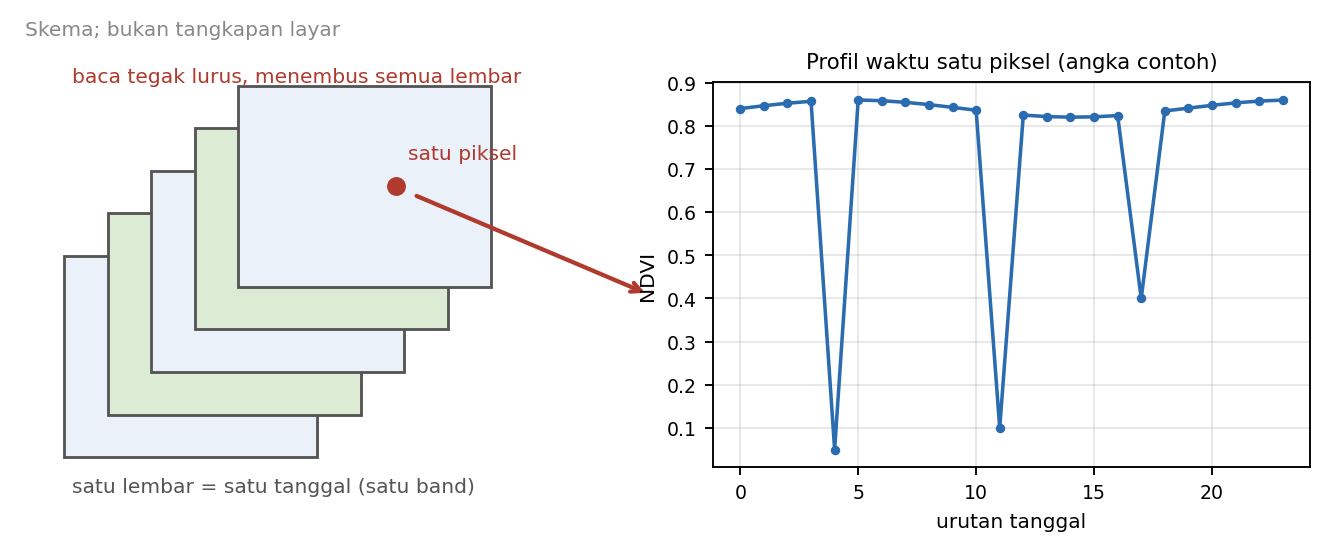
Lima istilah yang perlu Anda kenal sekarang:
- Tumpukan (stack): satu berkas raster yang berisi banyak band.
- Band: satu lembar dalam tumpukan. Di bab ini, satu band berarti satu tanggal.
- Profil waktu: deretan nilai satu piksel sepanjang tanggal.
- Kalkulator raster (Raster Calculator): alat QGIS yang menghitung rumus di atas raster, piksel demi piksel.
processing.run: perintah Python untuk memanggil alat QGIS, seperti menekan tombol alat itu dari skrip (dibahas di Bab 21).
Kelompok ini terdiri dari tiga skrip. Skrip 26.1 membuat tumpukannya. Skrip 26.2 membacanya dan menggambar grafik. Skrip 26.3 menempelkan tanggal supaya QGIS bisa memutarnya seperti film.
Skrip 26.1: Menyusun NDVI menjadi tumpukan 24 band #
Berkas 1_1_susun_ndvi.py. Di dalam berkasnya tertulis "SKRIP 1.1", mengikuti penomoran Buku M3.
Tujuan. Menghitung NDVI untuk tiap dari 24 citra, lalu menumpuk semuanya menjadi satu berkas 24 band yang tiap bandnya diberi tanggal.
Bahan. Paket data paket-m3 (folder citra) dan kotak perkakas m3_umum.py. Jalankan dari Konsol Python QGIS, atau dari terminal dengan pola Bab 3. Waktu jalan sekitar sepuluh detik.
Skrip ini bekerja dalam enam tahap.
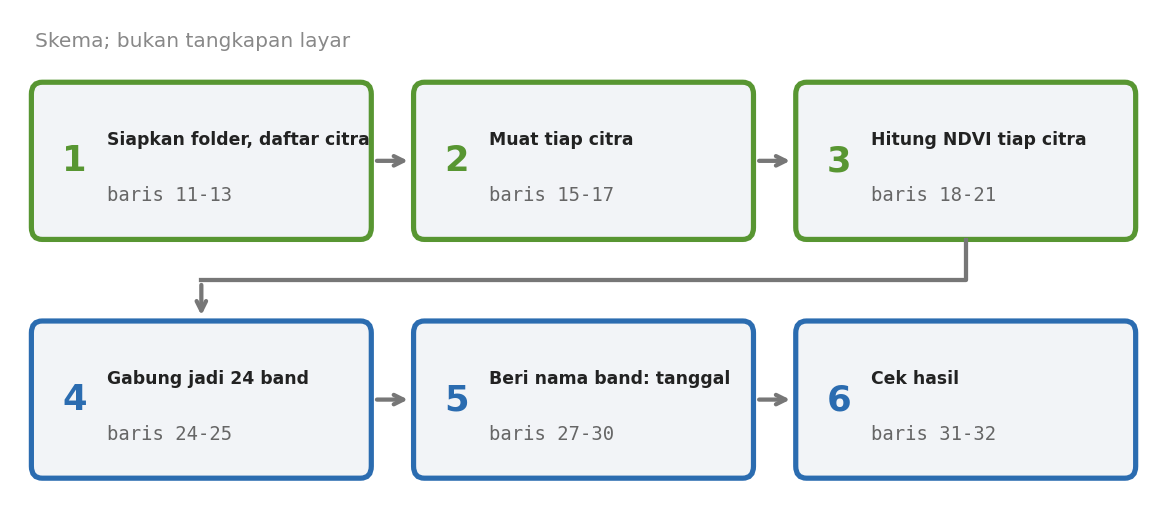
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 1.1: Susun deret waktu NDVI dari 24 citra Sentinel-2 sintetis (jalankan di Python Console QGIS)
# Penulis: Badar Mubarok Yogaswara
# Hasil: NDVI per tanggal (hasil/ndvi/NDVI_YYYYMMDD.tif) dan satu tumpukan 24 band: hasil/NDVI_deret.tif
import os
import processing
from qgis.core import QgsRasterLayer, QgsProject
from osgeo import gdal
import m3_umum as U

os.makedirs(os.path.join(U.HASIL, "ndvi"), exist_ok=True)
daftar = U.daftar_citra()
keluaran = []
for tgl, pr, ps in daftar:
    nama = "S2_" + tgl.strftime("%Y%m%d") + "_refl"
    lyr = QgsRasterLayer(pr, nama)
    QgsProject.instance().addMapLayer(lyr, False)            # tanpa menampilkan di kanvas
    out = os.path.join(U.HASIL, "ndvi", "NDVI_%s.tif" % tgl.strftime("%Y%m%d"))
    ekspresi = '("%s@4" - "%s@3") / ("%s@4" + "%s@3")' % (nama, nama, nama, nama)   # band 4 = B08, band 3 = B04
    processing.run("native:rastercalc", {"LAYERS": [lyr], "EXPRESSION": ekspresi, "OUTPUT": out})
    keluaran.append(out)

# gabungkan menjadi satu berkas: tiap berkas menjadi satu band (SEPARATE)
stack = os.path.join(U.HASIL, "NDVI_deret.tif")
processing.run("gdal:merge", {"INPUT": keluaran, "SEPARATE": True, "DATA_TYPE": 5, "OUTPUT": stack})
# beri nama band sesuai tanggal
ds = gdal.Open(stack, gdal.GA_Update)
for i, (tgl, _, _) in enumerate(daftar):
    ds.GetRasterBand(i + 1).SetDescription(tgl.isoformat())
ds = None
lyr = QgsRasterLayer(stack, "NDVI_deret")
print("Tumpukan:", stack, "valid:", lyr.isValid(), "band:", lyr.bandCount())
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-4 | # -*- coding... dan komentar | Baris 1 menandai berkas berhuruf UTF-8. Baris 2-4 menyebut judul, penulis, dan hasil yang dibuat. |
| 5-9 | import os sampai import m3_umum as U | Panggil perkakas: os (folder), processing (alat QGIS), QgsRasterLayer dan QgsProject (layer dan proyek), gdal (raster), dan kotak perkakas kita dengan nama pendek U. |
| 11 | os.makedirs(os.path.join(U.HASIL, "ndvi"), exist_ok=True) | Buat subfolder ndvi di dalam folder hasil. os.path.join menyambung jalur dengan pemisah yang benar. |
| 12 | daftar = U.daftar_citra() | Ambil 24 tuple dari kotak perkakas: tanggal, jalur refl, jalur SCL. |
| 13 | keluaran = [] | Siapkan daftar kosong untuk mencatat jalur tiap NDVI yang dibuat. |
| 14 | for tgl, pr, ps in daftar: | Ulangi 24 kali. Tiap putaran, satu tuple dibongkar ke tiga kotak: tgl, pr, dan ps. Kotak ps tidak dipakai di skrip ini. |
| 15 | nama = "S2_" + tgl.strftime("%Y%m%d") + "_refl" | Susun nama layer, misalnya S2_20240105_refl. strftime mengubah tanggal menjadi teks menurut pola: tahun, bulan, hari. |
| 16 | lyr = QgsRasterLayer(pr, nama) | Buka berkas refl sebagai layer raster bernama nama. |
| 17 | QgsProject.instance().addMapLayer(lyr, False) | Daftarkan layer ke proyek supaya alat QGIS bisa menemukannya, tetapi False berarti tidak ditampilkan di kanvas. |
| 18 | out = os.path.join(..., "NDVI_%s.tif" % ...) | Susun jalur keluaran, misalnya .../ndvi/NDVI_20240105.tif. Tanda %s diganti oleh tanggal (Bab 9). |
| 19 | ekspresi = '("%s@4" - "%s@3") / ...' % (...) | Susun rumus NDVI untuk kalkulator raster. nama@4 berarti band 4 (inframerah dekat, B08), nama@3 berarti band 3 (merah, B04). Empat %s diisi nama layer yang sama. |
| 20 | processing.run("native:rastercalc", {...}) | Jalankan alat kalkulator raster dengan tiga isian: LAYERS (layer yang dipakai), EXPRESSION (rumus), OUTPUT (berkas hasil). |
| 21 | keluaran.append(out) | Catat jalur hasil di daftar. |
| 24 | stack = os.path.join(U.HASIL, "NDVI_deret.tif") | Tentukan jalur tumpukan akhir. |
| 25 | processing.run("gdal:merge", {...}) | Jalankan alat Merge. INPUT berisi daftar 24 berkas. SEPARATE: True berarti tiap berkas menjadi band tersendiri, bukan ditempel berdampingan. DATA_TYPE: 5 memilih Float32 (desimal 32 bit). |
| 27 | ds = gdal.Open(stack, gdal.GA_Update) | Buka tumpukan untuk diubah, bukan hanya dibaca. |
| 28 | for i, (tgl, _, _) in enumerate(daftar): | Ulangi untuk tiap tanggal. enumerate memberi nomor urut i (mulai 0). Tanda _ berarti nilai itu sengaja diabaikan. |
| 29 | ds.GetRasterBand(i + 1).SetDescription(tgl.isoformat()) | Beri band nomor i + 1 (nomor band di GDAL mulai dari 1) nama berupa tanggal, misalnya 2024-01-05. |
| 30 | ds = None | Lepas berkas. Di GDAL, inilah cara menutup dan menyimpan perubahan. |
| 31-32 | lyr = QgsRasterLayer(stack, ...) dan print(...) | Buka tumpukan sebagai layer, lalu cetak jalur, apakah valid, dan jumlah band. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Tumpukan: D:/Latihan_M3/hasil\NDVI_deret.tif valid: True band: 24Dari hasil ini Anda tahu: tumpukan terbaca (valid: True) dan memuat 24 band. Folder ndvi kini berisi 24 berkas NDVI, satu per tanggal.
Bagian yang boleh diubah.
- Baris 19, nomor band. Ganti
@3menjadi@6di seluruh baris untuk menghitung NBR (inframerah dekat dan SWIR2) alih-alih NDVI. Dengan angka 6, rata-rata band pertama berubah dari0.726menjadi0.586, jadi indeksnya memang lain. - Baris 25,
DATA_TYPE. Angka 5 berarti Float32. Saya memeriksanya dengan bantuan alat (qgis_process help gdal:merge) dan dengangdalinfopada hasilnya. Angka lain memberi tipe lain, dan desimal NDVI bisa terpotong. - Baris 11 dan 18, nama folder dan berkas. Ganti bila Anda ingin menyimpan di tempat lain.
Jebakan.
- Nama layer harus sama persis dengan nama di rumus. Saya mencoba mengganti satu nama di baris 19 dengan nama lain. Hasilnya galat
QgsProcessingException: Error occurred while performing calculation.Pesannya tidak menyebut nama mana yang salah, jadi periksa ejaan di baris 15 dan 19. import processinghanya berjalan sendiri di Konsol QGIS. Saya mencobanya dari terminal biasa tanpa persiapan: layar menampilkanModuleNotFoundError: No module named 'processing'. Nyalakan QGIS tanpa jendela lebih dulu (Bab 3).- Menjalankan ulang menimpa berkas lama. Tidak ada pertanyaan "yakin?". Pindahkan hasil lama bila ingin menyimpannya.
- Kotak
pstidak dipakai. Python tidak protes terhadap kotak yang menganggur. Itu tanda skrip ini hanya memerlukan dua dari tiga isi tuple.
Latihan variasi.
- Hitung NBR (inframerah dekat dan SWIR2) alih-alih NDVI.
- Cetak juga nilai rata-rata band pertama tumpukan, untuk membandingkan dua indeks.
Contoh jawaban, hanya bagian yang berubah:
ekspresi = '("%s@4" - "%s@6") / ("%s@4" + "%s@6")' % (nama, nama, nama, nama) # band 6 = B12dan satu baris tambahan di akhir skrip:
print("rata-rata band 1:", round(float(gdal.Open(stack).ReadAsArray()[0].mean()), 3))Saya menjalankan versi NDVI dan versi NBR pada salinan data. Layar menampilkan rata-rata band 1: 0.726 untuk NDVI dan rata-rata band 1: 0.586 untuk NBR.
Skrip 26.2: Menggambar profil waktu empat titik #
Berkas 1_2_profil_waktu.py. Di dalam berkasnya tertulis "SKRIP 1.2".
Tujuan. Menggambar grafik NDVI sepanjang 24 tanggal untuk empat titik (hutan alam, sawah, bukaan, bekas bakar), mencetak ringkasannya, dan menyimpan grafik sebagai gambar.
Bahan. Hasil Skrip 26.1 (NDVI_deret.tif), m3_umum.py, dan matplotlib (perkakas membuat grafik, dibahas di Bab 12). Jalankan dari Konsol atau terminal.
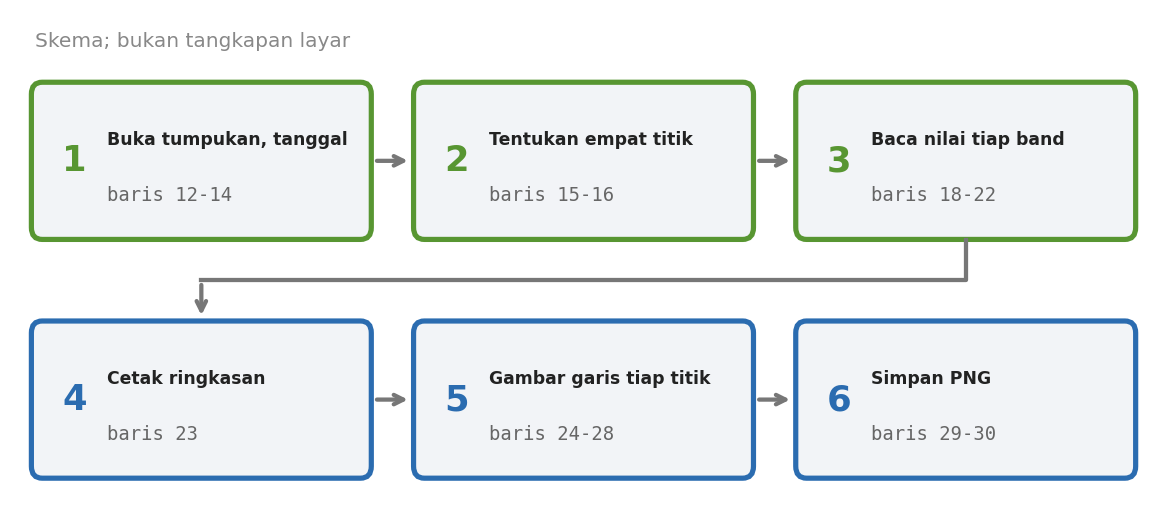
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 1.2: Profil waktu satu titik (NDVI sepanjang 24 tanggal) dari tumpukan NDVI_deret.tif
# Penulis: Badar Mubarok Yogaswara
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from qgis.core import QgsRasterLayer, QgsPointXY
import m3_umum as U

lyr = QgsRasterLayer(os.path.join(U.HASIL, "NDVI_deret.tif"), "NDVI_deret")
dp = lyr.dataProvider()
tanggal = [t for t, _, _ in U.daftar_citra()]
titik = {"Hutan alam": (312100, 9996100), "Sawah (Beta)": (312365, 9996025),
         "Bukaan (Gamma)": (312100, 9996330), "Bekas bakar (Beta)": (312270, 9996125)}
fig, ax = plt.subplots(figsize=(9, 4))
for nama, (x, y) in titik.items():
    nilai = []
    for b in range(1, lyr.bandCount() + 1):
        v, ok = dp.sample(QgsPointXY(x, y), b)
        nilai.append(v if ok else np.nan)
    print("%-20s NDVI awal %.2f, minimum %.2f, akhir %.2f" % (nama, nilai[0], np.nanmin(nilai), nilai[-1]))
    ax.plot(tanggal, nilai, marker="o", ms=3, label=nama)
ax.set_ylabel("NDVI")
ax.legend(fontsize=8)
ax.grid(alpha=0.3)
fig.autofmt_xdate()
fig.savefig(os.path.join(U.HASIL, "profil_waktu.png"), dpi=130, bbox_inches="tight")
print("Grafik tersimpan di", os.path.join(U.HASIL, "profil_waktu.png"))
Penjelasan baris demi baris. Hanya hal baru yang dijelaskan. Perkakas yang sudah dikenal di Skrip 26.1 tidak diulang.
| Baris | Tulisan | Artinya |
|---|---|---|
| 4-10 | import os sampai import m3_umum as U | Panggil perkakas. numpy diberi nama pendek np. matplotlib.pyplot diberi nama pendek plt. |
| 6-8 | import matplotlib lalu matplotlib.use("Agg") | Pilih mode Agg: matplotlib menggambar di memori dan menyimpan ke berkas, tanpa membuka jendela. Perintah ini harus ditulis sebelum import matplotlib.pyplot. |
| 9 | from qgis.core import QgsRasterLayer, QgsPointXY | QgsPointXY adalah satu titik dengan koordinat x dan y. |
| 12 | lyr = QgsRasterLayer(...) | Buka NDVI_deret.tif sebagai layer raster. |
| 13 | dp = lyr.dataProvider() | Ambil penyedia data: bagian layer yang bisa membaca nilai piksel. |
| 14 | tanggal = [t for t, _, _ in U.daftar_citra()] | Kumpulkan hanya tanggalnya, dari 24 tuple. Tanda _ mengabaikan dua isi lain (Bab 6). |
| 15-16 | titik = {...} | Kamus: nama titik menjadi pasangan koordinat (x, y). Koordinat memakai satuan meter pada sistem UTM zona 49 selatan (EPSG:32749). |
| 17 | fig, ax = plt.subplots(figsize=(9, 4)) | Siapkan kanvas gambar (fig) dan satu bidang grafik (ax), berukuran 9 kali 4 inci. |
| 18 | for nama, (x, y) in titik.items(): | Ulangi untuk tiap titik. .items() memberi pasangan nama dan koordinat, dan koordinat langsung dibongkar menjadi x dan y. |
| 19 | nilai = [] | Daftar kosong untuk NDVI titik ini. |
| 20 | for b in range(1, lyr.bandCount() + 1): | Ulangi untuk band nomor 1 sampai 24. range berhenti sebelum angka akhir, maka ditambah 1. |
| 21 | v, ok = dp.sample(QgsPointXY(x, y), b) | Baca nilai piksel di titik itu pada band b. Jawabannya dua benda: nilai v dan penanda ok (benar bila titik ada di dalam raster). |
| 22 | nilai.append(v if ok else np.nan) | Bila ok benar, simpan v. Bila tidak, simpan nan (tanda "bukan angka"). |
| 23 | print("%-20s NDVI awal %.2f, ..." % (...)) | Cetak ringkasan: nilai awal, minimum, dan akhir. %-20s memberi nama selebar 20 huruf, rata kiri. %.2f berarti dua desimal. np.nanmin mencari nilai terkecil dengan mengabaikan nan. |
| 24 | ax.plot(tanggal, nilai, marker="o", ms=3, label=nama) | Gambar garis dengan bulatan kecil di tiap titik data. label dipakai untuk legenda. |
| 25-28 | ax.set_ylabel(...) dan seterusnya | Beri judul sumbu, legenda, garis bantu, dan miringkan tulisan tanggal supaya tidak bertumpuk. |
| 29 | fig.savefig(..., dpi=130, bbox_inches="tight") | Simpan gambar ke profil_waktu.png. dpi mengatur ketajaman. bbox_inches="tight" memangkas pinggiran kosong. |
| 30 | print("Grafik tersimpan di", ...) | Beri tahu lokasi gambar. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Hutan alam           NDVI awal 0.87, minimum 0.00, akhir 0.88
Sawah (Beta)         NDVI awal 0.74, minimum 0.06, akhir 0.72
Bukaan (Gamma)       NDVI awal 0.86, minimum 0.03, akhir 0.04
Bekas bakar (Beta)   NDVI awal 0.87, minimum 0.01, akhir 0.01
Grafik tersimpan di D:/Latihan_M3/hasil\profil_waktu.png
Berkas profil_waktu.png berisi grafik berikut. Ini keluaran sungguhan skrip, bukan skema.
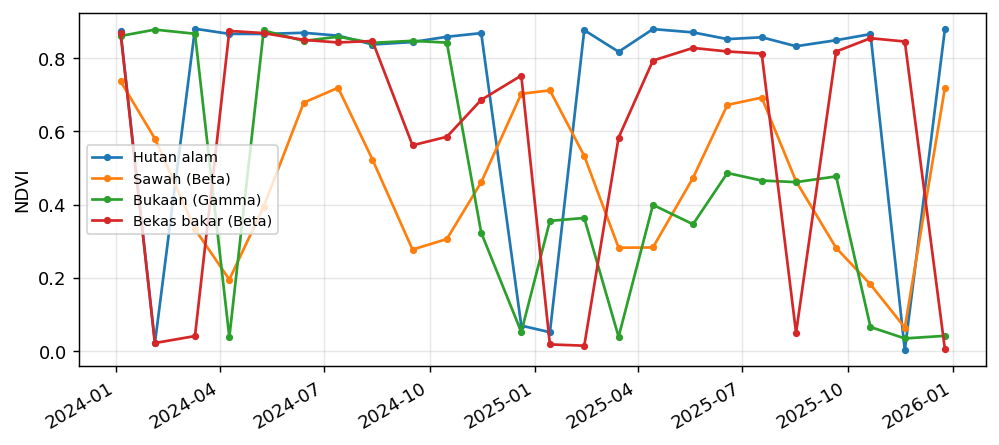
Perhatikan garis biru, hutan alam. Ia hampir datar di sekitar 0,85, lalu jatuh ke nol pada beberapa tanggal. Hutannya tidak hilang. Pada tanggal itu, awan menutupi piksel. Itulah mengapa kelompok B ada.
Bagian yang boleh diubah.
- Baris 15-16, koordinat titik. Ganti pasangan angka dengan titik Anda sendiri, dalam sistem koordinat yang sama dengan raster. Tambah titik baru dengan menambah satu pasangan nama dan koordinat di kamus.
- Baris 17,
figsize. Ubah ukuran gambar.(12, 5)membuat grafik lebih lebar. - Baris 29,
dpi. Naikkan menjadi200untuk gambar yang lebih tajam.
Jebakan.
- Titik di luar raster tidak menghasilkan galat. Saya mengganti koordinat hutan alam menjadi
(0, 0). Layar menampilkanHutan alam NDVI awal nan, minimum nan, akhir nandan peringatanRuntimeWarning: All-NaN axis encountered. Skrip tetap selesai. Selalu baca angka ringkasan, bukan hanya gambarnya. - Skrip 26.1 harus sudah dijalankan. Saya menjalankan skrip ini di folder hasil yang kosong. Layar menampilkan
nanuntuk titik pertama, lalu berhenti denganValueError: x and y must have same first dimension, but have shapes (24,) and (1,). Artinya tumpukan tidak ditemukan. - Urutan baris 6-8 sengaja begitu. Aturan matplotlib: pilih mode lebih dulu, baru panggil
pyplot. Jangan memindahkan baris 7 ke bawah baris 8. matplotlibharus terpasang di Python QGIS. Skrip tidak memeriksanya (Bab 12). Di QGIS 4.0.2 milik saya,matplotlibsudah ada.
Latihan variasi.
- Tambahkan titik Air di koordinat
(312295, 9996195). - Pastikan hasilnya masuk ke ringkasan dan grafik.
Contoh jawaban, hanya bagian yang berubah (baris 15-16):
titik = {"Hutan alam": (312100, 9996100), "Sawah (Beta)": (312365, 9996025),
         "Bukaan (Gamma)": (312100, 9996330), "Bekas bakar (Beta)": (312270, 9996125),
         "Air": (312295, 9996195)}
Layar menampilkan satu baris tambahan: Air NDVI awal -0.31, minimum -0.52, akhir 0.04. NDVI air negatif, tanda khas air.
Skrip 26.3: Memberi tanggal agar bisa diputar seperti film #
Berkas 1_3_atur_waktu.py. Di dalam berkasnya tertulis "SKRIP 1.3".
Tujuan. Memberi rentang tanggal pada tiap band NDVI_deret.tif supaya QGIS bisa memutarnya di panel Temporal Controller.
Bahan. Hasil Skrip 26.1 dan m3_umum.py. Skrip ini hanya bermakna di dalam proyek QGIS yang terbuka, jadi jalankan dari Konsol.
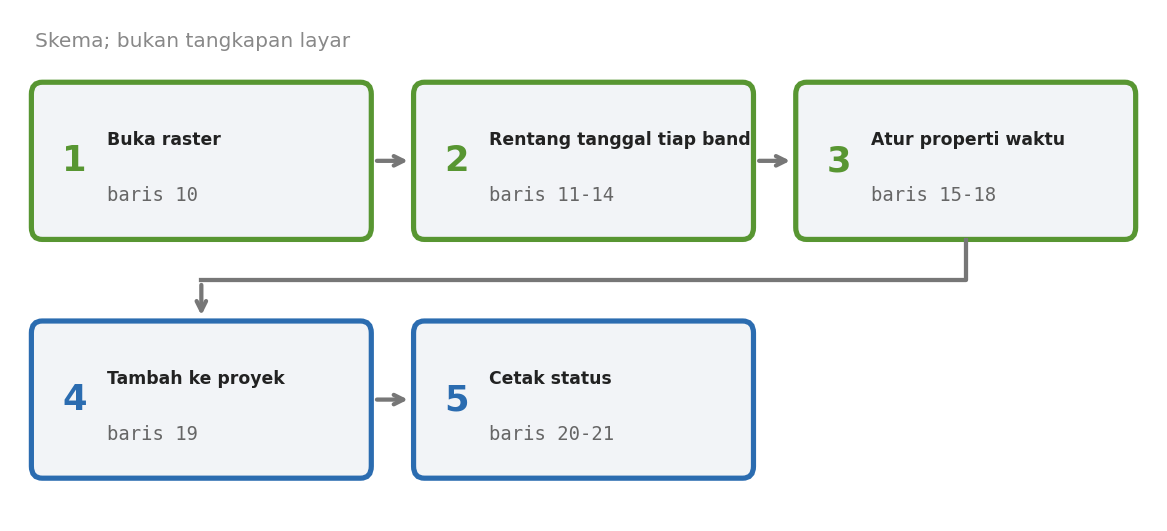
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 1.3: Beri tanggal pada tiap band NDVI_deret.tif agar bisa dimainkan di Temporal Controller
# Penulis: Badar Mubarok Yogaswara
# Mode yang dipakai: Fixed Time Range Per Band (tiap band punya rentang tanggal sendiri).
import os
from qgis.core import QgsRasterLayer, QgsProject, QgsDateTimeRange, Qgis
from qgis.PyQt.QtCore import QDateTime, QDate, QTime
import m3_umum as U

lyr = QgsRasterLayer(os.path.join(U.HASIL, "NDVI_deret.tif"), "NDVI_deret")
rentang = {}
for b, (tgl, _, _) in enumerate(U.daftar_citra(), start=1):
    awal = QDateTime(QDate(tgl.year, tgl.month, tgl.day), QTime(0, 0, 0))
    rentang[b] = QgsDateTimeRange(awal, awal.addDays(1))          # satu hari untuk tiap band
tp = lyr.temporalProperties()
tp.setMode(Qgis.RasterTemporalMode.FixedRangePerBand)
tp.setFixedRangePerBand(rentang)
tp.setIsActive(True)
QgsProject.instance().addMapLayer(lyr)
print("Aktif:", tp.isActive(), "| mode:", tp.mode(), "| band bertanggal:", len(tp.fixedRangePerBand()))
print("Band 9 =", tp.fixedRangePerBand()[9].begin().toString("yyyy-MM-dd"))
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 4 | # Mode yang dipakai: ... | Komentar: tiap band mendapat rentang tanggalnya sendiri. |
| 6 | from qgis.core import ..., QgsDateTimeRange, Qgis | QgsDateTimeRange adalah sepasang tanggal-jam: awal dan akhir. Qgis menyimpan daftar pilihan resmi QGIS. |
| 7 | from qgis.PyQt.QtCore import QDateTime, QDate, QTime | Tiga jenis objek tanggal milik Qt (pustaka di balik antarmuka QGIS): tanggal-jam, tanggal, dan jam. |
| 10 | lyr = QgsRasterLayer(...) | Buka tumpukan sebagai layer. |
| 11 | rentang = {} | Kamus kosong. Kuncinya nomor band, isinya rentang tanggal. |
| 12 | for b, (tgl, _, _) in enumerate(U.daftar_citra(), start=1): | Ulangi untuk tiap tanggal. start=1 membuat nomor urut b dimulai dari 1, sesuai nomor band. |
| 13 | awal = QDateTime(QDate(tgl.year, ...), QTime(0, 0, 0)) | Bentuk objek tanggal-jam: tanggal citra pada pukul 00.00. |
| 14 | rentang[b] = QgsDateTimeRange(awal, awal.addDays(1)) | Simpan rentang satu hari: dari awal sampai awal ditambah satu hari. |
| 15 | tp = lyr.temporalProperties() | Ambil pengaturan waktu milik layer. |
| 16 | tp.setMode(Qgis.RasterTemporalMode.FixedRangePerBand) | Pilih mode "rentang tetap per band". Nama modenya diambil dari daftar resmi, bukan angka. |
| 17 | tp.setFixedRangePerBand(rentang) | Pasang kamus rentang ke layer. |
| 18 | tp.setIsActive(True) | Aktifkan fitur waktu pada layer. |
| 19 | QgsProject.instance().addMapLayer(lyr) | Tambahkan layer ke proyek, kali ini ditampilkan. |
| 20 | print("Aktif:", tp.isActive(), ...) | Cetak status: aktif atau tidak, mode, dan jumlah band yang punya tanggal. |
| 21 | print("Band 9 =", ...[9].begin().toString("yyyy-MM-dd")) | Cetak tanggal awal rentang band ke-9. Pola yyyy-MM-dd berarti tahun-bulan-hari. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Aktif: True | mode: 3 | band bertanggal: 24
Band 9 = 2024-09-16
Band 9 bertanggal 2024-09-16, sesuai urutan di Daftar_Citra.csv. Angka mode: 3 adalah nomor mode FixedRangePerBand. Saya memeriksanya dengan int(Qgis.RasterTemporalMode.FixedRangePerBand), yang bernilai 3. Memutar layer di panel Temporal Controller saya tandai [CEK]: pengujian saya berjalan tanpa jendela QGIS.
Bagian yang boleh diubah.
- Baris 14,
addDays(1). Panjang rentang tiap band. Saya mengganti menjadiaddDays(10), dan tanggal akhir band 9 berubah dari2024-09-17menjadi2024-09-26. Rentang yang lebih panjang membuat band bertahan lebih lama saat film diputar. - Baris 10, nama layer. Ubah bila Anda memakai tumpukan lain.
Jebakan.
- Pengaturan hidup di proyek, bukan di berkas. Tanggal ini tidak tertulis ke
NDVI_deret.tif. Simpan proyek QGIS (Bab 14) bila ingin menyimpannya. - Menjalankan dua kali menambah layer kembar. Saya mengujinya: setelah dua kali jalan, proyek berisi dua layer bernama
NDVI_deret. Hapus yang lama sebelum mengulang. - Nama
Qgis.RasterTemporalModemengikuti gaya QGIS baru. Saya mengujinya hanya di QGIS 4.0.2. Di versi lain, nama ini mungkin berbeda [CEK].
Latihan variasi.
- Cetak juga tanggal akhir band ke-9.
- Buat tiap band berlaku 10 hari, lalu cetak tanggal akhir band ke-9 lagi.
Contoh jawaban, tambahkan di akhir skrip:
print("Band 9 berakhir:", tp.fixedRangePerBand()[9].end().toString("yyyy-MM-dd"))Dengan addDays(1), layar menampilkan Band 9 berakhir: 2024-09-17. Setelah baris 14 diganti menjadi addDays(10), layar menampilkan Band 9 berakhir: 2024-09-26.
Kelompok B: Membersihkan awan #
Konsep: tiga cara menyingkirkan awan #
Awan itu seperti kaca buram di depan kamera: apa pun yang tampak di baliknya bukan permukaan bumi. Anda punya tiga cara. Pertama, membuang piksel yang buram, memakai peta penanda. Kedua, menggabungkan beberapa tanggal menjadi satu citra bersih. Ketiga, menambal lubangnya dengan nilai dari tanggal sebelum dan sesudah. Ketiganya bisa dipakai bersama.
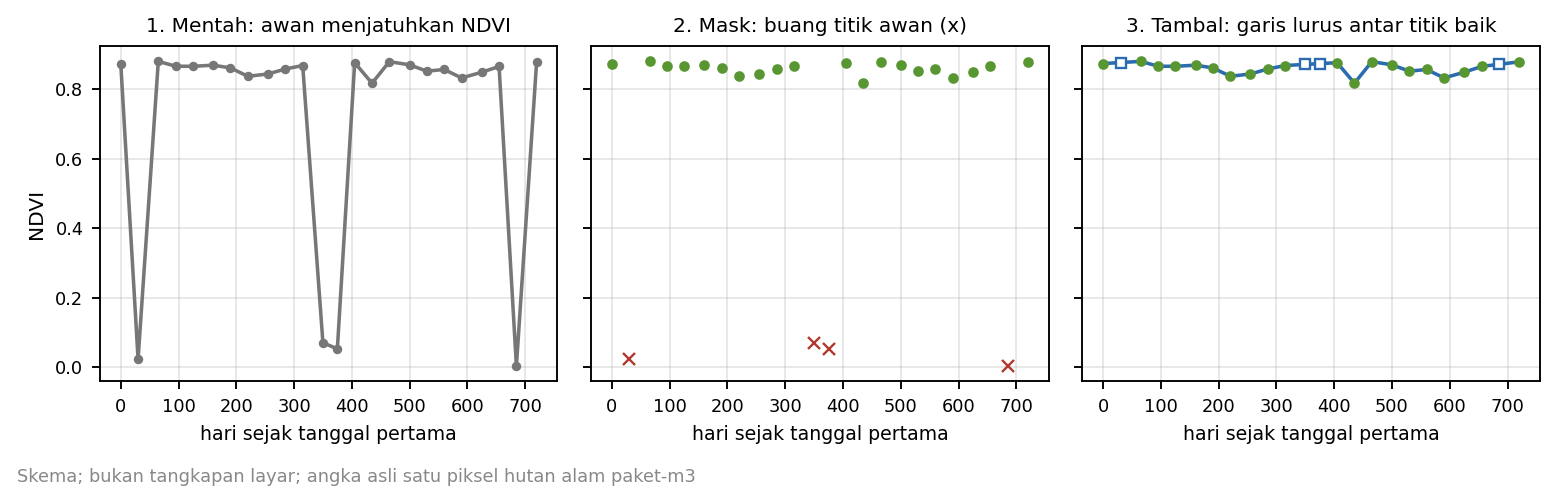
Lima istilah yang perlu Anda kenal sekarang:
- Mask: peta penanda piksel mana yang dipakai dan mana yang dibuang.
- NoData: nilai khusus yang berarti "piksel ini kosong". Piksel kosong tidak ikut dihitung.
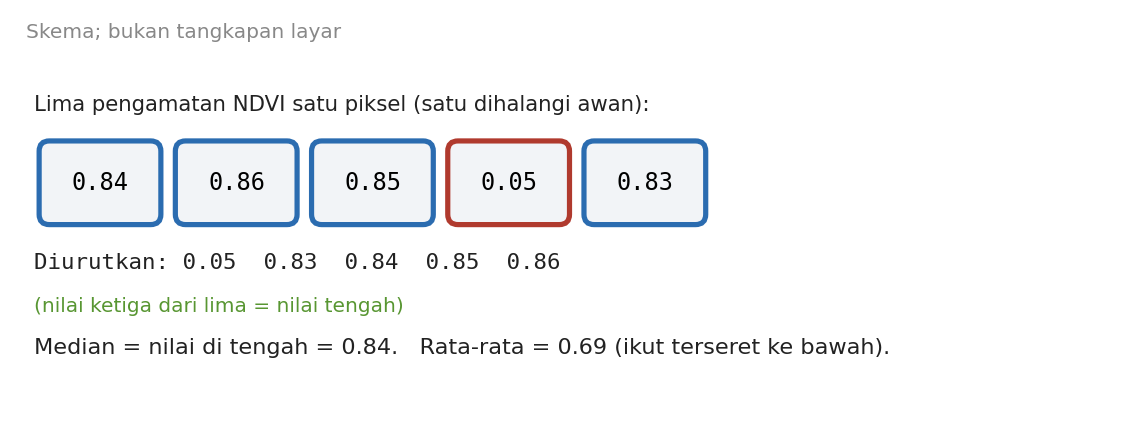
- Median: nilai tengah bila semua nilai diurutkan. Lawan kata rata-rata.
- Komposit median: citra baru yang tiap pikselnya berisi median dari beberapa tanggal.
- Interpolasi linear: menarik garis lurus antara dua nilai yang diketahui, untuk menebak nilai di antaranya.
Median lebih tahan banting daripada rata-rata. Satu nilai ekstrem, misalnya awan yang lolos dari penyaringan, tidak ikut menarik hasilnya.
Skrip 26.4: Membuang awan dengan band SCL #
Berkas 2_1_masker_awan.py. Di dalam berkasnya tertulis "SKRIP 2.1".
Tujuan. Membuang piksel berawan, berbayang awan, atau berkabut tipis dari tiap NDVI memakai band SCL. Piksel buruk menjadi NoData.
Bahan. Hasil Skrip 26.1 (folder ndvi), berkas _SCL.tif dari paket data, dan m3_umum.py. Jalankan dari Konsol atau terminal.
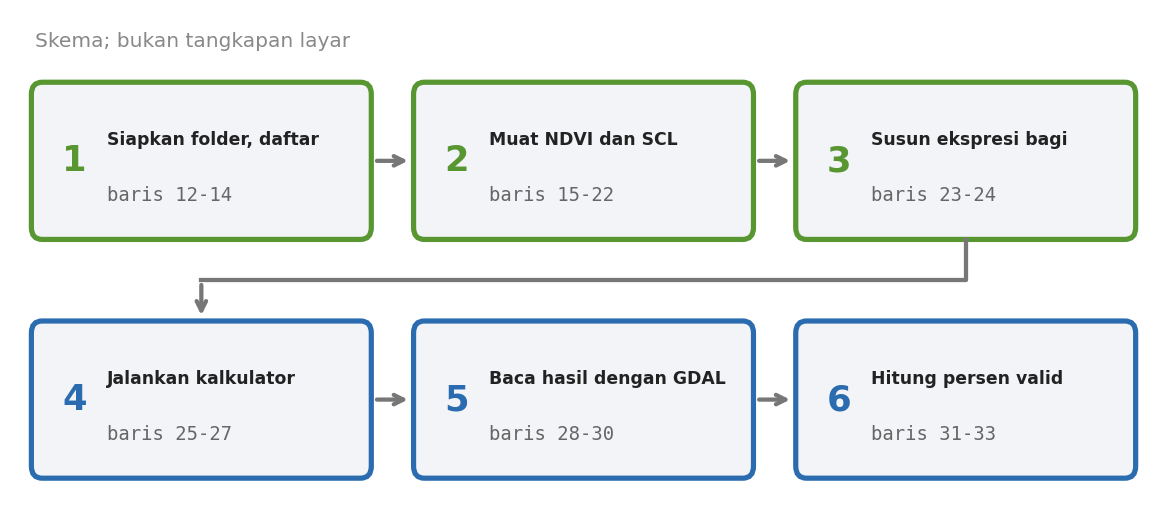
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 2.1: Buang awan dan bayangan memakai band SCL, per tanggal, dengan Raster Calculator
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 1.1 sudah dijalankan (hasil/ndvi/NDVI_*.tif ada). Piksel buruk menjadi NoData.
import os
import processing
from qgis.core import QgsRasterLayer, QgsProject
from osgeo import gdal
import numpy as np
import m3_umum as U

os.makedirs(os.path.join(U.HASIL, "ndvi_bersih"), exist_ok=True)
daftar = U.daftar_citra()
keluaran = []
for tgl, pr, ps in daftar:
    k = tgl.strftime("%Y%m%d")
    n_ndvi, n_scl = "NDVI_" + k, "SCL_" + k
    l_ndvi = QgsRasterLayer(os.path.join(U.HASIL, "ndvi", "NDVI_%s.tif" % k), n_ndvi)
    l_scl = QgsRasterLayer(ps, n_scl)
    if not l_ndvi.isValid() or not l_scl.isValid():
        raise SystemExit("Layer tidak terbaca (jalankan Skrip 1.1 dulu): " + n_ndvi)
    QgsProject.instance().addMapLayers([l_ndvi, l_scl], False)
    # piksel baik: SCL 4 (vegetasi), 5 (bukan vegetasi), 6 (air). Nilai baik dibagi 1; nilai buruk dibagi 0 -> NoData
    ekspresi = '"%s@1" / (("%s@1" = 4) OR ("%s@1" = 5) OR ("%s@1" = 6))' % (n_ndvi, n_scl, n_scl, n_scl)
    out = os.path.join(U.HASIL, "ndvi_bersih", "NDVI_bersih_%s.tif" % k)
    processing.run("native:rastercalc", {"LAYERS": [l_ndvi, l_scl], "EXPRESSION": ekspresi, "OUTPUT": out})
    keluaran.append(out)
    a = gdal.Open(out)
    arr = a.GetRasterBand(1).ReadAsArray()
    nd = a.GetRasterBand(1).GetNoDataValue()
    valid = np.isfinite(arr) if nd is None else (arr != nd) & np.isfinite(arr)
    print(tgl, "piksel valid: %5.1f%%" % (100 * valid.mean()))
print("selesai,", len(keluaran), "berkas")
Penjelasan baris demi baris. Hanya hal baru yang diuraikan lebih panjang.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-10 | import os sampai import m3_umum as U | Perkakas yang sama dengan Skrip 26.1, ditambah numpy (nama pendek np). |
| 12 | os.makedirs(...ndvi_bersih...) | Buat folder keluaran ndvi_bersih. |
| 13-14 | daftar = ... dan keluaran = [] | Ambil 24 tuple tanggal, dan siapkan daftar penampung. |
| 15 | for tgl, pr, ps in daftar: | Ulangi per tanggal. Kali ini ps (jalur SCL) dipakai, dan pr tidak. |
| 16 | k = tgl.strftime("%Y%m%d") | Kode tanggal, misalnya 20240105. |
| 17 | n_ndvi, n_scl = "NDVI_" + k, "SCL_" + k | Penugasan ganda: dua kotak diisi sekaligus dalam satu baris. Isinya nama layer NDVI dan nama layer SCL. |
| 18-19 | l_ndvi = ... dan l_scl = ... | Buka NDVI hasil Skrip 26.1 dan berkas SCL sebagai dua layer. |
| 20-21 | if not l_ndvi.isValid() or not l_scl.isValid(): lalu raise SystemExit(...) | Pengaman. isValid() menjawab apakah layer berhasil dibuka (Bab 10). Kata or berarti satu layer gagal sudah cukup. Bila gagal, SystemExit menghentikan skrip saat itu juga dan mencetak pesan beserta nama layer yang bermasalah. Tanpa baris ini, skrip jalan terus dan menulis berkas sampah. |
| 22 | QgsProject.instance().addMapLayers([l_ndvi, l_scl], False) | Daftarkan dua layer sekaligus (dalam bentuk daftar) ke proyek, tanpa ditampilkan. |
| 24 | ekspresi = '"%s@1" / (("%s@1" = 4) OR ... )' % (...) | Rumus inti. Bagian dalam kurung bernilai 1 bila kode SCL adalah 4, 5, atau 6, dan 0 bila bukan. NDVI dibagi 1 tetap NDVI. NDVI dibagi 0 tidak terdefinisi, dan kalkulator raster mengisinya sebagai NoData. |
| 25 | out = os.path.join(...) | Jalur keluaran per tanggal. |
| 26 | processing.run("native:rastercalc", {...}) | Jalankan kalkulator raster dengan dua layer sebagai masukan. |
| 27 | keluaran.append(out) | Catat hasilnya. |
| 28 | a = gdal.Open(out) | Buka hasil dengan GDAL untuk diperiksa. |
| 29 | arr = a.GetRasterBand(1).ReadAsArray() | Baca isi band 1 sebagai larik NumPy. |
| 30 | nd = a.GetRasterBand(1).GetNoDataValue() | Ambil nilai NoData yang dipakai berkas itu. |
| 31 | valid = np.isfinite(arr) if nd is None else (arr != nd) & np.isfinite(arr) | Susun larik benar atau salah: benar bila piksel punya angka. Bila berkas tidak punya NoData, cukup isfinite. Bila punya, piksel juga harus tidak sama dengan nd. Tanda & berarti "dan", berlaku pada seluruh larik sekaligus. |
| 32 | print(tgl, "piksel valid: %5.1f%%" % (100 * valid.mean())) | valid.mean() adalah pecahan piksel yang benar. Dikali 100 menjadi persen. %5.1f berarti lebar lima karakter, satu desimal. %% mencetak tanda persen. |
| 33 | print("selesai,", len(keluaran), "berkas") | Cetak ringkasan akhir. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
2024-01-05 piksel valid:  93.5%
2024-02-04 piksel valid:  61.5%
2024-03-10 piksel valid:  41.6%
2024-04-09 piksel valid:  70.3%
2024-05-09 piksel valid:  81.3%
2024-06-13 piksel valid: 100.0%
2024-07-13 piksel valid: 100.0%
2024-08-12 piksel valid:  93.2%
2024-09-16 piksel valid:  66.9%
2024-10-16 piksel valid:  90.5%
2024-11-15 piksel valid:  75.8%
2024-12-20 piksel valid:  52.1%
2025-01-14 piksel valid:  46.1%
2025-02-13 piksel valid:  67.4%
2025-03-15 piksel valid:  51.0%
2025-04-14 piksel valid:  64.3%
2025-05-19 piksel valid:  88.6%
2025-06-18 piksel valid: 100.0%
2025-07-18 piksel valid:  93.2%
2025-08-17 piksel valid:  83.3%
2025-09-21 piksel valid: 100.0%
2025-10-21 piksel valid:  75.6%
2025-11-20 piksel valid:  57.9%
2025-12-25 piksel valid:  39.5%
selesai, 24 berkas
Bacalah angka-angkanya. Pada musim kemarau (Juni dan Juli 2024), 100 persen piksel valid. Pada Desember 2025, hanya 39,5 persen. Tiap tanggal punya porsi awan sendiri, dan itulah yang akan Anda atasi di dua skrip berikutnya.
Bagian yang boleh diubah.
- Baris 24, kode SCL. Hapus bagian
OR ("%s@1" = 6)untuk membuang piksel air, dan kurangi satun_scldi tuple isian. Saya mencobanya: pada 5 Januari 2024, persen valid turun dari93.5menjadi89.4. - Baris 12 dan 25, nama folder dan berkas. Bebas Anda ganti.
- Baris 21, teks pesan. Bebas Anda ubah, misalnya dengan menyebut folder yang Anda pakai. Pesan itu hanya tampil bila ada layer yang gagal dibuka.
Jebakan.
- Pengaman di baris 20-21 menjaga urutan kerja. Saya menjalankan skrip di folder hasil yang kosong, sebelum Skrip 26.1. Skrip langsung berhenti dengan pesan
Layer tidak terbaca (jalankan Skrip 1.1 dulu): NDVI_20240105dan tidak menulis satu berkas pun (hanya folder kosongndvi_bersihyang sudah sempat dibuat). Di berkasnya, Skrip 26.1 tertulis "Skrip 1.1". Tanpa dua baris itu, skrip tetap selesai tanpa galat dan menulis 24 berkas sampah. Pengaman ini hanya memeriksa bahwa layer bisa dibuka, bukan bahwa isinya benar. Tetap cocokkan angka keluaran dengan angka yang seharusnya. - Trik "bagi nol menjadi NoData" bergantung pada kalkulator raster QGIS. Saya memeriksanya pada 10 Maret 2024: ada 935 piksel dengan kode SCL buruk, dan tepat 935 piksel NoData di hasil, di posisi yang sama. Pada QGIS 4.0.2 trik ini bekerja. Pada versi lain, periksa dulu [CEK].
- Nilai NoData bukan
-9999. Berkas hasil memakai bilangan terkecil Float32 (sekitar-3.4e+38). Karena itu skrip mengambilnddari berkas, tidak menebaknya. - SCL adalah tebakan otomatis. Tepi awan yang sangat tipis bisa lolos sebagai "bersih". Itu sebabnya ada komposit median di skrip berikutnya.
Latihan variasi.
- Hanya terima piksel vegetasi dan bukan vegetasi (kode 4 dan 5). Air dibuang.
- Lihat persen valid pada tiga tanggal pertama.
Contoh jawaban, hanya baris yang berubah (baris 24):
ekspresi = '"%s@1" / (("%s@1" = 4) OR ("%s@1" = 5))' % (n_ndvi, n_scl, n_scl)Layar menampilkan tiga tanggal pertama: 2024-01-05 piksel valid: 89.4%, 2024-02-04 piksel valid: 59.7%, 2024-03-10 piksel valid: 41.2%. Semuanya lebih rendah daripada hasil asli (93,5; 61,5; 41,6), karena piksel air ikut dibuang.
Skrip 26.5: Komposit median dari beberapa tanggal #
Berkas 2_2_komposit_median.py. Di dalam berkasnya tertulis "SKRIP 2.2".
Tujuan. Membuat citra komposit median NDVI dan peta jumlah pengamatan valid untuk tiga periode: sebelum, kemarau 2024, dan sesudah.
Bahan. Hasil Skrip 26.4 (folder ndvi_bersih) dan m3_umum.py. Jalankan dari Konsol atau terminal.
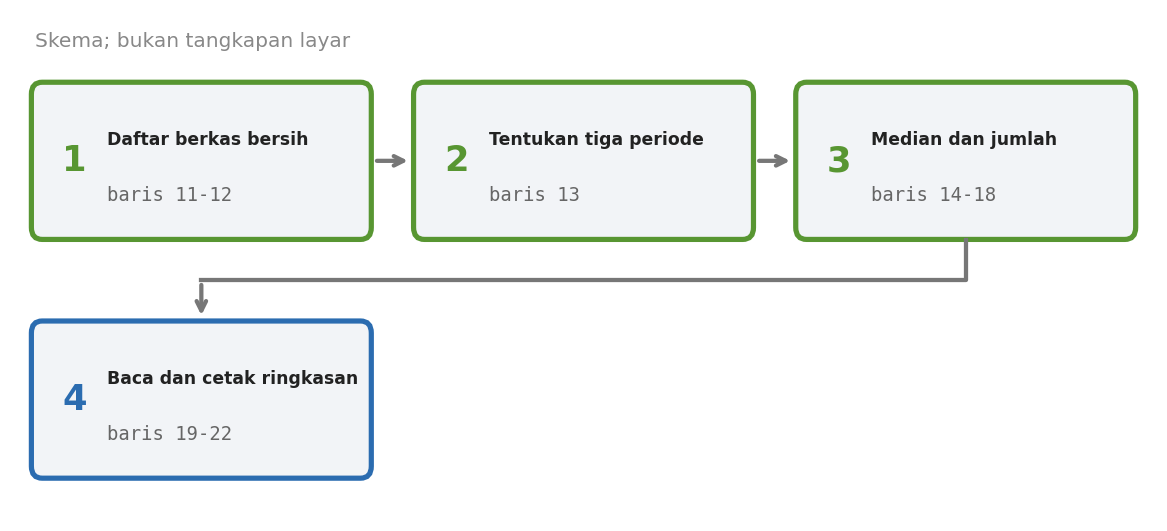
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 2.2: Komposit median dan jumlah pengamatan valid dengan Cell Statistics
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 2.1 sudah dijalankan.
import os
import numpy as np
import processing
from osgeo import gdal
import m3_umum as U

daftar = U.daftar_citra()
berkas = [os.path.join(U.HASIL, "ndvi_bersih", "NDVI_bersih_%s.tif" % t.strftime("%Y%m%d")) for t, _, _ in daftar]
periode = {"sebelum": (0, 8), "kemarau2024": (5, 9), "sesudah": (20, 24)}   # indeks [awal, akhir) di daftar tanggal
for nama, (a, b) in periode.items():
    for kode, stat in (("median", 3), ("jumlah", 1)):
        out = os.path.join(U.HASIL, "komposit_ndvi_%s_%s.tif" % (nama, kode))
        processing.run("native:cellstatistics", {"INPUT": berkas[a:b], "STATISTIC": stat, "IGNORE_NODATA": True,
                                                  "REFERENCE_LAYER": berkas[a], "OUTPUT_NODATA_VALUE": -9999, "OUTPUT": out})
    med = gdal.Open(os.path.join(U.HASIL, "komposit_ndvi_%s_median.tif" % nama)).ReadAsArray()
    jml = gdal.Open(os.path.join(U.HASIL, "komposit_ndvi_%s_jumlah.tif" % nama)).ReadAsArray()
    print("%-12s tanggal %s sampai %s | pengamatan valid per piksel: min %d, rata-rata %.1f | piksel tanpa data: %d"
          % (nama, daftar[a][0], daftar[b - 1][0], jml.min(), jml.mean(), int((med == -9999).sum())))
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-9 | import os sampai import m3_umum as U | Perkakas, seperti sebelumnya. |
| 11 | daftar = U.daftar_citra() | Ambil daftar tanggal. |
| 12 | berkas = [os.path.join(...) for t, _, _ in daftar] | List comprehension: satu baris yang membangun daftar 24 jalur berkas NDVI bersih, satu untuk tiap tanggal (Bab 6). |
| 13 | periode = {"sebelum": (0, 8), ...} | Kamus tiga periode. Isinya pasangan nomor indeks: awal, lalu akhir. Akhir tidak termasuk. (0, 8) berarti tanggal ke-0 sampai ke-7, yaitu delapan tanggal pertama. |
| 14 | for nama, (a, b) in periode.items(): | Ulangi untuk tiap periode dan bongkar pasangan indeks menjadi a dan b. |
| 15 | for kode, stat in (("median", 3), ("jumlah", 1)): | Putaran kedua, di dalam putaran pertama: dua pasangan nama dan nomor statistik. Nomor 3 berarti median. Nomor 1 berarti jumlah pengamatan valid per piksel (Count). |
| 16 | out = os.path.join(...) | Nama keluaran, misalnya komposit_ndvi_sebelum_median.tif. |
| 17-18 | processing.run("native:cellstatistics", {...}) | Alat Cell statistics menghitung satu nilai per piksel dari tumpukan layer. INPUT adalah irisan daftar berkas[a:b]. STATISTIC memilih jenis hitungan. IGNORE_NODATA: True melewati piksel kosong. REFERENCE_LAYER memberi ukuran dan lokasi raster hasil. OUTPUT_NODATA_VALUE memilih -9999 sebagai tanda kosong. |
| 19-20 | med = gdal.Open(...).ReadAsArray() | Baca dua hasil tadi sebagai larik. |
| 21-22 | print("%-12s tanggal %s sampai %s ..." % (...)) | Cetak ringkasan: tanggal awal dan akhir periode, jumlah pengamatan valid terkecil (jml.min()) dan rata-ratanya, serta banyak piksel tanpa data. daftar[b - 1][0] mengambil tanggal terakhir yang benar-benar dipakai. Tanda %d mencetak bilangan bulat. |
Irisan berkas[a:b] adalah cara Python mengambil bagian daftar: dari nomor a sampai sebelum nomor b (Bab 5).
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
sebelum      tanggal 2024-01-05 sampai 2024-08-12 | pengamatan valid per piksel: min 3, rata-rata 6.4 | piksel tanpa data: 0
kemarau2024  tanggal 2024-06-13 sampai 2024-09-16 | pengamatan valid per piksel: min 2, rata-rata 3.6 | piksel tanpa data: 0
sesudah      tanggal 2025-09-21 sampai 2025-12-25 | pengamatan valid per piksel: min 1, rata-rata 2.7 | piksel tanpa data: 0
Periode "sebelum" punya rata-rata 6,4 pengamatan valid per piksel. Periode "sesudah" hanya 2,7, dan ada piksel yang hanya punya satu pengamatan. Median dari satu angka sama dengan angka itu sendiri, jadi komposit "sesudah" di piksel tersebut paling rapuh. Tidak ada piksel tanpa data (0).
Bagian yang boleh diubah.
- Baris 13, indeks periode. Tambah atau ubah periode. Saya menambahkan
"kemarau2025": (17, 21). Layar menampilkan satu baris baru:kemarau2025 tanggal 2025-06-18 sampai 2025-09-21 | pengamatan valid per piksel: min 2, rata-rata 3.8 | piksel tanpa data: 0. - Baris 15, nomor statistik. Angka adalah kode, bukan nama. Menurut bantuan alat: 0 penjumlahan (
Sum), 1 banyaknya data (Count), 2 rata-rata (Mean), 3 median (Median). Saya memeriksanya lewatqgis_process help native:cellstatistics. - Baris 18,
-9999. Tanda kosong. Ubah juga pada baris 22 bila Anda mengubahnya.
Jebakan.
- Indeks akhir tidak termasuk.
(5, 9)memakai tanggal ke-5, 6, 7, dan 8, bukan ke-9. Itu sebabnya tanggal akhir di baris 22 memakaib - 1. - Nomor statistik mudah tertukar. Kode 1 bukan "satu" dalam arti terkecil, melainkan banyak pengamatan. Selalu cek hasil: peta "jumlah" harus berisi bilangan bulat kecil.
- Periode di luar daftar menghasilkan galat. Saya mengganti periode "sesudah" menjadi
(24, 28). Layar menampilkanIndexError: list index out of rangepada baris 18, karenaberkas[24]tidak ada. - Skrip 26.4 harus sudah jalan. Saya menjalankannya di folder kosong. Layar menampilkan
Incorrect parameter value for INPUT.
Latihan variasi.
- Tambahkan periode
kemarau2025untuk tanggal ke-17 sampai ke-20. - Pastikan hasilnya muncul sebagai baris keempat.
Contoh jawaban, hanya baris 13:
periode = {"sebelum": (0, 8), "kemarau2024": (5, 9), "sesudah": (20, 24), "kemarau2025": (17, 21)}Layar menampilkan empat baris, dan baris terakhir sama seperti yang saya sebut di atas.
Skrip 26.6: Menambal lubang awan, lalu menguji tambalannya #
Berkas 2_3_isi_lubang.py. Di dalam berkasnya tertulis "SKRIP 2.3".
Tujuan. Mengisi lubang akibat awan pada deret NDVI dengan interpolasi linear sepanjang waktu, lalu menguji ketepatannya dengan menyembunyikan 20 persen pengamatan bersih.
Bahan. m3_umum.py dan paket data. Skrip ini langsung membaca citra mentah, jadi tidak memerlukan skrip lain. Jalankan dari Konsol atau terminal.
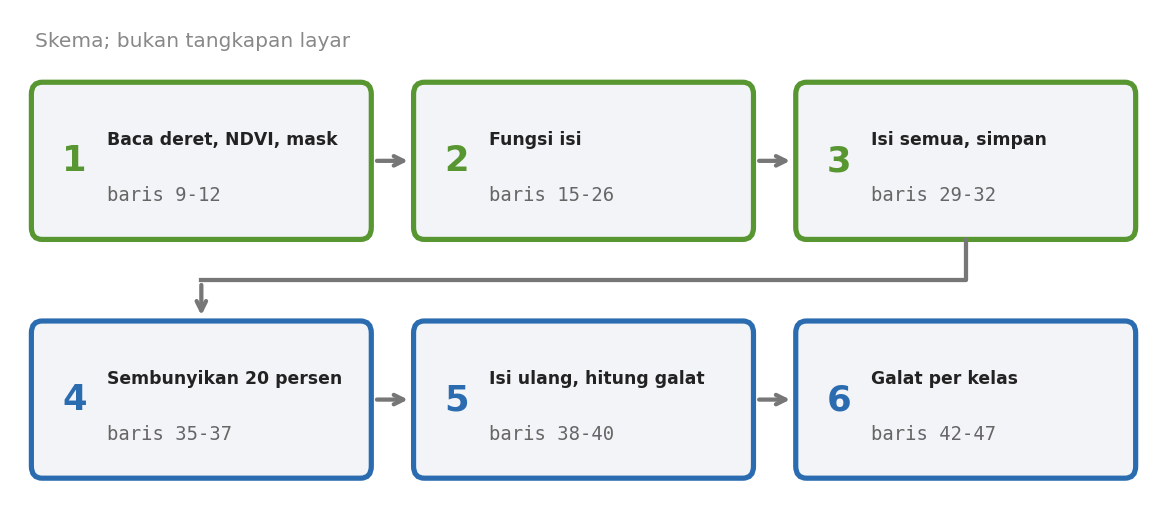
Skrip ini memuat satu fungsi buatan sendiri dan satu uji. Gambar berikut menunjukkan urutannya.
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 2.3: Isi lubang akibat awan dengan interpolasi linear sepanjang waktu, lalu uji kebenarannya
# Penulis: Badar Mubarok Yogaswara
# Cara uji: sembunyikan 20% pengamatan bersih secara acak, isi dengan interpolasi, bandingkan dengan nilai aslinya.
import os
import numpy as np
import m3_umum as U

tgl, refl, scl, gt, prj = U.baca_deret()
ndvi = U.nilai_ndvi(refl)
baik = U.bersih(scl)
hari = np.array([(t - tgl[0]).days for t in tgl], dtype="float64")     # sumbu waktu dalam hari (selang tidak sama)


def isi(ndvi, baik):
    T, H, W = ndvi.shape
    hasil = np.empty_like(ndvi)
    for i in range(H):
        for j in range(W):
            ok = baik[:, i, j]
            if ok.sum() == 0:
                hasil[:, i, j] = np.nan
            else:
                # np.interp: di luar rentang, nilai ujung dipakai (tidak ekstrapolasi)
                hasil[:, i, j] = np.interp(hari, hari[ok], ndvi[ok, i, j])
    return hasil


lengkap = isi(ndvi, baik)
U.tulis_tif(os.path.join(U.HASIL, "NDVI_isi.tif"), lengkap.astype("float32"), gt, prj,
            deskripsi=[t.isoformat() for t in tgl])
print("Piksel-tanggal awan sebelum diisi: %.1f%%, sesudah: %.1f%%" % (100 * (~baik).mean(), 100 * np.isnan(lengkap).mean()))

# uji sembunyi-isi
rng = np.random.default_rng(1)
sembunyi = baik & (rng.random(baik.shape) < 0.20)
sembunyi[0], sembunyi[-1] = False, False                   # tanggal ujung tidak diuji (tanpa tetangga di satu sisi)
uji = isi(ndvi, baik & ~sembunyi)
galat = (uji - ndvi)[sembunyi]
print("Uji sembunyi-isi: %d pengamatan; RMSE %.3f; galat mutlak median %.3f" % (sembunyi.sum(), np.sqrt(np.nanmean(galat ** 2)), np.nanmedian(np.abs(galat))))
# galat per kelas acuan
dinamika, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
nama = {1: "Hutan alam", 2: "Hutan tanaman", 3: "Pertanian", 4: "Air", 5: "Terbuka", 6: "Deforestasi", 7: "Terbakar", 8: "Panen HTI"}
for k in range(1, 9):
    m = sembunyi & (dinamika == k)[None]
    e = (uji - ndvi)[m]
    print("  %-14s n=%4d  RMSE %.3f" % (nama[k], m.sum(), np.sqrt(np.nanmean(e ** 2))))
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-7 | import os, import numpy as np, import m3_umum as U | Perkakas. Skrip ini tidak memakai QGIS sama sekali, hanya NumPy dan GDAL lewat kotak perkakas. |
| 9 | tgl, refl, scl, gt, prj = U.baca_deret() | Baca seluruh deret sekaligus. Lima hasil dibongkar ke lima kotak. |
| 10 | ndvi = U.nilai_ndvi(refl) | Hitung NDVI untuk semua tanggal. Bentuknya (24, 40, 40). |
| 11 | baik = U.bersih(scl) | Larik benar atau salah: benar di piksel-tanggal yang bersih. |
| 12 | hari = np.array([(t - tgl[0]).days for t in tgl], dtype="float64") | Ubah tiap tanggal menjadi hari ke-berapa sejak tanggal pertama. Selisih dua tanggal memberi objek yang punya atribut .days. Selang antar tanggal tidak sama, jadi waktu harus dalam hari, bukan nomor urut. |
| 15 | def isi(ndvi, baik): | Mulai fungsi buatan sendiri dengan dua masukan (Bab 7). |
| 16 | T, H, W = ndvi.shape | Ambil tiga ukuran: jumlah tanggal, tinggi, lebar. |
| 17 | hasil = np.empty_like(ndvi) | Siapkan larik kosong seukuran ndvi untuk menampung hasil. |
| 18-19 | for i in range(H): dan for j in range(W): | Dua putaran bersarang: telusuri tiap baris i dan tiap kolom j, sehingga tiap piksel dikunjungi sekali. |
| 20 | ok = baik[:, i, j] | Ambil 24 nilai benar atau salah milik piksel ini. Tanda : berarti "semua tanggal". |
| 21-22 | if ok.sum() == 0: lalu hasil[:, i, j] = np.nan | Bila tidak ada satu pun pengamatan bersih, isi seluruh deret piksel dengan nan. |
| 23-25 | else: lalu np.interp(...) | Bila ada, tarik garis lurus: np.interp(hari, hari[ok], ndvi[ok, i, j]) mencari nilai di semua hari berdasarkan hanya hari dan nilai yang bersih. |
| 26 | return hasil | Kembalikan hasilnya. |
| 29 | lengkap = isi(ndvi, baik) | Panggil fungsi untuk seluruh data. |
| 30-31 | U.tulis_tif(...) | Simpan hasil ke NDVI_isi.tif sebagai Float32, dengan nama band berupa tanggal. |
| 32 | print("Piksel-tanggal awan sebelum diisi: ...") | Bandingkan persen awan sebelum dan sesudah. Tanda ~ membalik benar-salah. |
| 35 | rng = np.random.default_rng(1) | Buat pengundi acak dengan benih 1. Benih yang sama selalu menghasilkan undian yang sama. |
| 36 | sembunyi = baik & (rng.random(baik.shape) < 0.20) | Pilih sekitar 20 persen dari piksel-tanggal bersih secara acak. Hanya yang bersih yang dipilih (baik &). |
| 37 | sembunyi[0], sembunyi[-1] = False, False | Tanggal pertama dan terakhir tidak diuji, karena tidak punya tetangga di satu sisi. Indeks -1 berarti yang terakhir. |
| 38 | uji = isi(ndvi, baik & ~sembunyi) | Isi ulang, kali ini seolah-olah titik yang disembunyikan awan. |
| 39 | galat = (uji - ndvi)[sembunyi] | Selisih tebakan dan nilai asli, hanya di titik yang disembunyikan. |
| 40 | print("Uji sembunyi-isi: ...") | Cetak jumlah pengamatan, RMSE, dan median galat mutlak. |
| 42-47 | dinamika, _, _ = ... sampai print(...) | Ulangi perhitungan galat per kelas tutupan menurut peta acuan. (dinamika == k)[None] menambah satu sumbu agar bentuknya (1, 40, 40) cocok dengan (24, 40, 40). |
RMSE adalah ukuran besar galat: selisih dikuadratkan, dirata-ratakan, lalu diakarkan. Selisih besar dihukum lebih berat daripada selisih kecil. Makin kecil, makin tepat.
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Piksel-tanggal awan sebelum diisi: 25.3%, sesudah: 0.0%
Uji sembunyi-isi: 5336 pengamatan; RMSE 0.078; galat mutlak median 0.014
  Hutan alam     n=2572  RMSE 0.038
  Hutan tanaman  n= 304  RMSE 0.039
  Pertanian      n= 625  RMSE 0.158
  Air            n= 277  RMSE 0.093
  Terbuka        n= 136  RMSE 0.020
  Deforestasi    n= 438  RMSE 0.117
  Terbakar       n= 520  RMSE 0.055
  Panen HTI      n= 464  RMSE 0.075
Awan sebelumnya 25,3 persen, sesudah ditambal 0,0 persen. Median galat hanya 0,014, jadi tambalan umumnya sangat dekat. RMSE total 0,078 lebih besar karena beberapa kelas sulit ditebak. Pertanian punya RMSE 0,158, empat kali hutan alam. Itu masuk akal: sawah naik turun cepat, dan garis lurus antar dua titik tidak menangkap lonjakan di antaranya.
Bagian yang boleh diubah.
- Baris 36,
0.20. Porsi yang disembunyikan. Saya menggantinya dengan0.40: jumlah pengamatan menjadi 10700 dan RMSE naik menjadi 0.091. Makin banyak yang disembunyikan, makin sulit tebakannya. - Baris 35, benih
1. Ganti ke7. Jumlah pengamatan menjadi 5209 dan RMSE 0.076. Angka bergeser sedikit, tetapi gambaran besarnya sama. - Baris 25, fungsi interpolasi. Fungsi lain bisa dipakai, asal mengembalikan nilai untuk semua hari.
Jebakan.
- Fungsi
isimenduplikasiU.isi_waktu. Isi keduanya hampir sama: fungsi di kotak perkakas (m3_umum.pybaris 94-103) dipakai Skrip 26.12. Saya menjalankan keduanya pada data yang sama. Hasilnyanp.allclosebenar, selisih terbesar2.98e-08, dan posisinansama. Selisih sekecil itu hanya karena tipe angka (satu 32 bit, satu 64 bit). - Putaran per piksel lambat untuk raster besar. Data contoh hanya 1600 piksel. Raster 10.000 kali 10.000 punya 62.500 kali lebih banyak.
- Di luar rentang,
np.interpmemakai nilai ujung. Ia tidak menarik garis ke luar (tidak ekstrapolasi). Karena itu tanggal ujung dikeluarkan dari uji (baris 37). - Ukuran dan luas tidak dikunci di skrip ini.
T, H, Wdiambil dari data. Skrip lain di bab ini mengunci 40 kali 40 piksel dan 0,01 hektare per piksel, dan itu dicatat di tempatnya.
Latihan variasi.
- Sembunyikan 40 persen pengamatan bersih.
- Bandingkan RMSE totalnya dengan hasil asli (0,078).
Contoh jawaban, hanya baris 36:
sembunyi = baik & (rng.random(baik.shape) < 0.40)Layar menampilkan Uji sembunyi-isi: 10700 pengamatan; RMSE 0.091; galat mutlak median 0.015. RMSE naik dari 0,078 menjadi 0,091.
Kelompok C: Mengukur irama tiap tutupan lahan #
Konsep: irama dalam tiga kalimat #
Tiap tutupan lahan punya sidik jari musiman, seperti detak jantung tiap orang berbeda: hutan berdetak tenang, sawah berdetak cepat dan tinggi. Anda bisa meringkas detak itu dalam beberapa angka per piksel: rata-rata, seberapa tinggi naik turunnya, ke mana arah umumnya, dan kapan puncaknya. Angka ringkas ini disebut metrik deret waktu.
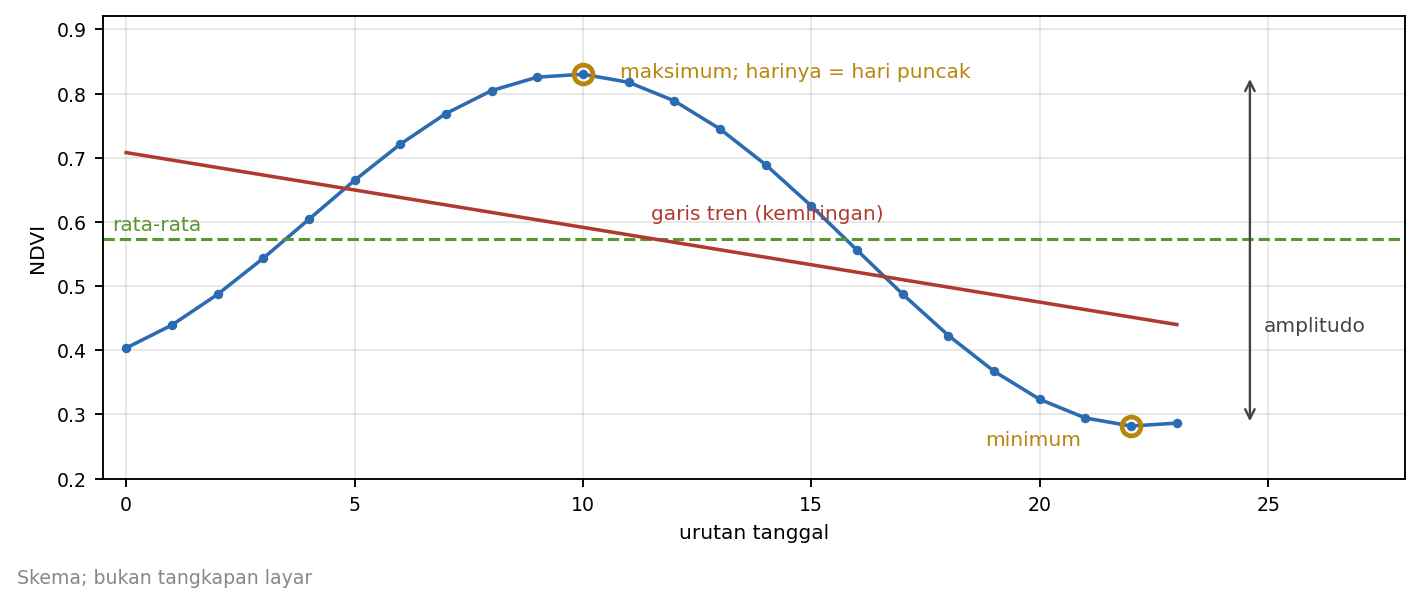
Lima istilah yang perlu Anda kenal sekarang:
- Amplitudo: selisih nilai tertinggi dan terendah dalam satu deret.
- Simpangan baku: ukuran seberapa jauh nilai biasanya menyimpang dari rata-ratanya.
- Tren: kemiringan garis lurus yang paling cocok dengan deret. Di bab ini dinyatakan sebagai perubahan NDVI per tahun.
- Hari puncak: hari ke-berapa (sejak tanggal pertama) NDVI mencapai maksimum.
- Anomali: selisih nilai satu tanggal dari rata-rata piksel itu sendiri.
Skrip 26.7: Metrik deret waktu per piksel #
Berkas 3_1_metrik_deret.py. Di dalam berkasnya tertulis "SKRIP 3.1".
Tujuan. Menghitung tujuh metrik NDVI tiap piksel, meringkasnya per kelas tutupan lahan, dan menghitung anomali tiap tanggal.
Bahan. Hasil Skrip 26.6 (NDVI_isi.tif), peta acuan acuan/Acuan_Dinamika.tif (delapan kelas tutupan), dan m3_umum.py. Skrip ini hanya memakai NumPy dan GDAL, jadi bisa dijalankan dari Konsol maupun terminal.
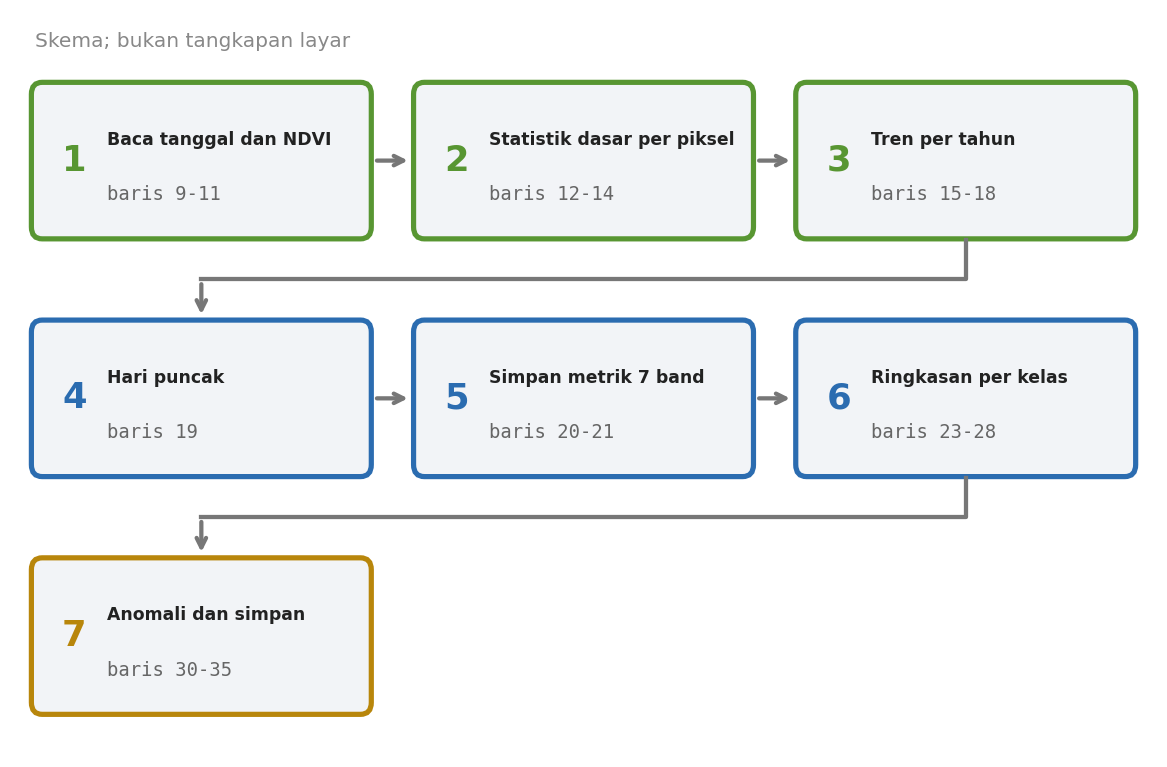
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 3.1: Metrik deret waktu per piksel: rata-rata, minimum, maksimum, amplitudo, simpangan baku, tren per tahun, tanggal puncak
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 2.3 sudah dijalankan (hasil/NDVI_isi.tif). Menghasilkan hasil/metrik_ndvi.tif (7 band).
import os
import numpy as np
import m3_umum as U

tgl = [t for t, _, _ in U.daftar_citra()]
hari = np.array([(t - tgl[0]).days for t in tgl], dtype="float64")
x, gt, prj = U.baca_tif(os.path.join(U.HASIL, "NDVI_isi.tif"))          # (24, H, W)
rata, mini, maks = x.mean(0), x.min(0), x.max(0)
amplitudo = maks - mini
sb = x.std(0)
# tren: kemiringan garis lurus terhadap waktu dalam HARI, lalu dikali 365 -> perubahan NDVI per tahun
hc = hari - hari.mean()
kemiringan = (hc[:, None, None] * (x - rata)).sum(0) / (hc ** 2).sum()
tren_tahun = kemiringan * 365.0
puncak = hari[x.argmax(0)]                                              # hari ke- (sejak tanggal pertama) saat NDVI tertinggi
nama = ["rata", "minimum", "maksimum", "amplitudo", "simpangan_baku", "tren_per_tahun", "hari_puncak"]
U.tulis_tif(os.path.join(U.HASIL, "metrik_ndvi.tif"), np.array([rata, mini, maks, amplitudo, sb, tren_tahun, puncak]).astype("float32"), gt, prj, deskripsi=nama)

din, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
kls = {1: "Hutan alam", 2: "Hutan tanaman", 3: "Pertanian", 4: "Air", 5: "Terbuka", 6: "Deforestasi", 7: "Terbakar", 8: "Panen HTI"}
print("%-14s %6s %9s %9s %12s" % ("Kelas", "rata", "amplitudo", "simp.baku", "tren/tahun"))
for k, n in kls.items():
    m = din == k
    print("%-14s %6.2f %9.2f %9.2f %12.3f" % (n, rata[m].mean(), amplitudo[m].mean(), sb[m].mean(), tren_tahun[m].mean()))

# anomali: selisih NDVI tiap tanggal terhadap rata-rata piksel itu
anomali = x - rata[None]
U.tulis_tif(os.path.join(U.HASIL, "anomali_ndvi.tif"), anomali.astype("float32"), gt, prj, deskripsi=[t.isoformat() for t in tgl])
i_sep = tgl.index(__import__("datetime").date(2024, 9, 16))
m = din == 7
print("Anomali NDVI rata-rata di bekas terbakar pada 2024-09-16: %.3f; di hutan stabil: %.3f" % (anomali[i_sep][m].mean(), anomali[i_sep][din == 1].mean()))
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-7 | import os, import numpy as np, import m3_umum as U | Perkakas yang sama seperti sebelumnya. |
| 9 | tgl = [t for t, _, _ in U.daftar_citra()] | Daftar 24 tanggal. |
| 10 | hari = np.array([...], dtype="float64") | Tiap tanggal menjadi hari ke-berapa sejak tanggal pertama. |
| 11 | x, gt, prj = U.baca_tif(...NDVI_isi.tif) | Baca tumpukan NDVI yang sudah ditambal. Bentuk x adalah (24, tinggi, lebar). |
| 12 | rata, mini, maks = x.mean(0), x.min(0), x.max(0) | Tiga hitungan sekaligus. Angka 0 berarti "sepanjang sumbu pertama", yaitu sumbu waktu. Hasilnya satu angka per piksel. |
| 13 | amplitudo = maks - mini | Selisih tertinggi dan terendah. |
| 14 | sb = x.std(0) | Simpangan baku per piksel. |
| 16 | hc = hari - hari.mean() | Pemusatan: kurangi tiap hari dengan hari rata-rata, supaya hitungan tren lebih rapi. |
| 17 | kemiringan = (hc[:, None, None] * (x - rata)).sum(0) / (hc ** 2).sum() | Rumus kemiringan garis lurus terbaik. hc[:, None, None] mengubah daftar 24 angka menjadi bentuk (24, 1, 1) agar bisa dikalikan dengan x yang berbentuk (24, tinggi, lebar). Hasilnya kemiringan per hari. |
| 18 | tren_tahun = kemiringan * 365.0 | Kemiringan per hari dikali 365 menjadi perubahan NDVI per tahun. |
| 19 | puncak = hari[x.argmax(0)] | argmax(0) memberi nomor tanggal tempat NDVI tertinggi. hari[...] mengubah nomor itu menjadi hari ke-berapa. |
| 20 | nama = ["rata", ...] | Tujuh nama band untuk berkas keluaran. |
| 21 | U.tulis_tif(..., np.array([...]).astype("float32"), gt, prj, deskripsi=nama) | Susun tujuh larik menjadi satu larik tujuh band, ubah ke Float32, lalu simpan ke metrik_ndvi.tif dengan nama band. |
| 23 | din, _, _ = U.baca_tif(...Acuan_Dinamika.tif) | Baca peta acuan kelas tutupan (1 sampai 8). Dua hasil lain diabaikan. |
| 24 | kls = {1: "Hutan alam", ...} | Kamus nomor kelas menjadi nama kelas. |
| 25 | print("%-14s %6s %9s %9s %12s" % (...)) | Cetak judul kolom tabel dengan lebar tetap. |
| 26 | for k, n in kls.items(): | Ulangi untuk tiap kelas. |
| 27 | m = din == k | Larik benar atau salah: benar di piksel yang kelas acuannya k. |
| 28 | print("%-14s %6.2f ..." % (n, rata[m].mean(), ...)) | rata[m] mengambil nilai rata-rata hanya di piksel kelas itu, lalu dirata-ratakan lagi. Hasilnya satu baris ringkasan per kelas. |
| 31 | anomali = x - rata[None] | Kurangi tiap tanggal dengan rata-rata piksel. rata[None] menambah sumbu waktu agar bentuknya cocok. |
| 32 | U.tulis_tif(..."anomali_ndvi.tif"...) | Simpan 24 band anomali. |
| 33 | i_sep = tgl.index(__import__("datetime").date(2024, 9, 16)) | Cari nomor urut tanggal 16 September 2024 di daftar. __import__("datetime") adalah cara tidak lazim memanggil perkakas datetime di tempat. Cara yang lebih rapi adalah import datetime di bagian atas. |
| 34 | m = din == 7 | Kali ini kelas 7, bekas terbakar. |
| 35 | print("Anomali NDVI rata-rata di bekas terbakar ...") | Cetak anomali tanggal itu di bekas terbakar, lalu di hutan alam stabil (din == 1). |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Kelas            rata amplitudo simp.baku   tren/tahun
Hutan alam       0.86      0.10      0.02       -0.004
Hutan tanaman    0.77      0.10      0.02       -0.006
Pertanian        0.50      0.46      0.15       -0.027
Air             -0.33      0.29      0.07        0.003
Terbuka          0.11      0.06      0.02       -0.001
Deforestasi      0.64      0.59      0.22       -0.281
Terbakar         0.82      0.23      0.06       -0.022
Panen HTI        0.61      0.51      0.17       -0.200
Anomali NDVI rata-rata di bekas terbakar pada 2024-09-16: -0.115; di hutan stabil: -0.015
Bacalah tabelnya per kelas. Hutan alam stabil: rata-rata 0,86, amplitudo hanya 0,10, hampir tidak punya tren. Pertanian naik turun: amplitudo 0,46. Deforestasi dan panen hutan tanaman punya tren turun tajam (-0,281 dan -0,200 per tahun). Baris terakhir menunjukkan tanda awal kebakaran: pada 16 September 2024, NDVI di bekas terbakar turun 0,115 dari kebiasaannya, sedangkan hutan stabil hanya 0,015.
Bagian yang boleh diubah.
- Baris 18,
365.0. Pengali satuan tren. Saya mengubahnya menjadi30.0, yaitu perubahan per 30 hari. Tren deforestasi di tabel berubah dari-0.281menjadi-0.023. - Baris 33, tanggal anomali. Ganti ke tanggal lain yang ada di
Daftar_Citra.csv. Saya mengganti menjadidate(2025, 8, 17). Layar menampilkanAnomali NDVI rata-rata di bekas terbakar pada 2024-09-16: -0.031; di hutan stabil: -0.020. - Baris 12-14, statistik tambahan. Tambah
x.std(0)ataunp.median(x, axis=0)untuk metrik baru, lalu tambahkan namanya ke daftar baris 20.
Jebakan.
- Teks di
printtidak ikut berubah. Pada contoh di atas, tanggal diganti tetapi teksnya masih tertulis2024-09-16. Angka yang tampil memang milik 17 Agustus 2025, tetapi labelnya salah. Setelah mengganti tanggal, ganti juga tulisannya di baris 35. Pada tanggal itu pun angkanya mencampur dua kebakaran, sebab kelas 7 mencakup bekas bakar tahun 2024 dan 2025. - Tanggal harus ada di daftar. Saya mengganti baris 33 menjadi
date(2024, 9, 17)dan layar menampilkanValueError: datetime.date(2024, 9, 17) is not in list. - Skrip 26.6 harus sudah jalan. Di folder kosong, layar menampilkan
RuntimeError: ...NDVI_isi.tif: No such file or directory. - Selang antar tanggal tidak sama. Karena itu tren dihitung terhadap hari, bukan nomor urut. Tren pada data dua tahun hanya cukup untuk belajar, belum untuk laporan resmi [CEK].
Latihan variasi.
- Cetak juga hari puncak rata-rata tiap kelas.
- Bandingkan kelas yang kemudian berubah (deforestasi, terbakar) dengan hutan alam.
Contoh jawaban, tambahkan di akhir skrip:
for k, n in kls.items():
    print("%-14s hari puncak rata-rata: %5.0f" % (n, puncak[din == k].mean()))
Saya menjalankannya. Layar menampilkan delapan baris tambahan. Tiga di antaranya: Hutan alam hari puncak rata-rata: 303, Deforestasi hari puncak rata-rata: 113, dan Terbakar hari puncak rata-rata: 87. Kelas yang kemudian berubah mencapai puncaknya jauh lebih awal (sekitar hari ke-100) daripada hutan alam (hari ke-303). Wajar: setelah kejadian, NDVI-nya jatuh dan tidak naik lagi.
Kelompok D: Mendeteksi hutan yang hilang #
Konsep: dua foto lawan seluruh film #
Deteksi dua waktu itu seperti permainan "temukan perbedaan" antara foto sebelum dan sesudah: cepat dan mudah, tetapi hanya tahu bahwa sesuatu berubah, bukan kapan. Deteksi titik patah menonton seluruh film setiap piksel, dan mencatat saat nilainya jatuh lalu tidak kembali. Cara kedua bisa menyebut tanggal, tetapi lebih lambat.
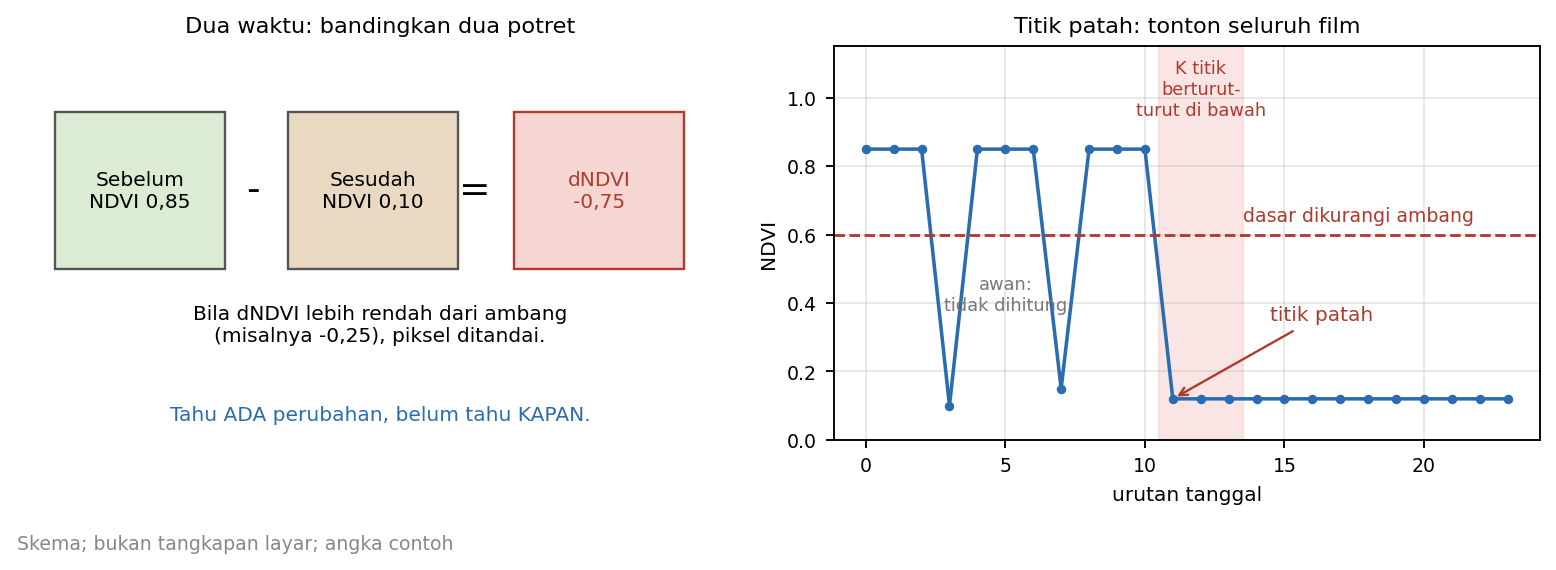
Lima istilah yang perlu Anda kenal sekarang:
- dNDVI: NDVI sesudah dikurangi NDVI sebelum. Nilai sangat negatif berarti kehijauan hilang.
- Ambang: batas angka untuk menyebut sesuatu "berubah".
- Luas minimum: gumpalan piksel yang lebih kecil dari batas ini dibuang sebagai derau.
- Titik patah: saat sebuah deret berubah nilai secara menetap.
- Pengamatan berturut-turut: syarat bahwa penurunan harus bertahan beberapa tanggal, supaya awan yang lolos tidak menipu.
Kepala Seksi berpesan satu hal: panen hutan tanaman bukan deforestasi. Itu tebangan terencana. Kedua skrip di bawah membuang kawasan hutan tanaman memakai peta Kawasan_HTI.gpkg.
Skrip 26.8: Deforestasi dari dua waktu #
Berkas 4_1_deforestasi_dua_waktu.py. Di dalam berkasnya tertulis "SKRIP 4.1".
Tujuan. Mendeteksi deforestasi dari selisih komposit NDVI sebelum dan sesudah, dengan ambang dan saringan luas minimum. Lalu membuang kawasan hutan tanaman, dan memeriksa hasilnya terhadap peta acuan.
Bahan. Hasil Skrip 26.5 (komposit median sebelum dan sesudah), vektor/Kawasan_HTI.gpkg, acuan/Acuan_Perubahan.tif, acuan/Acuan_Dinamika.tif, dan m3_umum.py. Jalankan dari Konsol atau terminal.
Skrip ini panjang dan memuat sembilan tahap. Gambar berikut membantu Anda membaginya menjadi bagian kecil.
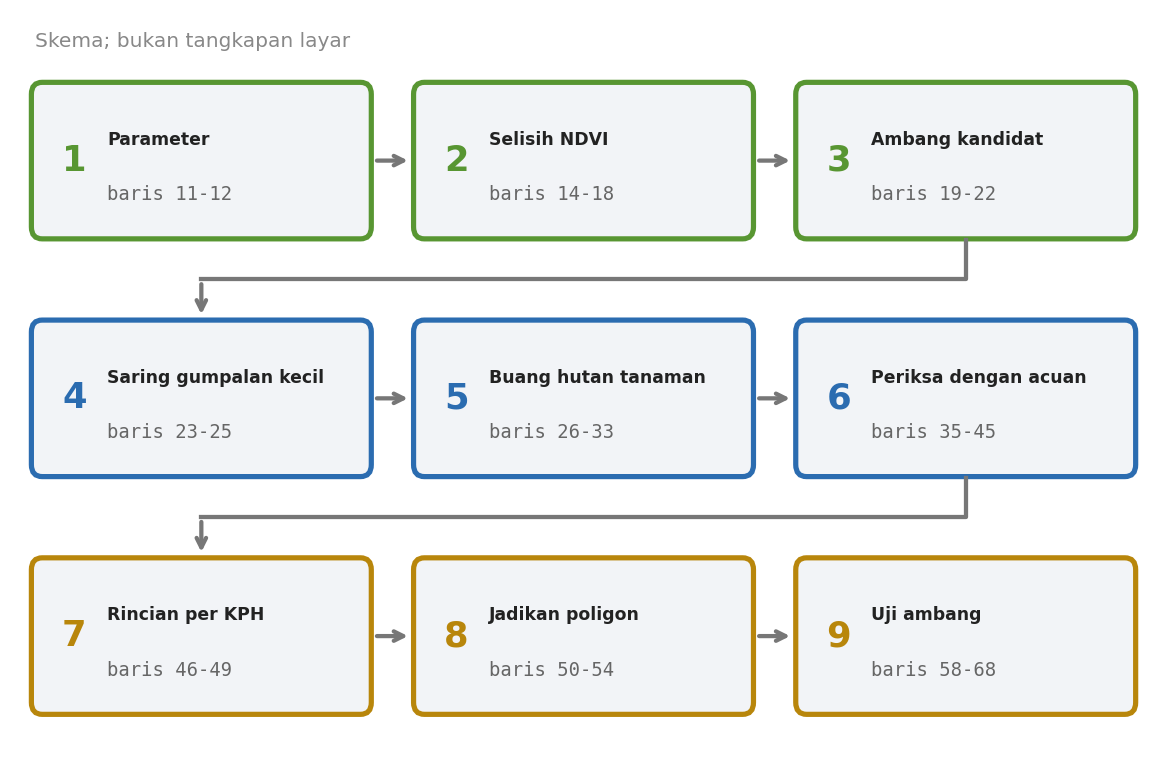
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 4.1: Deteksi deforestasi dua waktu: selisih komposit NDVI (sesudah dikurangi sebelum), ambang, saringan luas minimum
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 2.2 sudah dijalankan. Ambang dan luas minimum bisa Anda ubah di bagian PARAMETER.
import os
import numpy as np
import processing
from qgis.core import QgsRasterLayer, QgsVectorLayer, QgsProject
import m3_umum as U

AMBANG = -0.25          # selisih NDVI di bawah nilai ini dianggap kehilangan tutupan
LUAS_MIN_PIKSEL = 5     # gumpalan lebih kecil dari ini (5 piksel = 0,05 ha) dibuang sebagai derau

sebelum = QgsRasterLayer(os.path.join(U.HASIL, "komposit_ndvi_sebelum_median.tif"), "sebelum")
sesudah = QgsRasterLayer(os.path.join(U.HASIL, "komposit_ndvi_sesudah_median.tif"), "sesudah")
QgsProject.instance().addMapLayers([sebelum, sesudah], False)
d_ndvi = os.path.join(U.HASIL, "dNDVI.tif")
processing.run("native:rastercalc", {"LAYERS": [sebelum, sesudah], "EXPRESSION": '"sesudah@1" - "sebelum@1"', "OUTPUT": d_ndvi})
# 1) ambang: hanya piksel yang hutan sebelumnya (NDVI sebelum >= 0.7) dan turun lewat AMBANG
kand = os.path.join(U.HASIL, "kandidat_deforestasi.tif")
processing.run("native:rastercalc", {"LAYERS": [sebelum, sesudah],
    "EXPRESSION": '(("sebelum@1" >= 0.7) AND (("sesudah@1" - "sebelum@1") < %s)) * 1' % AMBANG, "OUTPUT": kand})
# 2) saring gumpalan kecil
saring = os.path.join(U.HASIL, "kandidat_disaring.tif")
processing.run("gdal:sieve", {"INPUT": kand, "THRESHOLD": LUAS_MIN_PIKSEL, "EIGHT_CONNECTEDNESS": True, "NO_MASK": True, "OUTPUT": saring})
# 3) buang kawasan hutan tanaman (panen HTI itu terencana, bukan deforestasi)
hti = os.path.join(U.HASIL, "mask_hti.tif")
processing.run("gdal:rasterize", {"INPUT": os.path.join(U.PAKET, "vektor", "Kawasan_HTI.gpkg"), "BURN": 1, "UNITS": 1,
    "WIDTH": 10, "HEIGHT": 10, "EXTENT": "312000,312400,9996000,9996400 [EPSG:32749]", "INIT": 0, "NODATA": 255, "DATA_TYPE": 0, "OUTPUT": hti})
final = os.path.join(U.HASIL, "deforestasi_2waktu.tif")
l1, l2 = QgsRasterLayer(saring, "saring"), QgsRasterLayer(hti, "hti")
QgsProject.instance().addMapLayers([l1, l2], False)
processing.run("native:rastercalc", {"LAYERS": [l1, l2], "EXPRESSION": '("saring@1" = 1) AND ("hti@1" = 0)', "OUTPUT": final})

# pemeriksaan terhadap peta acuan
hasil, gt, _ = U.baca_tif(final)
hasil = hasil == 1
acuan, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Perubahan.tif"))
benar = acuan == 1
tp = (hasil & benar).sum(); fp = (hasil & ~benar).sum(); fn = (~hasil & benar).sum()
print("Terdeteksi: %d piksel = %.2f ha; acuan: %d piksel = %.2f ha" % (hasil.sum(), hasil.sum() * 0.01, benar.sum(), benar.sum() * 0.01))
print("Tepat %d, salah tambah %d, terlewat %d; presisi %.2f, kepekaan %.2f" % (tp, fp, fn, tp / max(tp + fp, 1), tp / max(tp + fn, 1)))
din, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
nama = {1: "Hutan alam", 2: "Hutan tanaman", 3: "Pertanian", 4: "Air", 5: "Terbuka", 6: "Deforestasi", 7: "Terbakar", 8: "Panen HTI"}
print("Piksel terdeteksi menurut kelas acuan:", {nama[k]: int((hasil & (din == k)).sum()) for k in range(1, 9) if (hasil & (din == k)).sum()})
rr, cc = np.mgrid[0:40, 0:40]
kph = np.where(rr < 20, "Gamma", np.where(cc < 20, "Alpha", "Beta"))
for k in ("Alpha", "Beta", "Gamma"):
    print("  %-6s deforestasi terdeteksi %.2f ha, acuan %.2f ha" % (k, (hasil & (kph == k)).sum() * 0.01, (benar & (kph == k)).sum() * 0.01))
poli = os.path.join(U.HASIL, "deforestasi_2waktu.gpkg")
if os.path.exists(poli):
    os.remove(poli)                  # polygonize ke GPKG yang sudah ada MENAMBAH fitur, bukan menimpa
processing.run("gdal:polygonize", {"INPUT": final, "BAND": 1, "FIELD": "DN", "EIGHT_CONNECTEDNESS": True, "OUTPUT": poli})
print("Poligon tersimpan:", poli)


# uji kepekaan ambang (tanpa saringan luas minimum, dengan dan tanpa peta HTI)
dn, _, _ = U.baca_tif(os.path.join(U.HASIL, "dNDVI.tif"))
sb, _, _ = U.baca_tif(os.path.join(U.HASIL, "komposit_ndvi_sebelum_median.tif"))
htim, _, _ = U.baca_tif(hti)
print("Ambang   dengan peta HTI (tepat/salah/lewat)   tanpa peta HTI (tepat/salah/lewat)")
for a in (-0.15, -0.25, -0.35, -0.45):
    k = (sb >= 0.7) & (dn < a)
    for_hti = k & (htim == 0)
    t1, f1, l1_ = (for_hti & benar).sum(), (for_hti & ~benar).sum(), (~for_hti & benar).sum()
    t2, f2, l2_ = (k & benar).sum(), (k & ~benar).sum(), (~k & benar).sum()
    print("%6.2f   %4d / %4d / %4d                    %4d / %4d / %4d" % (a, t1, f1, l1_, t2, f2, l2_))
Penjelasan baris demi baris. Baris 55-57 kosong, jadi tidak muncul di tabel.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-9 | import os sampai import m3_umum as U | Perkakas. QgsVectorLayer diimpor tetapi tidak dipakai di skrip ini. |
| 11 | AMBANG = -0.25 | Konstanta: kotak yang sengaja ditulis dengan huruf besar sebagai tanda "nilai ini boleh Anda ubah". Selisih NDVI di bawah -0,25 dianggap kehilangan tutupan. |
| 12 | LUAS_MIN_PIKSEL = 5 | Gumpalan lebih kecil dari lima piksel (0,05 hektare) dibuang. |
| 14-15 | sebelum = QgsRasterLayer(...) dan sesudah = ... | Buka dua komposit median sebagai layer bernama sebelum dan sesudah. |
| 16 | QgsProject.instance().addMapLayers([sebelum, sesudah], False) | Daftarkan dua layer ke proyek, tanpa ditampilkan. |
| 17-18 | d_ndvi = ... lalu processing.run("native:rastercalc", ...) | Hitung selisih "sesudah@1" - "sebelum@1" dan simpan sebagai dNDVI.tif. |
| 20-22 | kand = ... dan processing.run(...) | Hitung peta kandidat: bernilai 1 bila NDVI sebelum sekurang-kurangnya 0,7 (dulunya hutan) dan selisihnya di bawah ambang. %s diganti oleh nilai AMBANG. Perkalian * 1 mengubah hasil benar atau salah menjadi angka 1 atau 0. |
| 24-25 | saring = ... lalu processing.run("gdal:sieve", {...}) | Alat Sieve membuang gumpalan kecil. THRESHOLD diisi LUAS_MIN_PIKSEL. EIGHT_CONNECTEDNESS: True berarti piksel yang bersentuhan di sudut dianggap satu gumpalan. NO_MASK: True berarti tidak memakai penanda validitas bawaan. |
| 27-29 | hti = ... lalu processing.run("gdal:rasterize", {...}) | Ubah peta vektor hutan tanaman menjadi raster. BURN: 1 mengisi 1 di dalam kawasan, INIT: 0 mengisi 0 di luar. UNITS: 1 berarti ukuran diberikan dalam satuan peta. WIDTH dan HEIGHT 10 berarti piksel 10 meter. EXTENT menentukan batas area: di sinilah ukuran area dikunci. DATA_TYPE: 0 memilih Byte. |
| 30-33 | final = ... sampai processing.run(...) | Buka saringan dan mask HTI sebagai layer, lalu hitung hasil akhir: ("saring@1" = 1) AND ("hti@1" = 0), yaitu terdeteksi dan bukan hutan tanaman. |
| 36-37 | hasil, gt, _ = U.baca_tif(final) lalu hasil = hasil == 1 | Baca hasil akhir, lalu jadikan larik benar atau salah. |
| 38-39 | acuan, _, _ = ... lalu benar = acuan == 1 | Baca peta acuan perubahan. Nilai 1 berarti deforestasi sebenarnya. |
| 40 | tp = ...; fp = ...; fn = ... | Tiga pernyataan dalam satu baris, dipisah titik koma. tp (tepat) adalah terdeteksi dan benar. fp (salah tambah) adalah terdeteksi tetapi salah. fn (terlewat) adalah benar tetapi tidak terdeteksi. Tanda ~ membalik benar-salah. |
| 41 | print("Terdeteksi: %d piksel = %.2f ha; ...") | Cetak jumlah piksel dan luasnya. Luas dihitung dari jumlah piksel kali 0,01 hektare, angka yang dikunci untuk piksel 10 meter. |
| 42 | print("Tepat %d, salah tambah %d, ...") | Cetak tp, fp, fn, serta presisi (tp dibagi tp + fp) dan kepekaan (tp dibagi tp + fn). max(tp + fp, 1) mencegah pembagian dengan nol. |
| 43-44 | din, _, _ = ... lalu nama = {...} | Baca peta kelas tutupan, dan kamus nama kelas. |
| 45 | print("...", {nama[k]: int((hasil & (din == k)).sum()) for k in range(1, 9) if (...).sum()}) | Dictionary comprehension: kamus yang dibangun dalam satu baris. Ia menghitung, untuk tiap kelas acuan, berapa piksel terdeteksi, dan hanya mencatat kelas yang jumlahnya lebih dari nol. |
| 46 | rr, cc = np.mgrid[0:40, 0:40] | Dua larik 40 kali 40 yang berisi nomor baris dan nomor kolom tiap piksel. Ukuran 40 dikunci di sini. |
| 47 | kph = np.where(rr < 20, "Gamma", np.where(cc < 20, "Alpha", "Beta")) | Menandai KPH tiap piksel. Baris bernomor kurang dari 20 (setengah utara) adalah Gamma. Sisanya, kolom kiri (nomor kurang dari 20) adalah Alpha dan kolom kanan adalah Beta. Ini tiruan pembagian wilayah, bukan dibaca dari peta batas. |
| 48-49 | for k in ("Alpha", "Beta", "Gamma"): | Cetak luas terdeteksi dan luas acuan tiap KPH. |
| 50 | poli = os.path.join(...) | Jalur berkas GeoPackage untuk poligon hasil. |
| 51-52 | if os.path.exists(poli): lalu os.remove(poli) | Hapus berkas lama. os.path.exists bertanya apakah berkas sudah ada (Bab 8). Bila ada, os.remove menghapusnya. Alat Polygonize menambah poligon ke GeoPackage yang sudah ada dan tidak menimpanya, jadi tanpa dua baris ini jalan kedua menumpuk poligon. |
| 53 | processing.run("gdal:polygonize", {...}) | Ubah hasil akhir menjadi poligon di berkas GeoPackage. |
| 54 | print("Poligon tersimpan:", poli) | Cetak lokasi berkas poligon. |
| 59-61 | dn, _, _ = ... sampai htim, _, _ = ... | Baca ulang selisih NDVI, komposit sebelum, dan mask HTI untuk uji ambang. |
| 62 | print("Ambang dengan peta HTI ...") | Cetak judul tabel uji. |
| 63 | for a in (-0.15, -0.25, -0.35, -0.45): | Ulangi untuk empat ambang berbeda. |
| 64-65 | k = (sb >= 0.7) & (dn < a) lalu for_hti = k & (htim == 0) | Hitung kandidat tanpa saringan luas, lalu versi yang membuang hutan tanaman. |
| 66-67 | t1, f1, l1_ = ... dan t2, f2, l2_ = ... | Hitung tepat, salah, dan terlewat untuk kedua versi. Nama l1_ memakai garis bawah di akhir supaya tidak bentrok dengan l1 di baris 31. |
| 68 | print("%6.2f %4d / %4d / %4d ...") | Cetak satu baris tabel uji ambang. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Terdeteksi: 130 piksel = 1.30 ha; acuan: 130 piksel = 1.30 ha
Tepat 130, salah tambah 0, terlewat 0; presisi 1.00, kepekaan 1.00
Piksel terdeteksi menurut kelas acuan: {'Deforestasi': 130}
  Alpha  deforestasi terdeteksi 0.30 ha, acuan 0.30 ha
  Beta   deforestasi terdeteksi 0.00 ha, acuan 0.00 ha
  Gamma  deforestasi terdeteksi 1.00 ha, acuan 1.00 ha
Poligon tersimpan: D:/Latihan_M3/hasil\deforestasi_2waktu.gpkg
Ambang   dengan peta HTI (tepat/salah/lewat)   tanpa peta HTI (tepat/salah/lewat)
 -0.15    130 /   13 /    0                     130 /  133 /    0
 -0.25    130 /    1 /    0                     130 /   24 /    0
 -0.35    118 /    1 /   12                     118 /    1 /   12
 -0.45     26 /    0 /  104                      26 /    0 /  104
Hasilnya sempurna: 130 piksel (1,30 hektare) terdeteksi, semuanya benar, tidak ada yang terlewat. Rincian per KPH cocok dengan acuan. Data ini sintetis, jadi jangan berharap sebersih ini pada data nyata. Tabel uji ambang adalah bagian paling berguna. Pada ambang -0,15, kedua versi sama-sama menangkap semua 130 piksel. Namun versi dengan peta hutan tanaman salah 13 piksel, sedangkan versi tanpa peta salah 133 piksel. Itulah gunanya membuang kawasan hutan tanaman.
Bagian yang boleh diubah.
- Baris 11,
AMBANG. Makin negatif, makin ketat. Saya mencoba-0.35: layar menampilkanTerdeteksi: 118 piksel = 1.18 hadanTepat 118, salah tambah 0, terlewat 12; presisi 1.00, kepekaan 0.91. - Baris 12,
LUAS_MIN_PIKSEL. Ubah menjadi1: terdeteksi 131 piksel, dengan satu salah tambah (di kelas Pertanian). Ubah menjadi60: terdeteksi hanya 100 piksel, dan bukaan kecil di Alpha yang 30 piksel ikut terbuang (terlewat 30, kepekaan 0,77). Saringan yang terlalu besar membuang kejadian nyata. - Baris 22,
0.7. Ambang NDVI hutan sebelum perubahan.
Jebakan.
- Banyak hal dikunci untuk data contoh.
EXTENTdi baris 29 (312000,312400,9996000,9996400), ukuran piksel 10 meter, ukuran 40 kali 40 di baris 46, luas 0,01 hektare per piksel di baris 41 dan 49, serta pembagian KPHrr < 20di baris 47. Pada data lain, semuanya harus diganti, atau hasilnya salah tanpa pesan galat. - Alat Polygonize menambah, bukan menimpa. Itu sebabnya baris 51-52 menghapus
deforestasi_2waktu.gpkglebih dulu. Saya menjalankan skrip dua kali pada folder yang sama, dan jumlah poligon tetap 3 pada jalan kedua. Tanpa dua baris itu, jumlahnya naik menjadi 6. Bila Windows menolak penghapusan karena berkas itu masih terbuka sebagai layer di QGIS,os.removegagal denganPermissionError: [WinError 32](diuji; layer di kanvas jendela QGIS tidak diuji). Hapus layernya dari proyek, lalu jalankan ulang. - Nama layer harus sama persis dengan nama di rumus.
"sebelum@1"mengacu pada layer bernamasebelum. - Skrip 26.5 harus sudah jalan. Di folder kosong, layar menampilkan
QgsProcessingException: Error creating output file.Pesan itu menyesatkan: yang hilang adalah masukan, bukan keluaran. - Skrip ini panjang dan mencampur tiga pekerjaan: mendeteksi, memeriksa, dan menguji ambang. Memecahnya menjadi tiga berkas akan lebih rapi, tetapi buku ini membahasnya apa adanya.
Latihan variasi.
- Ubah ambang menjadi
-0.35, lalu bandingkan hasilnya dengan ambang asli. - Ubah luas minimum menjadi
1, lalu cari tahu piksel salah tambah itu masuk kelas apa.
Contoh jawaban, hanya baris yang berubah:
AMBANG = -0.35          # selisih NDVI di bawah nilai ini dianggap kehilangan tutupan
LUAS_MIN_PIKSEL = 1     # gumpalan lebih kecil dari ini dibuang sebagai derau
Untuk ambang -0.35, layar menampilkan 118 piksel (turun dari 130), dengan 12 terlewat. Untuk luas minimum 1, layar menampilkan Piksel terdeteksi menurut kelas acuan: {'Pertanian': 1, 'Deforestasi': 130}, jadi piksel salah itu ada di kelas Pertanian. Tiap variasi saya jalankan terpisah, dengan salah satu konstanta saja yang berubah.
Skrip 26.9: Titik patah, kapan hutan mulai hilang #
Berkas 4_2_titik_patah.py. Di dalam berkasnya tertulis "SKRIP 4.2".
Tujuan. Mencari kapan tiap piksel hutan mulai hilang: NDVI turun jauh dari dasarnya pada beberapa pengamatan bersih berturut-turut. Lalu menyimpan tanggalnya dan membandingkannya dengan tanggal sebenarnya.
Bahan. Citra mentah (lewat m3_umum.py), peta acuan (Acuan_Dinamika.tif dan Acuan_Perubahan.tif), dan mask_hti.tif dari Skrip 26.8. Skrip ini tidak memakai QGIS. Jalankan dari Konsol atau terminal.
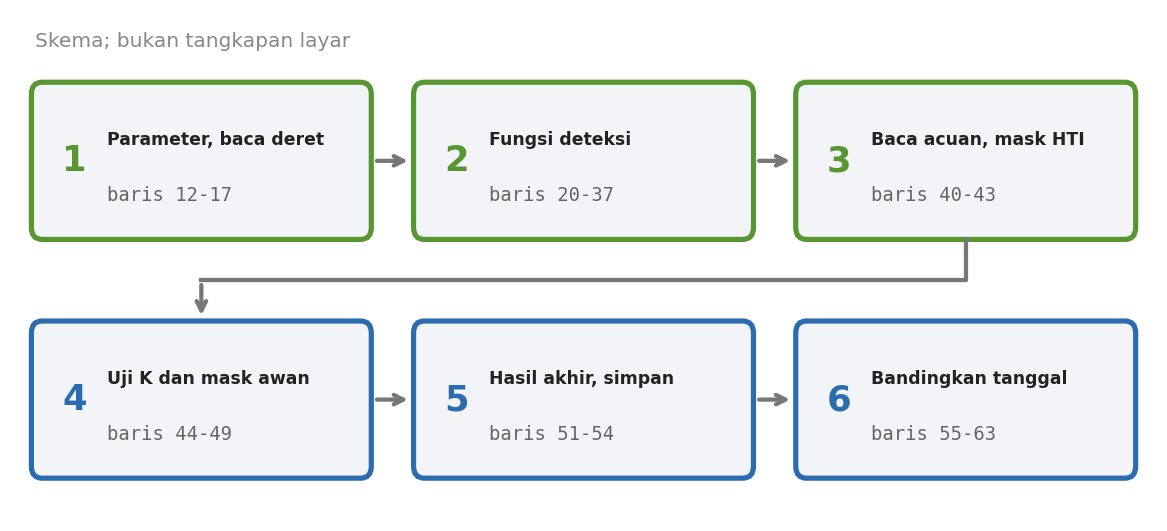
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 4.2: Deteksi titik patah pada deret waktu NDVI: kapan hutan mulai hilang?
# Penulis: Badar Mubarok Yogaswara
# Aturan: dasar = median 6 pengamatan bersih pertama. Perubahan = NDVI turun lebih dari AMBANG dari dasar
# pada K pengamatan bersih berturut-turut. Tanggal perubahan = pengamatan pertama dalam rangkaian itu.
import datetime as dt
import os
import numpy as np
from osgeo import gdal
import m3_umum as U

AMBANG, K, N_DASAR = 0.25, 3, 6
tgl, refl, scl, gt, prj = U.baca_deret()
ndvi = U.nilai_ndvi(refl)
bersih = U.bersih(scl)
T, H, W = ndvi.shape
hari = np.array([(t - tgl[0]).days for t in tgl])


def deteksi(pakai_mask, ambang=AMBANG, k=K):
    ok = bersih if pakai_mask else np.ones_like(bersih)
    hasil = np.full((H, W), -1)            # indeks tanggal awal perubahan, -1 = tidak ada
    for i in range(H):
        for j in range(W):
            idx = np.where(ok[:, i, j])[0]
            if len(idx) < N_DASAR + k:
                continue
            dasar = np.median(ndvi[idx[:N_DASAR], i, j])
            if dasar < 0.7:                # hanya piksel yang awalnya berhutan
                continue
            deret = ndvi[idx[N_DASAR:], i, j]
            turun = deret < dasar - ambang
            for n in range(len(turun) - k + 1):
                if turun[n:n + k].all():
                    hasil[i, j] = idx[N_DASAR + n]
                    break
    return hasil


din, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
per, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Perubahan.tif"))
hti, _, _ = U.baca_tif(os.path.join(U.HASIL, "mask_hti.tif"))     # dibuat Skrip 4.1
benar = per == 1
print("K  mask-awan  tepat salah(di luar HTI) lewat")
for pakai in (False, True):
    for k in (1, 2, 3):
        h = deteksi(pakai, k=k) >= 0
        h = h & (hti == 0)
        print("%d  %-9s  %5d %5d %5d" % (k, "ya" if pakai else "tidak", (h & benar).sum(), (h & ~benar).sum(), (~h & benar).sum()))

idx = deteksi(True)
flag = (idx >= 0) & (hti == 0)
keluar = np.where(flag, np.array([int(tgl[i].strftime("%Y%m%d")) if i >= 0 else 0 for i in idx.ravel()]).reshape(H, W), 0).astype("int32")
U.tulis_tif(os.path.join(U.HASIL, "tanggal_deforestasi.tif"), keluar, gt, prj, nodata=0, tipe=gdal.GDT_Int32)
# tanggal sebenarnya (acuan): bukaan 1 pada 2024-10-28, bukaan 2 pada 2025-06-05
benar_tgl = {"Bukaan 1 (Gamma)": (dt.date(2024, 10, 28), benar & (np.mgrid[0:H, 0:W][0] < 20)),
             "Bukaan 2 (Alpha)": (dt.date(2025, 6, 5), benar & (np.mgrid[0:H, 0:W][0] >= 20))}
for nama, (tg, m) in benar_tgl.items():
    terdeteksi = [tgl[idx[i, j]] for i, j in zip(*np.where(m & flag))]
    tunda = [(d - tg).days for d in terdeteksi]
    pertama = min(terdeteksi)
    print("%s: tanggal sebenarnya %s | terdeteksi %d piksel | tanggal terdeteksi paling awal %s, paling akhir %s | tunda rata-rata %.0f hari"
          % (nama, tg, len(terdeteksi), pertama, max(terdeteksi), np.mean(tunda)))
Penjelasan baris demi baris. Fungsi deteksi adalah inti skrip ini, jadi diuraikan lebih rinci.
| Baris | Tulisan | Artinya |
|---|---|---|
| 4-5 | komentar # Aturan: ... | Aturan dalam kata-kata: dasar adalah median enam pengamatan bersih pertama. Perubahan terjadi bila NDVI turun lebih dari AMBANG dari dasar pada K pengamatan bersih berturut-turut. |
| 6-10 | import datetime as dt sampai import m3_umum as U | Perkakas. datetime diberi nama pendek dt. from osgeo import gdal (baris 9) dipakai untuk nama tipe data di baris 54. |
| 12 | AMBANG, K, N_DASAR = 0.25, 3, 6 | Tiga konstanta dalam satu baris: ambang penurunan, jumlah pengamatan berturut-turut, dan jumlah pengamatan untuk dasar. |
| 13-15 | tgl, refl, scl, gt, prj = ... dan dua baris di bawahnya | Baca deret, hitung NDVI, dan buat larik penanda bersih. Kotak bersih di sini adalah larik, bukan fungsi. |
| 16-17 | T, H, W = ndvi.shape dan hari = ... | Ukuran data, dan hari ke-berapa tiap tanggal. |
| 20 | def deteksi(pakai_mask, ambang=AMBANG, k=K): | Fungsi dengan tiga masukan. Dua yang terakhir punya nilai bawaan: bila tidak diisi, dipakai konstanta di atas (Bab 7). |
| 21 | ok = bersih if pakai_mask else np.ones_like(bersih) | Bila pakai_mask benar, pakai penanda bersih. Bila tidak, anggap semua pengamatan baik (larik berisi benar semua). |
| 22 | hasil = np.full((H, W), -1) | Larik hasil berisi -1, artinya "belum ada perubahan". |
| 23-24 | for i in range(H): dan for j in range(W): | Kunjungi tiap piksel. |
| 25 | idx = np.where(ok[:, i, j])[0] | Daftar nomor tanggal yang boleh dipakai di piksel ini. |
| 26-27 | if len(idx) < N_DASAR + k: lalu continue | Bila pengamatan terlalu sedikit, lewati piksel ini dan lanjut ke piksel berikutnya. |
| 28 | dasar = np.median(ndvi[idx[:N_DASAR], i, j]) | Dasar: median dari enam pengamatan bersih pertama. |
| 29-30 | if dasar < 0.7: lalu continue | Hanya piksel yang awalnya berhutan (NDVI dasar sekurang-kurangnya 0,7) yang diperiksa. |
| 31 | deret = ndvi[idx[N_DASAR:], i, j] | Sisa pengamatan bersih setelah enam yang pertama. |
| 32 | turun = deret < dasar - ambang | Larik benar atau salah: benar bila nilai lebih rendah dari dasar dikurangi ambang. |
| 33-36 | for n in range(len(turun) - k + 1): sampai break | Geser jendela selebar k. Bila semua k nilai dalam jendela benar (.all()), catat nomor tanggal pertama jendela itu (baris 35) dan hentikan (break). |
| 37 | return hasil | Kembalikan larik nomor tanggal, -1 bila tidak ada. |
| 40-43 | din, _, _ = ... sampai benar = per == 1 | Baca peta kelas, peta perubahan, dan mask HTI hasil Skrip 26.8. benar adalah piksel deforestasi sebenarnya. |
| 44-49 | print("K mask-awan ...") dan dua putaran | Uji enam kombinasi: tanpa dan dengan mask awan, dengan K 1, 2, dan 3. Tiap baris menghitung tepat, salah (di luar hutan tanaman), dan terlewat. |
| 51 | idx = deteksi(True) | Jalankan hasil akhir: dengan mask awan, dengan K bawaan (3). |
| 52 | flag = (idx >= 0) & (hti == 0) | Piksel yang terdeteksi dan bukan hutan tanaman. |
| 53 | keluar = np.where(flag, np.array([...]).reshape(H, W), 0).astype("int32") | Ubah nomor tanggal menjadi angka berbentuk YYYYMMDD, misalnya 20241115. .ravel() meratakan larik, .reshape(H, W) mengembalikannya. .astype("int32") memilih bilangan bulat 32 bit. |
| 54 | U.tulis_tif(..., keluar, gt, prj, nodata=0, tipe=gdal.GDT_Int32) | Simpan ke tanggal_deforestasi.tif. nodata=0 menandai 0 sebagai "kosong". gdal.GDT_Int32 adalah tipe data bilangan bulat 32 bit, cukup untuk angka sampai sekitar dua miliar. Tanpa tipe=, tulis_tif memilih Byte (hanya 0 sampai 255) dan tanggal terpotong. Lihat Jebakan. |
| 56-57 | benar_tgl = {...} | Kamus dua bukaan: nama, tanggal sebenarnya, dan wilayah piksel. np.mgrid[0:H, 0:W][0] < 20 memilih baris bernomor kurang dari 20 (Gamma). Yang kedua memakai >= 20 (Alpha). |
| 58-60 | for nama, (tg, m) in benar_tgl.items(): | Untuk tiap bukaan, kumpulkan tanggal terdeteksi tiap piksel dan hitung selisih harinya dari tanggal sebenarnya (tunda). |
| 61 | pertama = min(terdeteksi) | Tanggal terdeteksi paling awal. |
| 62-63 | print("%s: tanggal sebenarnya %s ...") | Cetak ringkasan: jumlah piksel, tanggal paling awal dan paling akhir, dan rata-rata tundaan. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
K  mask-awan  tepat salah(di luar HTI) lewat
1  tidak        128   873     2
2  tidak        128   593     2
3  tidak        128   156     2
1  ya           130    92     0
2  ya           130     8     0
3  ya           130     0     0
Bukaan 1 (Gamma): tanggal sebenarnya 2024-10-28 | terdeteksi 100 piksel | tanggal terdeteksi paling awal 2024-11-15, paling akhir 2025-01-14 | tunda rata-rata 24 hari
Bukaan 2 (Alpha): tanggal sebenarnya 2025-06-05 | terdeteksi 30 piksel | tanggal terdeteksi paling awal 2025-06-18, paling akhir 2025-06-18 | tunda rata-rata 13 hari
Bacalah tabel enam baris itu. Tanpa mask awan dan dengan K = 1, ada 873 piksel salah: satu awan saja sudah dianggap hutan hilang. Dengan mask awan dan K = 3, salahnya nol dan semua 130 piksel benar. Dua syarat itu, yaitu membuang awan dan menunggu beberapa pengamatan berturut-turut, mengubah hasil total. Tundaan rata-rata 24 hari untuk bukaan Gamma kemungkinan berasal dari selang antar citra yang sekitar 30 hari dan dari tiga pengamatan yang harus ditunggu [kemungkinan].
Bagian yang boleh diubah.
- Baris 12,
K. Ubah ke2. Hasil akhir bertambah dari 130 menjadi 138 piksel bertanggal, karena delapan piksel salah ikut masuk (sama seperti baris2 yadi tabel uji). Saya menambahkanprint("Piksel bertanggal:", int(flag.sum()))di akhir untuk melihat angkanya. - Baris 12,
AMBANG. Makin kecil, makin peka tetapi makin mudah tertipu. - Baris 29,
0.7. Batas NDVI hutan untuk dasar.
Jebakan.
Tipe data harus disebut sendiri (baris 54). Fungsi U.tulis_tif memilih Byte untuk semua larik non-desimal (m3_umum.py baris 65-66). Byte hanya memuat 0 sampai 255, jadi bilangan seperti 20241115 akan terpotong menjadi 255. Karena itu baris 54 menyebut tipe=gdal.GDT_Int32. Saya memeriksa berkas hasil dengan potongan ini:
from osgeo import gdal
import numpy as np
a = gdal.Open(r"D:/Latihan_M3/hasil/tanggal_deforestasi.tif")
print(gdal.GetDataTypeName(a.GetRasterBand(1).DataType), np.unique(a.ReadAsArray()))Int32 [ 0 20241115 20241220 20250114 20250618]Lima nilai itu benar: nol untuk tidak ada perubahan, ditambah empat tanggal. Tanpa tipe=, berkas yang sama terbaca Byte [ 0 255]: semua tanggal rusak menjadi 255, dan skrip tidak mengeluh. Ringkasan di layar (baris 58-63) tidak terpengaruh karena memakai larik di memori, bukan berkas. Hanya berkas .tif yang salah. Jebakan lainnya:
min()pada daftar kosong menimbulkan galat. Saya menggantiAMBANGmenjadi0.99, sehingga tidak ada piksel terdeteksi. Layar menampilkanValueError: min() iterable argument is emptydi baris 61.- Skrip 26.8 harus sudah jalan. Di folder kosong, layar menampilkan
RuntimeError: ...mask_hti.tif: No such file or directory. - Tanggal sebenarnya dan pembagian wilayah dikunci di kode. Baris 56-57 hanya cocok dengan data contoh.
- Putaran per piksel lambat untuk raster besar, seperti di Skrip 26.6.
Latihan variasi.
- Ubah
Kmenjadi 2 dan lihat berapa piksel bertanggal. - Hapus
tipe=gdal.GDT_Int32dari baris 54, jalankan ulang, lalu periksa tipe berkasnya.
Contoh jawaban nomor 2, satu perubahan pada baris 54. Buang tipe:
U.tulis_tif(os.path.join(U.HASIL, "tanggal_deforestasi.tif"), keluar, gt, prj, nodata=0)Layar tidak menampilkan galat. Memeriksa berkas dengan potongan di Jebakan, layar menampilkan Byte [ 0 255]: semua tanggal terpotong menjadi 255. Kembalikan tipe=gdal.GDT_Int32 setelah mencoba. Angka K=2 untuk nomor 1 adalah 138.
Kelompok E: Jejak api #
Konsep: arang yang menyerap hijau #
Tumbuhan sehat memantulkan banyak inframerah dekat dan sedikit inframerah gelombang pendek. Setelah terbakar, keadaannya terbalik, seperti arang yang menelan cahaya. Indeks NBR menangkap pembalikan itu. Selisih NBR antara sebelum dan sesudah kebakaran, yaitu dNBR, menunjukkan seberapa parah terbakarnya.
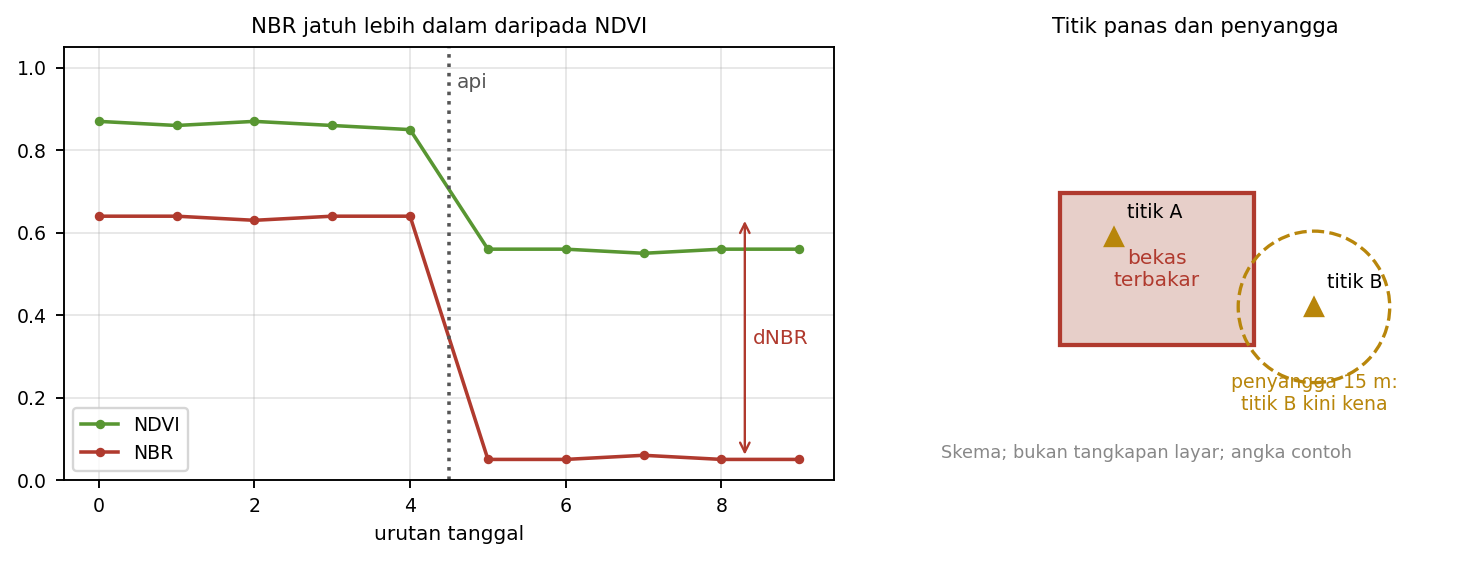
Lima istilah yang perlu Anda kenal sekarang:
- SWIR: inframerah gelombang pendek. Di Sentinel-2, SWIR2 adalah band B12.
- NBR: (inframerah dekat dikurangi SWIR2) dibagi (inframerah dekat ditambah SWIR2).
- dNBR: NBR sebelum dikurangi NBR sesudah. Makin besar, makin parah.
- Titik panas (hotspot): titik deteksi suhu tinggi oleh satelit. Titik panas adalah petunjuk api, bukan peta bekas bakar.
- Penyangga (buffer): daerah selebar jarak tertentu di sekeliling sebuah objek.
Mengapa NBR, bukan NDVI saja? Pada contoh grafik di atas, NDVI hanya turun sekitar 0,3, sedangkan NBR turun hampir 0,6. Gerakan yang lebih besar lebih mudah dibedakan dari derau.
Skrip 26.10: Bekas kebakaran dengan dNBR #
Berkas 5_1_dnbr.py. Di dalam berkasnya tertulis "SKRIP 5.1".
Tujuan. Memetakan bekas kebakaran dua kejadian (September 2024 di KPH Beta, Agustus 2025 di KPH Gamma) dengan NBR dan dNBR, menguji beberapa ambang, dan menyimpan peta akhir.
Bahan. Citra mentah (berkas _refl.tif dan _SCL.tif), acuan/Acuan_Dinamika.tif, acuan/Tutupan_Awal.tif, dan m3_umum.py. Skrip ini tidak memerlukan skrip lain. Jalankan dari Konsol atau terminal.
Skrip ini panjang. Gambar berikut membaginya menjadi delapan tahap.
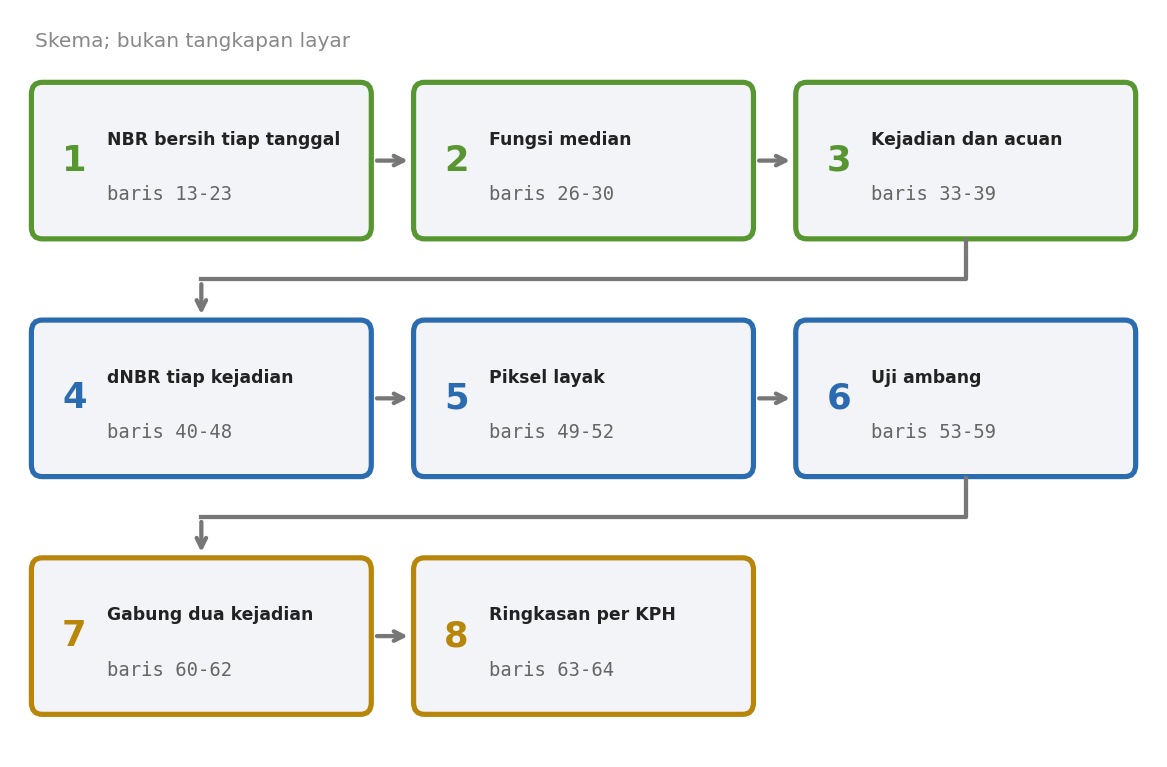
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 5.1: Bekas kebakaran dengan NBR dan dNBR (dua kejadian: September 2024 dan Agustus 2025)
# Penulis: Badar Mubarok Yogaswara
# NBR = (NIR - SWIR2) / (NIR + SWIR2); untuk Sentinel-2: NIR = B08 (band 4 di berkas), SWIR2 = B12 (band 6 di berkas).
# dNBR = NBR sebelum - NBR sesudah. Makin besar, makin parah terbakar.
import os
import numpy as np
import processing
from qgis.core import QgsRasterLayer, QgsProject
import m3_umum as U

AMBANG_BAKAR = 0.10          # dNBR di atas ini dianggap bekas terbakar (lihat uji ambang di akhir keluaran)
daftar = U.daftar_citra()
os.makedirs(os.path.join(U.HASIL, "nbr_bersih"), exist_ok=True)
nbr = []
for tgl, pr, ps in daftar:
    k = tgl.strftime("%Y%m%d")
    a, s = QgsRasterLayer(pr, "R" + k), QgsRasterLayer(ps, "S" + k)
    QgsProject.instance().addMapLayers([a, s], False)
    ek = '(("R%s@4" - "R%s@6") / ("R%s@4" + "R%s@6")) / (("S%s@1" = 4) OR ("S%s@1" = 5) OR ("S%s@1" = 6))' % ((k,) * 7)
    out = os.path.join(U.HASIL, "nbr_bersih", "NBR_bersih_%s.tif" % k)
    processing.run("native:rastercalc", {"LAYERS": [a, s], "EXPRESSION": ek, "OUTPUT": out})
    nbr.append(out)


def median(idx, nama):
    out = os.path.join(U.HASIL, nama)
    processing.run("native:cellstatistics", {"INPUT": [nbr[i] for i in idx], "STATISTIC": 3, "IGNORE_NODATA": True,
                                              "REFERENCE_LAYER": nbr[idx[0]], "OUTPUT_NODATA_VALUE": -9999, "OUTPUT": out})
    return out


tg = [t for t, _, _ in daftar]
kejadian = {"2024": ([5, 6, 7], [8, 9], "Beta"), "2025": ([17, 18], [19, 20], "Gamma")}   # indeks tanggal sebelum, sesudah, KPH
din, gt, prj = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
awal, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Tutupan_Awal.tif"))
rr, cc = np.mgrid[0:40, 0:40]
kph = np.where(rr < 20, "Gamma", np.where(cc < 20, "Alpha", "Beta"))
sapuan = {}
for nama, (pre, post, wilayah) in kejadian.items():
    a, b = median(pre, "nbr_pre_%s.tif" % nama), median(post, "nbr_post_%s.tif" % nama)
    la, lb = QgsRasterLayer(a, "pre"), QgsRasterLayer(b, "post")
    QgsProject.instance().addMapLayers([la, lb], False)
    d = os.path.join(U.HASIL, "dNBR_%s.tif" % nama)
    processing.run("native:rastercalc", {"LAYERS": [la, lb], "EXPRESSION": '"pre@1" - "post@1"', "OUTPUT": d})
    dn, _, _ = U.baca_tif(d)
    pre_n, _, _ = U.baca_tif(a)
    dn = np.where(dn < -100, np.nan, dn)                      # -9999 = tidak ada data
    acuan = (din == 7) & (kph == wilayah)                     # bekas terbakar kejadian ini (KPH tempat kejadian)
    # hanya hutan dan hutan tanaman menurut peta tutupan awal, yang NBR-nya tinggi (air dan sawah dibuang: NBR-nya tidak stabil)
    layak = (pre_n >= 0.5) & np.isin(awal, (1, 2))
    print("Kejadian %s (KPH %s): sebelum %s s.d. %s, sesudah %s s.d. %s" % (nama, wilayah, tg[pre[0]], tg[pre[-1]], tg[post[0]], tg[post[-1]]))
    print("  dNBR rata-rata di bekas terbakar acuan %.2f; di hutan stabil %.2f; acuan %d piksel (%.2f ha)"
          % (np.nanmean(dn[acuan]), np.nanmean(dn[din == 1]), acuan.sum(), acuan.sum() * 0.01))
    print("  ambang   terdeteksi(ha)  tepat salah lewat  presisi kepekaan")
    for amb in (0.05, 0.10, 0.20, 0.27, 0.44):
        bk = layak & (dn > amb)
        tp, fp, fn = (bk & acuan).sum(), (bk & ~acuan).sum(), (~bk & acuan).sum()
        print("  %5.2f   %8.2f      %4d %5d %4d    %.2f    %.2f" % (amb, bk.sum() * 0.01, tp, fp, fn, tp / max(tp + fp, 1), tp / max(tp + fn, 1)))
    sapuan[nama] = layak & (dn > AMBANG_BAKAR)
akhir = sapuan["2024"] | sapuan["2025"]
U.tulis_tif(os.path.join(U.HASIL, "bekas_bakar.tif"), akhir.astype("uint8"), gt, prj, nodata=255)
for k in ("Alpha", "Beta", "Gamma"):
    print("KPH %-6s terbakar terdeteksi %.2f ha (acuan %.2f ha)" % (k, (akhir & (kph == k)).sum() * 0.01, ((din == 7) & (kph == k)).sum() * 0.01))
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 4-5 | komentar | Rumus dalam kata-kata: NBR memakai band 4 (B08) dan band 6 (B12) di berkas. dNBR adalah NBR sebelum dikurangi NBR sesudah. |
| 6-10 | import os sampai import m3_umum as U | Perkakas, seperti sebelumnya. |
| 12 | AMBANG_BAKAR = 0.10 | Konstanta: dNBR di atas 0,10 dianggap bekas terbakar. |
| 13-15 | daftar = ..., os.makedirs(...nbr_bersih...), nbr = [] | Daftar tanggal, folder keluaran, dan daftar penampung jalur. |
| 16-17 | for tgl, pr, ps in daftar: dan k = ... | Ulangi per tanggal dengan kode tanggal. |
| 18 | a, s = QgsRasterLayer(pr, "R" + k), QgsRasterLayer(ps, "S" + k) | Buka layer refl bernama R... dan layer SCL bernama S... sekaligus, memakai penugasan ganda. |
| 19 | QgsProject.instance().addMapLayers([a, s], False) | Daftarkan keduanya ke proyek tanpa ditampilkan. |
| 20 | ek = '...' % ((k,) * 7) | Rumus NBR dibagi kondisi SCL baik (trik "bagi nol menjadi NoData" seperti Skrip 26.4). Rumus ini memuat tujuh %s. (k,) * 7 membuat tuple berisi tujuh salinan k. Jumlahnya harus pas. |
| 21-23 | out = ..., processing.run(...), nbr.append(out) | Jalankan kalkulator raster dan catat jalur hasilnya. |
| 26-30 | def median(idx, nama): | Fungsi yang menghitung komposit median NBR untuk daftar tanggal idx. Baris 28 memakai alat Cell statistics dengan STATISTIC: 3 (median). [nbr[i] for i in idx] mengambil jalur berkas tanggal-tanggal itu. Baris 30 mengembalikan jalur hasil. |
| 33 | tg = [t for t, _, _ in daftar] | Daftar tanggal saja. |
| 34 | kejadian = {"2024": ([5, 6, 7], [8, 9], "Beta"), ...} | Kamus dua kejadian. Isi tiap kejadian: nomor tanggal sebelum, nomor tanggal sesudah, dan KPH tempatnya. Nomor-nomor itu dikunci sesuai data contoh. |
| 35-36 | din, gt, prj = ... dan awal, _, _ = ... | Baca peta kelas tutupan dan peta tutupan awal. |
| 37-38 | rr, cc = np.mgrid[0:40, 0:40] dan kph = np.where(...) | Penanda KPH tiruan, seperti di Skrip 26.8. Ukuran 40 dikunci di sini. |
| 39 | sapuan = {} | Kamus kosong untuk menyimpan hasil tiap kejadian. |
| 40 | for nama, (pre, post, wilayah) in kejadian.items(): | Ulangi per kejadian dan bongkar tiga isinya. |
| 41 | a, b = median(pre, ...), median(post, ...) | Hitung komposit median NBR sebelum dan sesudah. Memakai fungsi buatan sendiri. |
| 42-45 | la, lb = ..., addMapLayers(...), d = ..., processing.run(...) | Buka kedua komposit sebagai layer pre dan post, lalu hitung "pre@1" - "post@1" sebagai dNBR. |
| 46-47 | dn, _, _ = U.baca_tif(d) dan pre_n, _, _ = U.baca_tif(a) | Baca dNBR dan NBR sebelum sebagai larik. |
| 48 | dn = np.where(dn < -100, np.nan, dn) | Nilai -9999 (tanda kosong) diubah menjadi nan, supaya tidak ikut dihitung. |
| 49 | acuan = (din == 7) & (kph == wilayah) | Bekas terbakar sebenarnya untuk kejadian ini: kelas 7 di KPH tempat kejadian. |
| 51 | layak = (pre_n >= 0.5) & np.isin(awal, (1, 2)) | Piksel yang layak diuji: NBR sebelum sekurang-kurangnya 0,5, dan tutupan awal hutan alam (1) atau hutan tanaman (2). Air dan sawah dibuang karena NBR-nya tidak stabil. |
| 52 | print("Kejadian %s (KPH %s): ...") | Cetak tanggal awal dan akhir periode sebelum dan sesudah. |
| 53-54 | print(" dNBR rata-rata di bekas terbakar acuan ...") | Cetak dNBR rata-rata di bekas bakar sebenarnya dan di hutan stabil. np.nanmean mengabaikan nan. |
| 55 | print(" ambang terdeteksi(ha) ...") | Judul tabel uji. |
| 56-59 | for amb in (0.05, 0.10, 0.20, 0.27, 0.44): | Untuk tiap ambang uji: bk adalah piksel layak dengan dNBR di atas ambang (baris 57), lalu hitung tepat, salah, terlewat, presisi, dan kepekaan seperti di Skrip 26.8. |
| 60 | sapuan[nama] = layak & (dn > AMBANG_BAKAR) | Simpan hasil kejadian ini, memakai ambang resmi 0,10. |
| 61 | akhir = sapuan["2024"] diikuti operator atau dan sapuan["2025"] | Gabungkan dua kejadian dengan operator atau (tanda garis tegak tunggal di berkas): benar bila piksel terbakar pada salah satu kejadian. |
| 62 | U.tulis_tif(..."bekas_bakar.tif"..., akhir.astype("uint8"), ..., nodata=255) | Simpan peta akhir sebagai Byte berisi 0 dan 1, nilai kosong 255. Byte memang cukup untuk 0 dan 1. |
| 63-64 | for k in ("Alpha", "Beta", "Gamma"): | Cetak luas terbakar terdeteksi tiap KPH, dibanding luas acuan. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Kejadian 2024 (KPH Beta): sebelum 2024-06-13 s.d. 2024-08-12, sesudah 2024-09-16 s.d. 2024-10-16
  dNBR rata-rata di bekas terbakar acuan 0.35; di hutan stabil -0.01; acuan 128 piksel (1.28 ha)
  ambang   terdeteksi(ha)  tepat salah lewat  presisi kepekaan
   0.05       1.38       128    10    0    0.93    1.00
   0.10       1.29       128     1    0    0.99    1.00
   0.20       1.14       114     0   14    1.00    0.89
   0.27       0.91        91     0   37    1.00    0.71
   0.44       0.30        30     0   98    1.00    0.23
Kejadian 2025 (KPH Gamma): sebelum 2025-06-18 s.d. 2025-07-18, sesudah 2025-08-17 s.d. 2025-09-21
  dNBR rata-rata di bekas terbakar acuan 0.42; di hutan stabil 0.02; acuan 23 piksel (0.23 ha)
  ambang   terdeteksi(ha)  tepat salah lewat  presisi kepekaan
   0.05       0.30        23     7    0    0.77    1.00
   0.10       0.23        23     0    0    1.00    1.00
   0.20       0.22        22     0    1    1.00    0.96
   0.27       0.19        19     0    4    1.00    0.83
   0.44       0.09         9     0   14    1.00    0.39
KPH Alpha  terbakar terdeteksi 0.01 ha (acuan 0.00 ha)
KPH Beta   terbakar terdeteksi 1.28 ha (acuan 1.28 ha)
KPH Gamma  terbakar terdeteksi 0.23 ha (acuan 0.23 ha)
Baca per kejadian. Pada ambang 0,10, kejadian 2024 mendapat 128 piksel tepat, hanya satu salah, dan tidak ada yang terlewat. Kejadian 2025 mendapat 23 piksel, semuanya tepat. Makin tinggi ambang, makin banyak yang terlewat: pada 0,44 kepekaan tinggal 0,23 dan 0,39. Angka uji 0,27 dan 0,44 berasal dari kelas keparahan literatur yang dimuat di Buku M3, dan literatur itu berasal dari hutan di wilayah lain. Pada data ini, ambang terbaik justru 0,10. Kalibrasi ambang dengan data Anda sendiri. Baris KPH Alpha mencatat satu piksel salah tambah (0,01 hektare), karena Alpha tidak punya bekas terbakar sama sekali.
Bagian yang boleh diubah.
- Baris 12,
AMBANG_BAKAR. Saya mengubahnya menjadi0.20. Layar menampilkanKPH Beta terbakar terdeteksi 1.14 ha (acuan 1.28 ha)danKPH Gamma terbakar terdeteksi 0.22 ha (acuan 0.23 ha), dan Alpha kini0.00 ha. Satu piksel salah di Alpha hilang, tetapi 14 piksel Beta terlewat. - Baris 34, nomor tanggal. Pilih tanggal sebelum dan sesudah untuk kejadian Anda. Nomor mulai dari 0.
- Baris 51, syarat
layak. Longgarkan atau ketatkan batas 0,5 dan kelas tutupan. - Baris 56, daftar ambang uji. Tambah atau kurangi angkanya.
Jebakan.
- Rumus di baris 20 sangat panjang. Jumlah
%sharus sama dengan jumlah isian. Saya mengubah* 7menjadi* 6, dan layar menampilkanTypeError: not enough arguments for format string. Pesan ini bagus: ia langsung menunjuk masalahnya. - Banyak hal dikunci. Nomor tanggal di baris 34, ukuran 40 kali 40 di baris 37, pembagian KPH di baris 38, dan luas 0,01 hektare per piksel di baris 54, 59, dan 64. Semuanya hanya benar untuk data contoh.
- Nilai -9999 dianggap kosong. Baris 48 menganggap setiap dNBR di bawah -100 sebagai kosong. Bila data Anda memakai tanda kosong lain, ganti.
- Variabel
a,b, dankdipakai ulang. Namaadanbdi baris 41 berbeda artinya dari baris 18. Python mengizinkannya, tetapi mudah membingungkan. - Pembaca dari terminal. Skrip ini memanggil alat QGIS 30 kali, jadi dari terminal butuh persiapan Bab 3.
Latihan variasi.
- Naikkan
AMBANG_BAKARmenjadi0.20. - Bandingkan luas terbakar per KPH dengan hasil asli.
Contoh jawaban, hanya baris 12:
AMBANG_BAKAR = 0.20 # dNBR di atas ini dianggap bekas terbakar (lihat uji ambang di akhir keluaran)Tiga baris terakhir layar menjadi KPH Alpha terbakar terdeteksi 0.00 ha (acuan 0.00 ha), KPH Beta terbakar terdeteksi 1.14 ha (acuan 1.28 ha), dan KPH Gamma terbakar terdeteksi 0.22 ha (acuan 0.23 ha). Hasil asli (0,10) adalah 0,01; 1,28; dan 0,23 hektare. Ambang yang lebih tinggi menghilangkan salah tambah, tetapi menambah yang terlewat.
Skrip 26.11: Mencocokkan titik panas dan memperkirakan tanggal terbakar #
Berkas 5_2_titik_panas.py. Di dalam berkasnya tertulis "SKRIP 5.2".
Tujuan. Mengubah peta bekas bakar menjadi poligon, mencocokkan titik panas dengan poligon itu (dengan dan tanpa penyangga), memperkirakan tanggal terbakar tiap piksel, dan membandingkannya dengan tanggal titik panas.
Bahan. bekas_bakar.tif dari Skrip 26.10, vektor/Hotspot_Bertanggal.gpkg (12 titik panas, kolom ID_Titik dan TANGGAL), dan m3_umum.py. Jalankan dari Konsol atau terminal.
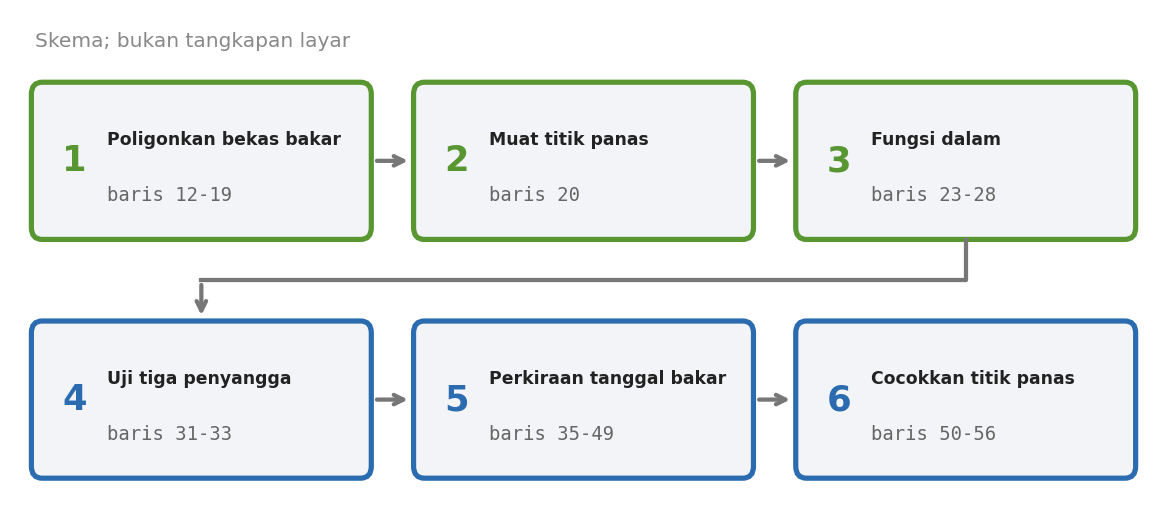
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 5.2: Cocokkan titik panas dengan bekas terbakar, perkirakan tanggal terbakar, hitung luas per KPH
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 5.1 sudah dijalankan (hasil/bekas_bakar.tif).
import datetime as dt
import os
import numpy as np
import processing
from qgis.core import QgsVectorLayer
import m3_umum as U

bakar = os.path.join(U.HASIL, "bekas_bakar.tif")
poli = os.path.join(U.HASIL, "bekas_bakar.gpkg")
if os.path.exists(poli):
    os.remove(poli)                  # polygonize ke GPKG yang sudah ada MENAMBAH fitur, bukan menimpa
processing.run("gdal:polygonize", {"INPUT": bakar, "BAND": 1, "FIELD": "DN", "EIGHT_CONNECTEDNESS": True, "OUTPUT": poli})
lp = QgsVectorLayer(poli + "|layername=bekas_bakar", "bekas_bakar")
lp.setSubsetString('"DN" = 1')                                       # hanya gumpalan terbakar (bukan latar)
print("Poligon bekas terbakar:", lp.featureCount())
hs = QgsVectorLayer(os.path.join(U.PAKET, "vektor", "Hotspot_Bertanggal.gpkg"), "hotspot")


def dalam(jarak):
    sumber = hs
    if jarak > 0:
        sumber = processing.run("native:buffer", {"INPUT": hs, "DISTANCE": jarak, "SEGMENTS": 8, "OUTPUT": "TEMPORARY_OUTPUT"})["OUTPUT"]
    r = processing.run("native:extractbylocation", {"INPUT": sumber, "PREDICATE": [0], "INTERSECT": lp, "OUTPUT": "TEMPORARY_OUTPUT"})["OUTPUT"]
    return sorted(f["ID_Titik"] for f in r.getFeatures())


for j in (0, 15, 30):
    ids = dalam(j)
    print("Titik panas di dalam bekas terbakar (penyangga %d m): %d dari %d -> %s" % (j, len(ids), hs.featureCount(), ", ".join(ids)))

# perkiraan tanggal terbakar per piksel: pengamatan bersih pertama dengan NBR turun lebih dari 0.2 dari dasar (3 pengamatan awal bersih)
tgl, refl, scl, gt, prj = U.baca_deret()
nbr = U.nilai_nbr(refl)
ok = U.bersih(scl)
b, _, _ = U.baca_tif(bakar)
tanggal_bakar = {}
for i, j in zip(*np.where(b == 1)):
    idx = np.where(ok[:, i, j])[0]
    dasar = np.median(nbr[idx[:3], i, j])
    for t in idx[3:]:
        if nbr[t, i, j] < dasar - 0.2:
            tanggal_bakar[(i, j)] = tgl[t]
            break
from collections import Counter
print("Perkiraan tanggal terbakar (jumlah piksel):", dict(sorted(Counter(tanggal_bakar.values()).items())))
# hubungan dengan titik panas
for f in hs.getFeatures():
    p = f.geometry().asPoint()
    i, j = U.xy_ke_piksel(gt, p.x(), p.y())
    tg_h = dt.date.fromisoformat(f["TANGGAL"])
    tb = tanggal_bakar.get((i, j))
    print("%s %s -> %s" % (f["ID_Titik"], tg_h, ("bekas terbakar, tanggal perkiraan %s (selisih %d hari)" % (tb, (tb - tg_h).days)) if tb else "tidak ada bekas terbakar di pikselnya"))
Penjelasan baris demi baris. Baris 11, 21-22, 29-30, dan 34 kosong.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-10 | import datetime as dt sampai import m3_umum as U | Perkakas. QgsVectorLayer adalah layer vektor. |
| 12-13 | bakar = ... dan poli = ... | Jalur peta bekas bakar (raster) dan jalur hasil poligon. |
| 14-15 | if os.path.exists(poli): lalu os.remove(poli) | Hapus berkas lama. os.path.exists bertanya apakah berkas sudah ada (Bab 8). Bila ada, os.remove menghapusnya. Alat Polygonize menambah poligon ke GeoPackage yang sudah ada dan tidak menimpanya, jadi tanpa dua baris ini jalan kedua menggandakan poligon. |
| 16 | processing.run("gdal:polygonize", {...}) | Ubah raster menjadi poligon. FIELD: "DN" memberi nama kolom nilai piksel. EIGHT_CONNECTEDNESS: True menyatukan piksel yang bersentuhan di sudut. |
| 17 | lp = QgsVectorLayer(poli + "...layername=bekas_bakar", "bekas_bakar") | Buka poligon sebagai layer. Teks sumber memakai garis tegak lalu nama layer di dalam berkas (pola yang sama dengan Bab 15). Penyedia tidak disebut, dan QGIS memakai bawaannya (ogr). |
| 18 | lp.setSubsetString('"DN" = 1') | Pasang filter: hanya poligon bernilai 1 (terbakar), bukan latar belakang. |
| 19 | print("Poligon bekas terbakar:", lp.featureCount()) | Cetak jumlah poligon terbakar. |
| 20 | hs = QgsVectorLayer(...Hotspot_Bertanggal.gpkg, "hotspot") | Buka layer titik panas. |
| 23 | def dalam(jarak): | Fungsi dengan satu masukan: jarak penyangga dalam meter. |
| 24 | sumber = hs | Awalnya sumbernya titik panas apa adanya. |
| 25-26 | if jarak > 0: lalu sumber = processing.run("native:buffer", {...})["OUTPUT"] | Bila jarak lebih dari nol, buat penyangga dari tiap titik. SEGMENTS: 8 mengatur kehalusan lingkaran. "TEMPORARY_OUTPUT" menyimpan hasil di memori. Kurung siku ["OUTPUT"] mengambil layer dari hasil alat. |
| 27 | r = processing.run("native:extractbylocation", {...})["OUTPUT"] | Pilih titik atau penyangga yang bersinggungan dengan poligon terbakar. PREDICATE: [0] berarti "bersinggungan" (intersect). Saya memeriksanya di bantuan alat. |
| 28 | return sorted(f["ID_Titik"] for f in r.getFeatures()) | Kembalikan daftar ID titik terpilih, terurut. |
| 31-33 | for j in (0, 15, 30): dan dua baris di bawahnya | Uji tiga penyangga: 0, 15, dan 30 meter. Cetak berapa titik panas yang cocok. ", ".join(ids) menyambung daftar ID dengan koma. |
| 36-38 | tgl, refl, scl, gt, prj = U.baca_deret() dan dua baris di bawahnya | Baca deret, hitung NBR, dan penanda bersih. |
| 39 | b, _, _ = U.baca_tif(bakar) | Baca peta bekas bakar sebagai larik. |
| 40 | tanggal_bakar = {} | Kamus kosong: kuncinya pasangan (baris, kolom), isinya tanggal. |
| 41 | for i, j in zip(*np.where(b == 1)): | np.where(b == 1) memberi dua daftar: nomor baris dan nomor kolom piksel terbakar. zip(*...) menyandingkannya menjadi pasangan (i, j). |
| 42-43 | idx = ... dan dasar = np.median(nbr[idx[:3], i, j]) | Pengamatan bersih piksel ini, dan dasar NBR dari tiga pengamatan bersih pertama. |
| 44-47 | for t in idx[3:]: sampai break | Cari pengamatan bersih pertama yang NBR-nya turun lebih dari 0,2 dari dasar. Catat tanggalnya dan berhenti. |
| 48 | from collections import Counter | Impor di tengah berkas. Counter menghitung berapa kali tiap nilai muncul. Boleh, tetapi biasanya impor ditaruh di atas. |
| 49 | print("Perkiraan tanggal terbakar ...", dict(sorted(Counter(...).items()))) | Hitung berapa piksel terbakar menurut tiap tanggal perkiraan, lalu cetak sebagai kamus terurut. |
| 51-52 | for f in hs.getFeatures(): dan p = f.geometry().asPoint() | Untuk tiap titik panas, ambil koordinatnya. |
| 53 | i, j = U.xy_ke_piksel(gt, p.x(), p.y()) | Ubah koordinat menjadi nomor baris dan kolom piksel. |
| 54 | tg_h = dt.date.fromisoformat(f["TANGGAL"]) | Ubah teks tanggal titik panas menjadi objek tanggal. |
| 55 | tb = tanggal_bakar.get((i, j)) | Cari tanggal perkiraan terbakar di piksel itu. .get mengembalikan None (kosong) bila tidak ada. |
| 56 | print("%s %s -> %s" % (..., (... if tb else ...))) | Cetak ID, tanggal titik panas, lalu pesan. Bila tb ada: tanggal perkiraan dan selisih harinya. Bila tidak: "tidak ada bekas terbakar di pikselnya". |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Poligon bekas terbakar: 4
Titik panas di dalam bekas terbakar (penyangga 0 m): 4 dari 12 -> HS-006, HS-009, HS-010, HS-011
Titik panas di dalam bekas terbakar (penyangga 15 m): 7 dari 12 -> HS-002, HS-004, HS-005, HS-006, HS-009, HS-010, HS-011
Titik panas di dalam bekas terbakar (penyangga 30 m): 8 dari 12 -> HS-002, HS-004, HS-005, HS-006, HS-009, HS-010, HS-011, HS-012
Perkiraan tanggal terbakar (jumlah piksel): {datetime.date(2024, 9, 16): 122, datetime.date(2024, 10, 16): 2, datetime.date(2025, 8, 17): 23}
HS-001 2024-10-27 -> tidak ada bekas terbakar di pikselnya
HS-002 2025-08-11 -> tidak ada bekas terbakar di pikselnya
HS-003 2024-10-27 -> tidak ada bekas terbakar di pikselnya
HS-004 2024-09-03 -> tidak ada bekas terbakar di pikselnya
HS-005 2024-09-05 -> tidak ada bekas terbakar di pikselnya
HS-006 2024-09-04 -> bekas terbakar, tanggal perkiraan 2024-09-16 (selisih 12 hari)
HS-007 2024-10-28 -> tidak ada bekas terbakar di pikselnya
HS-008 2025-03-14 -> tidak ada bekas terbakar di pikselnya
HS-009 2024-09-04 -> bekas terbakar, tanggal perkiraan 2024-09-16 (selisih 12 hari)
HS-010 2025-08-12 -> bekas terbakar, tanggal perkiraan 2025-08-17 (selisih 5 hari)
HS-011 2024-09-04 -> bekas terbakar, tanggal perkiraan 2024-09-16 (selisih 12 hari)
HS-012 2025-03-14 -> tidak ada bekas terbakar di pikselnya
Dengan penyangga 0 meter, hanya 4 dari 12 titik panas jatuh di dalam bekas terbakar. Dengan penyangga 30 meter, 8 titik. Empat titik terakhir tetap di luar. Saya memeriksa kelas acuan di piksel tiap titik: HS-001 dan HS-007 jatuh di piksel deforestasi, dan bertanggal akhir Oktober 2024, saat bukaan Gamma terjadi (28 Oktober 2024). Jadi titik panas tidak selalu berarti kebakaran. Pembukaan lahan bisa ikut menyalakannya [kemungkinan]. Tanggal perkiraan terbakar selalu sesudah tanggal titik panas (selisih 12 dan 5 hari), karena tanggal itu adalah citra bersih pertama yang menunjukkan penurunan, sedangkan titik panas dideteksi saat api menyala.
Bagian yang boleh diubah.
- Baris 31, daftar penyangga. Saya mengganti menjadi
(0, 50): layar menampilkanpenyangga 50 m: 9 dari 12(IDHS-002, 004, 005, 006, 008, 009, 010, 011, 012). - Baris 45,
0.2. Ambang penurunan NBR untuk tanggal terbakar. - Baris 43 dan 44, angka 3. Jumlah pengamatan dasar. Jangan lebih besar dari jumlah pengamatan bersih yang ada.
Jebakan.
- Alat Polygonize menambah, bukan menimpa. Itu sebabnya baris 14-15 menghapus
bekas_bakar.gpkglebih dulu. Saya menjalankan skrip dua kali di folder yang sama, dan kedua putaran mencetakPoligon bekas terbakar: 4. Tanpa dua baris itu, putaran kedua mencetak 8, karena poligon baru ditumpuk di atas yang lama. Bila Windows menolak penghapusan karena berkas itu masih terbuka sebagai layer di QGIS,os.removegagal denganPermissionError: [WinError 32](diuji; layer di kanvas jendela QGIS tidak diuji). Hapus layernya dari proyek, lalu jalankan ulang. - Skrip 26.10 harus sudah jalan. Di folder kosong, layar menampilkan
QgsProcessingException: Unable to execute algorithmdanCould not load source layer for INPUT: ...bekas_bakar.tif not found. - Nama
jdipakai dua kali. Baris 31 dan baris 41 sama-sama memakaij. Keduanya berurutan, jadi aman. Namun menamai ulang salah satunya mencegah kekacauan bila skrip dikembangkan. - Penyangga yang terlalu lebar tidak bermakna. Area contoh hanya 400 meter kali 400 meter. Saya mencoba
(0, 100, 200): layar menampilkan 4, 10, dan 12 dari 12. Pada 200 meter semua titik "cocok", tanpa arti. - Butuh minimal tiga pengamatan bersih. Baris 43 dan 44 mengandaikan
idxsekurang-kurangnya sepanjang tiga.
Latihan variasi.
- Ganti penyangga menjadi
(0, 50). - Catat titik panas yang baru masuk pada 50 meter, dibandingkan 30 meter.
Contoh jawaban, hanya baris 31:
for j in (0, 50):Layar menampilkan penyangga 0 m: 4 dari 12 dan penyangga 50 m: 9 dari 12 -> HS-002, HS-004, HS-005, HS-006, HS-008, HS-009, HS-010, HS-011, HS-012. Pada 30 meter daftarnya delapan ID. Titik baru pada 50 meter: HS-008. Setelah itu coba ingat: HS-008 bertanggal 14 Maret 2025, sedangkan kebakaran di data ini terjadi September 2024 dan Agustus 2025. Cocok dalam jarak, tidak cocok dalam waktu.
Kelompok F: Mesin yang belajar dari contoh #
Konsep: panitia juri dalam tiga kalimat #
Sebuah pohon keputusan itu seperti permainan tebak-tebakan bercabang: "NBR minimumnya di bawah 0,2? Ya, maka terbakar." Sebuah hutan acak adalah ratusan pohon yang masing-masing belajar dari contoh dan fitur yang sedikit berbeda, lalu memberi suara. Kelas dengan suara terbanyak menang, seperti keputusan panitia yang lebih dapat dipercaya daripada satu juri.
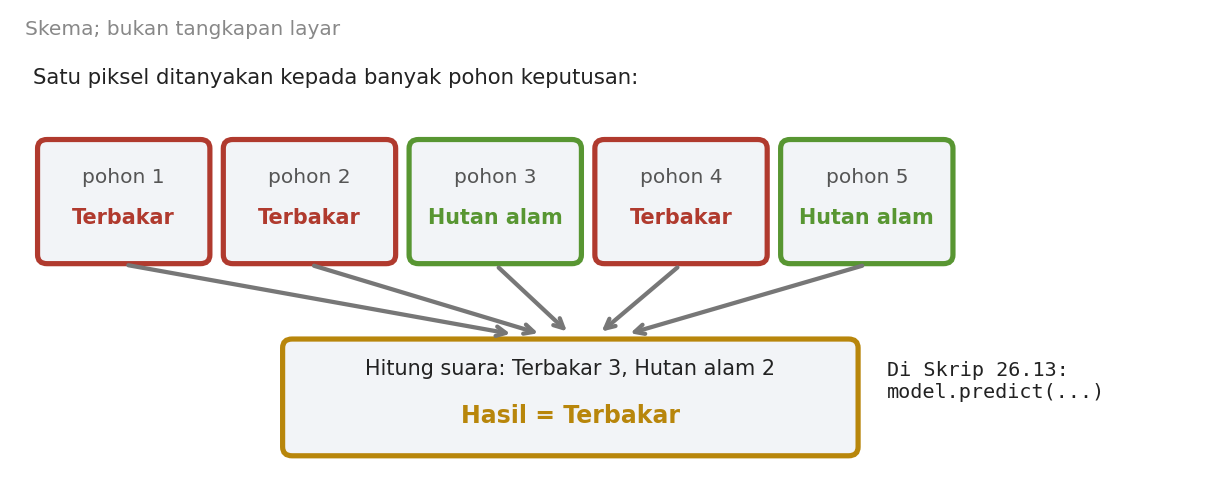
Lima istilah yang perlu Anda kenal sekarang:
- Titik latih: titik yang kelasnya sudah diketahui, dipakai mesin untuk belajar. Paket data punya 200 titik, 25 untuk tiap dari delapan kelas.
- Pohon keputusan: aturan bercabang "jika... maka...".
- Hutan acak (random forest): banyak pohon yang memberi suara.
- Uji silang: melatih mesin pada sebagian titik, lalu mengujinya pada titik yang tidak ikut dilatih.
- Kepentingan fitur: seberapa sering sebuah fitur dipakai pohon untuk memisahkan kelas.
Di bab ini, bahan belajar mesin adalah dua belas fitur per piksel, yang dibuat dari riwayat NDVI, NBR, dan SWIR1. Itu pekerjaan Skrip 26.12.
Skrip 26.12: Menyusun dua belas fitur #
Berkas 6_1_fitur_deret.py. Di dalam berkasnya tertulis "SKRIP 6.1".
Tujuan. Menyusun 12 fitur ringkas per piksel dari deret NDVI, NBR, dan SWIR1 yang sudah ditambal, sebagai bahan machine learning.
Bahan. Citra mentah lewat m3_umum.py. Skrip ini tidak memakai QGIS dan tidak memerlukan skrip lain. Jalankan dari Konsol atau terminal.
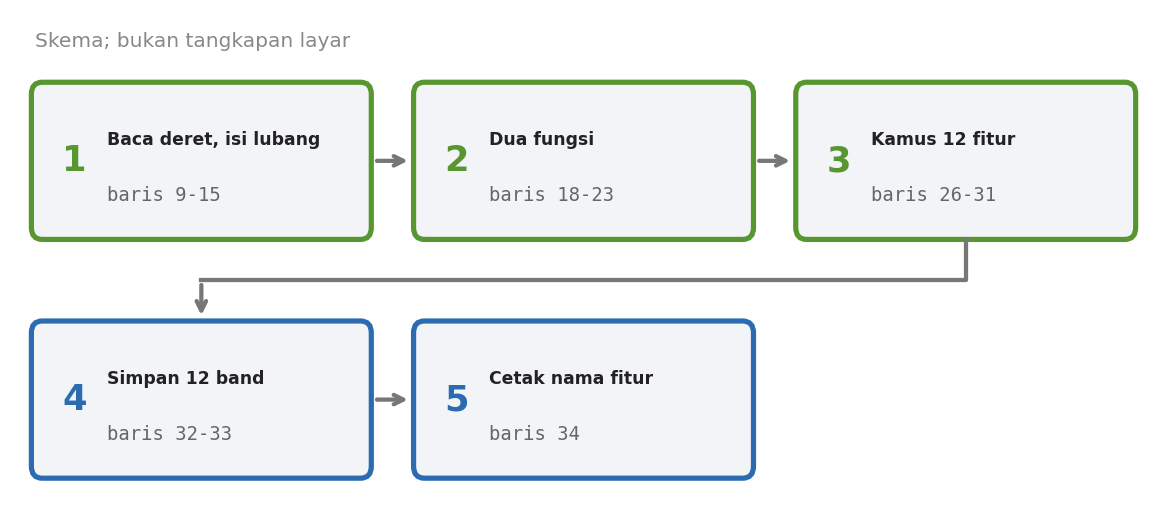
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 6.1: Bangun tumpukan fitur (12 band) dari deret waktu untuk machine learning
# Penulis: Badar Mubarok Yogaswara
# Fitur = angka ringkas yang menggambarkan "perilaku" tiap piksel sepanjang waktu. Hasil: hasil/fitur_deret.tif
import os
import numpy as np
import m3_umum as U

tgl, refl, scl, gt, prj = U.baca_deret()
hari = np.array([(t - tgl[0]).days for t in tgl], dtype="float64")
baik = U.bersih(scl)
ndvi = U.isi_waktu(U.nilai_ndvi(refl), baik, hari)           # NDVI tanpa lubang awan
nbr = U.isi_waktu(U.nilai_nbr(refl), baik, hari)
b11 = U.isi_waktu(refl[:, U.BAND["B11"]], baik, hari)
hc = hari - hari.mean()


def tren_tahun(x):
    return (hc[:, None, None] * (x - x.mean(0))).sum(0) / (hc ** 2).sum() * 365.0


def awal_akhir(x):
    return np.median(x[-4:], axis=0) - np.median(x[:4], axis=0)      # median 4 tanggal terakhir dikurangi 4 tanggal pertama


fitur = {
    "ndvi_rata": ndvi.mean(0), "ndvi_min": ndvi.min(0), "ndvi_maks": ndvi.max(0), "ndvi_simpang": ndvi.std(0),
    "ndvi_tren": tren_tahun(ndvi), "ndvi_turun_maks": np.diff(ndvi, axis=0).min(0), "ndvi_akhir_awal": awal_akhir(ndvi),
    "nbr_rata": nbr.mean(0), "nbr_min": nbr.min(0), "nbr_turun_maks": np.diff(nbr, axis=0).min(0),
    "nbr_akhir_awal": awal_akhir(nbr), "swir1_rata": b11.mean(0),
}
nama = list(fitur)
U.tulis_tif(os.path.join(U.HASIL, "fitur_deret.tif"), np.array([fitur[n] for n in nama]).astype("float32"), gt, prj, deskripsi=nama)
print("Fitur (%d band): %s" % (len(nama), ", ".join(nama)))
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-7 | import os, import numpy as np, import m3_umum as U | Perkakas. |
| 9-11 | tgl, refl, scl, gt, prj = ..., hari = ..., baik = ... | Baca deret, hitung hari ke-berapa tiap tanggal, dan penanda bersih. |
| 12 | ndvi = U.isi_waktu(U.nilai_ndvi(refl), baik, hari) | Dua fungsi bersarang: hitung NDVI, lalu tambal lubang awannya dengan fungsi kotak perkakas. Ini hampir sama dengan fungsi isi di Skrip 26.6. |
| 13 | nbr = U.isi_waktu(U.nilai_nbr(refl), baik, hari) | Hal yang sama untuk NBR. |
| 14 | b11 = U.isi_waktu(refl[:, U.BAND["B11"]], baik, hari) | Band B11 (SWIR1) diambil langsung dari larik, lalu ditambal. U.BAND["B11"] mencari nomor band dari kamus. |
| 15 | hc = hari - hari.mean() | Hari yang dipusatkan, seperti di Skrip 26.7. |
| 18-19 | def tren_tahun(x): | Fungsi tren per tahun. Rumusnya sama dengan Skrip 26.7. |
| 22-23 | def awal_akhir(x): | Median empat tanggal terakhir dikurangi median empat tanggal pertama. x[-4:] berarti empat terakhir, x[:4] empat pertama. |
| 26-31 | fitur = {...} | Kamus dua belas fitur. Kuncinya nama, isinya larik hasil hitungan. ndvi.mean(0) adalah rata-rata sepanjang waktu, dan seterusnya. np.diff(ndvi, axis=0).min(0) mencari penurunan terbesar antara dua tanggal berurutan. |
| 32 | nama = list(fitur) | Ambil kunci kamus sebagai daftar nama, dalam urutan penulisan. |
| 33 | U.tulis_tif(..., np.array([fitur[n] for n in nama]).astype("float32"), gt, prj, deskripsi=nama) | Susun dua belas larik menjadi satu larik dua belas band, dengan urutan sama dengan nama. Simpan ke fitur_deret.tif. |
| 34 | print("Fitur (%d band): %s" % (len(nama), ", ".join(nama))) | Cetak jumlah dan nama fitur. ", ".join(nama) menyambung daftar dengan koma. |
Arti dua belas fitur itu:
| Fitur | Arti |
|---|---|
ndvi_rata, ndvi_min, ndvi_maks, ndvi_simpang | Rata-rata, terendah, tertinggi, dan simpangan baku NDVI. |
ndvi_tren | Perubahan NDVI per tahun. |
ndvi_turun_maks | Penurunan NDVI terbesar antara dua tanggal berurutan. |
ndvi_akhir_awal | NDVI akhir dikurangi NDVI awal. |
nbr_rata, nbr_min | Rata-rata dan terendah NBR. |
nbr_turun_maks, nbr_akhir_awal | Penurunan NBR terbesar, serta NBR akhir dikurangi awal. |
swir1_rata | Rata-rata band SWIR1. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
Fitur (12 band): ndvi_rata, ndvi_min, ndvi_maks, ndvi_simpang, ndvi_tren, ndvi_turun_maks, ndvi_akhir_awal, nbr_rata, nbr_min, nbr_turun_maks, nbr_akhir_awal, swir1_rataBerkas fitur_deret.tif kini berisi 12 band. Urutan nama di layar adalah urutan band.
Bagian yang boleh diubah.
- Baris 26-31, isi kamus. Tambah fitur baru dengan satu entri. Saya menambahkan
"ndvi_median": np.median(ndvi, axis=0)di akhir kamus (setelahswir1_rata). Layar menampilkanFitur (13 band): ... swir1_rata, ndvi_median. Skrip 26.13 tetap berjalan:Titik latih: 200, fitur: 13. - Baris 23, angka 4. Jumlah tanggal di awal dan akhir yang dibandingkan.
Jebakan.
- Urutan fitur tidak boleh diubah di tengah. Skrip 26.14 memakai tujuh fitur pertama (
range(7)), yaitu fitur NDVI. Bila Anda menyisipkan fitur di depan, "tujuh fitur NDVI" itu berubah isi tanpa pesan. Tambahkan fitur baru di akhir. - Rumus tren sedikit berbeda dari Skrip 26.7. Di sini memakai
x.mean(0)di dalam fungsi, sedangkan di Skrip 26.7 memakai larikratayang sudah dihitung. Penulisannya tidak persis sama, jadi periksa bila Anda menyalinnya. - Penambalan per piksel lambat, seperti Skrip 26.6. Tiga kali pemanggilan
U.isi_waktumenambah waktu.
Latihan variasi.
- Tambahkan fitur
ndvi_median(median NDVI). - Pastikan jumlah band menjadi 13.
Contoh jawaban, hanya baris 30:
"nbr_akhir_awal": awal_akhir(nbr), "swir1_rata": b11.mean(0), "ndvi_median": np.median(ndvi, axis=0),Layar menampilkan Fitur (13 band): ndvi_rata, ndvi_min, ... swir1_rata, ndvi_median.
Kotak perkakas kedua: hutan_mini.py #
Skrip berikutnya melatih hutan acak. Pustaka umumnya adalah scikit-learn, tetapi tidak semua QGIS memasangnya. Di QGIS 4.0.2 milik saya, import sklearn menghasilkan ModuleNotFoundError: No module named 'sklearn'. Karena itu penulis membuat hutan_mini.py: hutan acak ringkas yang hanya memakai NumPy.
Berkas ini memuat kelas buatan sendiri. Kelas adalah cetakan benda: ia punya data (disebut atribut) dan pekerjaan (disebut metode) sekaligus. Ada dua kelas di sini. _Pohon mewakili satu pohon keputusan. RandomForestClassifier mewakili hutan yang memegang banyak pohon. Nama terakhir sengaja sama dengan nama di scikit-learn, sehingga skrip lain bisa berganti pustaka tanpa mengubah pemanggilannya. Cara membuat kelas, arti self, dan __init__ dibahas di Bab 11.
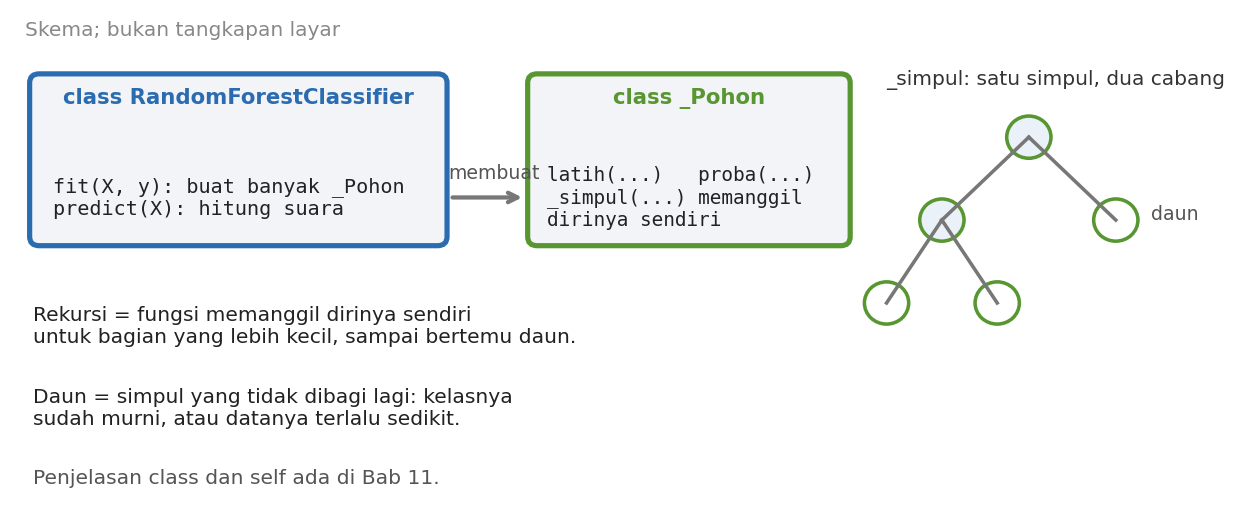
Bagian yang paling menarik adalah rekursi: fungsi yang memanggil dirinya sendiri. Metode _simpul membagi data menjadi dua kelompok, lalu memanggil _simpul lagi untuk tiap kelompok. Pembagian berhenti di daun, yaitu kelompok yang kelasnya sudah murni atau datanya terlalu sedikit. Bayangkan Anda membagi tumpukan kartu menjadi dua, lalu membagi tiap tumpukan menjadi dua lagi, sampai tiap tumpukan berisi satu jenis kartu.
Tujuan. Menyediakan hutan acak ringkas bagi Skrip 26.13 dan 26.14, sekaligus membuka "kotak hitam" supaya Anda paham cara kerjanya.
Bahan. Berkas ini tidak dijalankan sendiri. Skrip 26.13 dan 26.14 mengimpornya bila sklearn tidak ada. Berkas harus satu folder dengan mereka. Ia hanya memakai numpy.
Skrip utuh:
# -*- coding: utf-8 -*-
"""hutan_mini.py: hutan acak (random forest) ringkas dengan NumPy saja. Penulis: Badar Mubarok Yogaswara
Tujuan: (1) membuka "kotak hitam" supaya Anda paham cara kerjanya, (2) tetap bisa jalan di QGIS yang belum memasang scikit-learn.
Antarmukanya sengaja dibuat mirip scikit-learn: RandomForestClassifier(...).fit(X, y), .predict(X), .feature_importances_.
Ini alat belajar; untuk pekerjaan besar pakai scikit-learn."""
import numpy as np


class _Pohon:
    def __init__(self, maks_fitur, kedalaman, daun_min, rng):
        self.mf, self.kd, self.dm, self.rng = maks_fitur, kedalaman, daun_min, rng
        self.fitur, self.ambang, self.kiri, self.kanan, self.nilai = [], [], [], [], []
        self.penting = None

    def _gini(self, hitung):
        n = hitung.sum()
        return 1.0 - ((hitung / n) ** 2).sum() if n else 0.0

    def _simpul(self, X, y, K, kdl):
        hitung = np.bincount(y, minlength=K).astype(float)
        idx = len(self.fitur)
        self.fitur.append(-1); self.ambang.append(0.0); self.kiri.append(-1); self.kanan.append(-1); self.nilai.append(hitung / hitung.sum())
        if kdl == self.kd or len(y) < 2 * self.dm or (hitung > 0).sum() == 1:
            return idx
        terbaik = (0.0, None, None)
        g0 = self._gini(hitung)
        n = len(y)
        for f in self.rng.choice(X.shape[1], size=self.mf, replace=False):
            urut = np.argsort(X[:, f], kind="stable")
            xs, ys = X[urut, f], y[urut]
            kiri = np.cumsum(np.eye(K)[ys], axis=0)             # jumlah kelas di sisi kiri untuk tiap titik potong
            kanan = hitung - kiri
            nk = np.arange(1, n + 1)[:, None]
            nr = n - nk
            gk = 1 - ((kiri / nk) ** 2).sum(1)
            gr = np.where(nr[:, 0] > 0, 1 - ((kanan / np.maximum(nr, 1)) ** 2).sum(1), 0)
            skor = g0 - (nk[:, 0] * gk + nr[:, 0] * gr) / n      # penurunan ketidakmurnian
            sah = (xs[:-1] < xs[1:]) & (nk[:-1, 0] >= self.dm) & (nr[:-1, 0] >= self.dm)
            if not sah.any():
                continue
            s = np.where(sah, skor[:-1], -1)
            k = int(s.argmax())
            if s[k] > terbaik[0]:
                terbaik = (s[k], f, (xs[k] + xs[k + 1]) / 2)
        if terbaik[1] is None:
            return idx
        gain, f, t = terbaik
        self.penting[f] += gain * n
        m = X[:, f] <= t
        self.fitur[idx], self.ambang[idx] = f, t
        self.kiri[idx] = self._simpul(X[m], y[m], K, kdl + 1)
        self.kanan[idx] = self._simpul(X[~m], y[~m], K, kdl + 1)
        return idx

    def latih(self, X, y, K):
        self.penting = np.zeros(X.shape[1])
        self._simpul(X, y, K, 0)
        self.fitur, self.ambang = np.array(self.fitur), np.array(self.ambang)
        self.kiri, self.kanan, self.nilai = np.array(self.kiri), np.array(self.kanan), np.array(self.nilai)

    def proba(self, X):
        simpul = np.zeros(len(X), dtype=int)
        while True:
            daun = self.fitur[simpul] < 0
            if daun.all():
                break
            f = self.fitur[simpul]
            ke_kiri = X[np.arange(len(X)), np.maximum(f, 0)] <= self.ambang[simpul]
            baru = np.where(ke_kiri, self.kiri[simpul], self.kanan[simpul])
            simpul = np.where(daun, simpul, baru)
        return self.nilai[simpul]


class RandomForestClassifier:
    def __init__(self, n_estimators=100, max_features="sqrt", max_depth=None, min_samples_leaf=1, random_state=0):
        self.n_estimators, self.max_features, self.max_depth = n_estimators, max_features, max_depth
        self.min_samples_leaf, self.random_state = min_samples_leaf, random_state

    def fit(self, X, y):
        X = np.asarray(X, dtype=float)
        self.classes_, yk = np.unique(y, return_inverse=True)
        K, (n, d) = len(self.classes_), X.shape
        mf = max(1, int(np.sqrt(d))) if self.max_features == "sqrt" else (d if self.max_features is None else int(self.max_features))
        rng = np.random.default_rng(self.random_state)
        self.pohon_, imp = [], np.zeros(d)
        for _ in range(self.n_estimators):
            b = rng.integers(0, n, n)                            # contoh bootstrap: ambil n baris dengan pengembalian
            p = _Pohon(mf, self.max_depth or 10 ** 6, self.min_samples_leaf, rng)
            p.latih(X[b], yk[b], K)
            self.pohon_.append(p)
            imp += p.penting
        self.feature_importances_ = imp / imp.sum() if imp.sum() else imp
        return self

    def predict_proba(self, X):
        X = np.asarray(X, dtype=float)
        return np.mean([p.proba(X) for p in self.pohon_], axis=0)

    def predict(self, X):
        return self.classes_[self.predict_proba(X).argmax(1)]
Penjelasan baris demi baris. Berkas ini padat, jadi dijelaskan per blok.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-6 | docstring dan import numpy as np | Keterangan tujuan berkas, dan perkakas NumPy. |
| 9 | class _Pohon: | Mulai kelas pohon. Awalan garis bawah menandakan kelas ini untuk dipakai di dalam berkas. |
| 10-13 | def __init__(self, maks_fitur, kedalaman, daun_min, rng): | Pembuat: dijalankan saat sebuah pohon dibuat. Ia menyimpan aturan (jumlah fitur yang dicoba, kedalaman maksimum, daun minimum, pengacak) dan menyiapkan lima daftar kosong yang kelak menyimpan isi pohon. |
| 15-17 | def _gini(self, hitung): | Mengukur ketidakmurnian sebuah kelompok. Nilai 0 berarti semua anggota sekelas. Makin dekat ke 1, makin campur. |
| 19 | def _simpul(self, X, y, K, kdl): | Metode inti: membangun satu simpul pada kedalaman kdl. |
| 20-22 | hitung = np.bincount(...) sampai self.nilai.append(...) | Hitung berapa anggota tiap kelas, nomori simpul ini, dan catat simpul baru ke daftar. Baris 22 menaruh beberapa pernyataan satu baris dengan titik koma. |
| 23-24 | if kdl == self.kd or ...: return idx | Berhenti dan jadikan simpul ini daun bila sudah mencapai kedalaman maksimum, datanya terlalu sedikit, atau kelasnya sudah murni. |
| 25-27 | terbaik = (0.0, None, None) dan dua baris | Siapkan catatan "pembagian terbaik sejauh ini", ketidakmurnian awal, dan jumlah data. |
| 28-44 | for f in self.rng.choice(...): | Coba beberapa fitur yang dipilih acak. Untuk tiap fitur: urutkan data (baris 29-30), hitung kelas di sisi kiri tiap titik potong (baris 31-32), hitung ketidakmurnian kedua sisi (baris 33-36), dan nilai tiap potongan (baris 37). Baris 38-44 memilih potongan terbaik yang sah. |
| 45-46 | if terbaik[1] is None: return idx | Bila tidak ada potongan yang berguna, jadikan daun. |
| 47-50 | gain, f, t = terbaik sampai self.fitur[idx], ... = f, t | Pakai potongan terbaik: catat fitur dan ambang di simpul ini, dan tambah kepentingan fitur. m memisahkan data menjadi dua kelompok. |
| 51-52 | self.kiri[idx] = self._simpul(...) dan baris kanan | Rekursi: panggil _simpul untuk kelompok kiri dan kelompok kanan, pada kedalaman satu tingkat lebih dalam. |
| 53 | return idx | Kembalikan nomor simpul ini. |
| 55-59 | def latih(self, X, y, K): | Metode umum: siapkan penampung kepentingan, panggil _simpul untuk akar, lalu ubah daftar menjadi larik NumPy. |
| 61-71 | def proba(self, X): | Menebak kelas untuk banyak titik sekaligus. Baris 63-70 adalah putaran while True yang menelusuri pohon dari akar ke daun, dan berhenti (break, baris 66) saat semua titik sudah di daun. |
| 74 | class RandomForestClassifier: | Kelas hutan. Namanya sama dengan di scikit-learn. |
| 75-77 | def __init__(self, n_estimators=100, ...) | Pembuat hutan. Semua pengaturan punya nilai bawaan. n_estimators adalah jumlah pohon. |
| 79-93 | def fit(self, X, y): | Melatih hutan. Baris 81 mengubah label menjadi nomor 0, 1, 2, dan seterusnya. Baris 83 menentukan berapa fitur dicoba tiap simpul (akar jumlah fitur). Baris 86-91 membuat tiap pohon dari contoh bootstrap (baris 87): n baris diambil acak dengan pengembalian, jadi sebagian baris muncul dua kali dan sebagian tidak muncul. Baris 92 menghitung kepentingan fitur rata-rata. Baris 93 mengembalikan hutan itu sendiri, sehingga bisa ditulis berantai .fit(...). |
| 95-97 | def predict_proba(self, X): | Rata-rata tebakan semua pohon. |
| 99-100 | def predict(self, X): | Ambil kelas dengan peluang terbesar. Baris 100 adalah "suara terbanyak". |
Hasil. Anda bisa mencobanya langsung dengan data mainan (bukan bagian berkas): dua fitur, enam titik.
from hutan_mini import RandomForestClassifier
X = [[0.86, 0.02], [0.84, 0.03], [0.88, 0.02], [0.52, 0.15], [0.48, 0.17], [0.55, 0.14]]
y = [1, 1, 1, 2, 2, 2]          # 1 = hutan, 2 = sawah
m = RandomForestClassifier(n_estimators=10, random_state=1).fit(X, y)
print("kelas dikenal:", m.classes_)
print("prediksi      :", m.predict([[0.85, 0.02], [0.50, 0.16]]))
print("kepentingan   :", m.feature_importances_.round(2))
Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
kelas dikenal: [1 2]
prediksi      : [1 2]
kepentingan   : [0.29 0.71]
Titik pertama ditebak hutan, titik kedua sawah. Fitur kedua (simpangan baku) lebih penting daripada fitur pertama pada data mainan ini.
Bagian yang boleh diubah.
- Baris 75, pengaturan hutan.
n_estimators(jumlah pohon),max_depth(kedalaman maksimum),min_samples_leaf(anggota minimum tiap daun),random_state(benih). Skrip pemanggil yang menentukannya. - Baris 83,
"sqrt". Jumlah fitur yang dicoba tiap simpul.
Jebakan.
- Hasil belum tentu sama dengan scikit-learn. Meskipun benih sama, cara pengacakannya berbeda. Saya tidak bisa mengujinya karena
sklearntidak terpasang di QGIS saya. Bila Anda memasangnya, angka di Skrip 26.13 dan 26.14 bisa berbeda dari yang tertera di bab ini [CEK]. - Lambat untuk data besar. Ini alat belajar. Untuk pekerjaan besar, pakai scikit-learn.
- Label boleh teks. Saya mencoba label
"hutan"dan"sawah"denganmax_depth=1:classes_menjadi['hutan' 'sawah'], tebakannya benar, dan pohon pertama hanya punya tiga simpul (satu akar, dua daun).
Latihan variasi.
- Latih dengan
max_depth=1dan label teks. - Hitung simpul pohon pertama.
Contoh jawaban:
y = ["hutan", "hutan", "hutan", "sawah", "sawah", "sawah"]
m = RandomForestClassifier(n_estimators=10, max_depth=1, random_state=1).fit(X, y)
print(m.classes_, m.predict([[0.85, 0.02], [0.50, 0.16]]), len(m.pohon_[0].fitur))
Layar menampilkan ['hutan' 'sawah'] ['hutan' 'sawah'] 3.
Skrip 26.13: Melatih hutan acak dan memetakan seluruh area #
Berkas 6_2_latih_klasifikasi.py. Di dalam berkasnya tertulis "SKRIP 6.2".
Tujuan. Melatih hutan acak dari titik latih, membandingkan uji silang acak dengan uji silang blok ruang, lalu memetakan seluruh area.
Bahan. fitur_deret.tif dari Skrip 26.12, vektor/Titik_Latih.gpkg (kolom KELAS), acuan/Acuan_Dinamika.tif, dan m3_umum.py. Bila sklearn tidak ada, skrip memakai hutan_mini.py. Jalankan dari Konsol atau terminal.
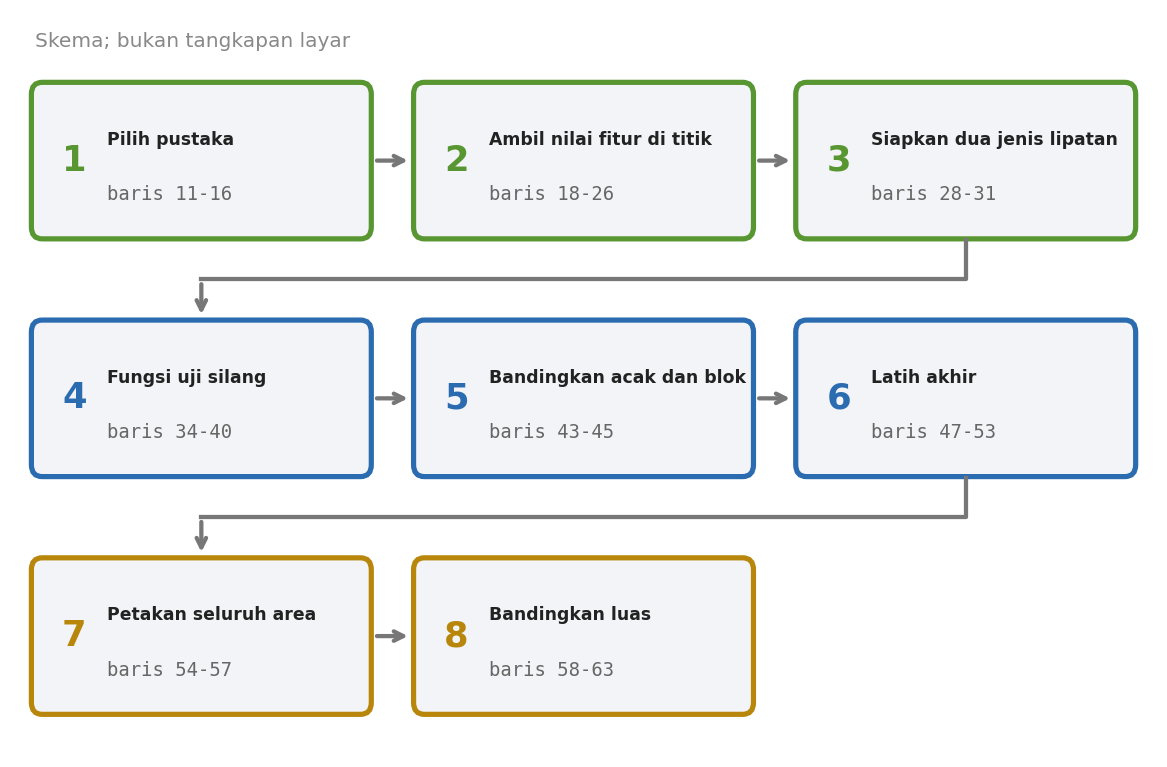
Uji silang perlu dijelaskan sebelum skripnya. Titik latih dibagi menjadi empat kelompok (lipatan). Mesin dilatih pada tiga lipatan, lalu diuji pada satu lipatan yang tersisa. Proses diulang empat kali. Pada lipatan acak, titik dibagi sembarang, sehingga tetangga dekat bisa ada di kedua sisi. Pada lipatan blok, titik dibagi menurut lokasi (empat blok 200 meter), sehingga blok yang diuji benar-benar "asing" bagi mesin.
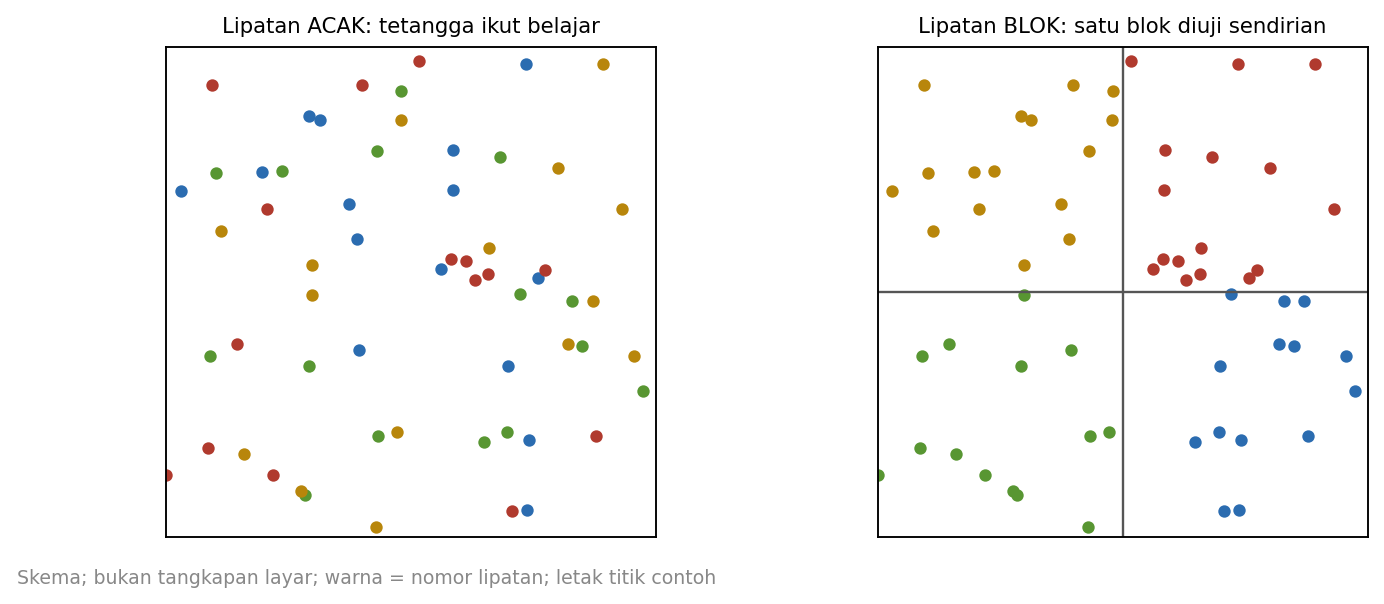
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 6.2: Latih hutan acak dari titik latih, uji silang acak vs uji silang blok ruang, lalu petakan seluruh area
# Penulis: Badar Mubarok Yogaswara
# Syarat: Skrip 6.1 sudah dijalankan. Memakai scikit-learn bila terpasang; bila tidak, memakai hutan_mini.py.
import os
import numpy as np
import processing
from qgis.core import QgsVectorLayer
import m3_umum as U

try:
    from sklearn.ensemble import RandomForestClassifier
    print("Memakai scikit-learn")
except ImportError:
    from hutan_mini import RandomForestClassifier
    print("scikit-learn tidak ada; memakai hutan_mini.py")

fitur_tif = os.path.join(U.HASIL, "fitur_deret.tif")
titik = QgsVectorLayer(os.path.join(U.PAKET, "vektor", "Titik_Latih.gpkg"), "latih")
# ambil nilai 12 fitur pada tiap titik latih (Sample raster values)
s = processing.run("native:rastersampling", {"INPUT": titik, "RASTERCOPY": fitur_tif, "COLUMN_PREFIX": "f", "OUTPUT": "TEMPORARY_OUTPUT"})["OUTPUT"]
nama_f = [fl.name() for fl in s.fields() if fl.name().startswith("f") and fl.name() != "fid"]
X = np.array([[f[n] for n in nama_f] for f in s.getFeatures()], dtype=float)
y = np.array([f["KELAS"] for f in s.getFeatures()])
xy = np.array([[f.geometry().asPoint().x(), f.geometry().asPoint().y()] for f in s.getFeatures()])
print("Titik latih: %d, fitur: %d, kelas: %s" % (len(y), X.shape[1], dict(zip(*np.unique(y, return_counts=True)))))

# --- uji silang 1: acak 4 lipatan; uji silang 2: lipatan = blok ruang 200 m x 200 m (4 blok, area 400 m)
rng = np.random.default_rng(5)
lipat_acak = rng.permutation(len(y)) % 4
lipat_blok = (xy[:, 0] >= 312200).astype(int) + 2 * (xy[:, 1] >= 9996200).astype(int)


def uji_silang(lipat):
    benar = []
    for k in range(4):
        tr, te = lipat != k, lipat == k
        m = RandomForestClassifier(n_estimators=100, random_state=1).fit(X[tr], y[tr])
        benar.append((m.predict(X[te]) == y[te]).mean())
    return np.array(benar)


a, b = uji_silang(lipat_acak), uji_silang(lipat_blok)
print("Akurasi uji silang ACAK : %s rata-rata %.3f" % (np.round(a, 2), a.mean()))
print("Akurasi uji silang BLOK : %s rata-rata %.3f" % (np.round(b, 2), b.mean()))

# --- latih akhir dan petakan
model = RandomForestClassifier(n_estimators=200, random_state=1).fit(X, y)
urut = np.argsort(model.feature_importances_)[::-1]
from osgeo import gdal
ds = gdal.Open(fitur_tif)
nama_fitur = [ds.GetRasterBand(i + 1).GetDescription() for i in range(ds.RasterCount)]
print("Kepentingan fitur (5 teratas):", ", ".join("%s %.2f" % (nama_fitur[i], model.feature_importances_[i]) for i in urut[:5]))
st, gt, prj = U.baca_tif(fitur_tif)                  # (12, H, W)
nb, H, W = st.shape
peta = model.predict(st.reshape(nb, -1).T).reshape(H, W).astype("uint8")
U.tulis_tif(os.path.join(U.HASIL, "peta_rf.tif"), peta, gt, prj, nodata=0)
din, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
nama = {1: "Hutan alam", 2: "Hutan tanaman", 3: "Pertanian", 4: "Air", 5: "Terbuka", 6: "Deforestasi", 7: "Terbakar", 8: "Panen HTI"}
print("Luas hasil peta (ha) / luas acuan (ha):")
for k in range(1, 9):
    print("  %-14s %6.2f / %6.2f" % (nama[k], (peta == k).sum() * 0.01, (din == k).sum() * 0.01))
print("Kesesuaian peta dengan acuan di SEMUA piksel (bukan uji mandiri): %.3f" % (peta == din).mean())
Penjelasan baris demi baris.
| Baris | Tulisan | Artinya |
|---|---|---|
| 5-9 | import os sampai import m3_umum as U | Perkakas. |
| 11-16 | try: ... except ImportError: | Coba dulu, cadangan kemudian. Bila from sklearn.ensemble import RandomForestClassifier berhasil, pakai scikit-learn dan cetak pesannya. Bila gagal dengan ImportError, Python lompat ke blok except dan memakai hutan_mini (Bab 10). |
| 18-19 | fitur_tif = ... dan titik = QgsVectorLayer(...) | Jalur tumpukan fitur, dan layer titik latih. |
| 21 | s = processing.run("native:rastersampling", {...})["OUTPUT"] | Alat Sample raster values: mengambil nilai tiap band tumpukan di tiap titik. COLUMN_PREFIX: "f" menamai kolom baru f1, f2, dan seterusnya. Hasilnya layer sementara berisi titik dengan kolom nilai. |
| 22 | nama_f = [fl.name() for fl in s.fields() if fl.name().startswith("f") and fl.name() != "fid"] | Kumpulkan nama kolom yang berawalan huruf f, kecuali fid (nomor baris bawaan). Itulah f1 sampai f12. |
| 23 | X = np.array([[f[n] for n in nama_f] for f in s.getFeatures()], dtype=float) | Comprehension bersarang: untuk tiap titik, daftar 12 nilai fitur. Hasilnya larik 200 baris kali 12 kolom. X adalah tabel fitur. |
| 24 | y = np.array([f["KELAS"] for f in s.getFeatures()]) | y adalah daftar kelas tiap titik. |
| 25 | xy = np.array([[... x(), ... y()] for f in ...]) | Koordinat tiap titik. |
| 26 | print("Titik latih: %d, fitur: %d, kelas: %s" % (...)) | Cetak jumlah titik, jumlah fitur, dan banyak titik tiap kelas. np.unique(..., return_counts=True) memberi kelas dan hitungannya, zip(*...) menyandingkannya, dict(...) membuat kamus. |
| 29 | rng = np.random.default_rng(5) | Pengacak dengan benih 5. |
| 30 | lipat_acak = rng.permutation(len(y)) % 4 | Acak urutan 200 titik, lalu bagi dengan 4 dan ambil sisanya (0 sampai 3). Hasilnya nomor lipatan tiap titik. |
| 31 | lipat_blok = (xy[:, 0] >= 312200).astype(int) + 2 * (xy[:, 1] >= 9996200).astype(int) | Nomor lipatan menurut lokasi: 0 untuk barat daya, 1 tenggara, 2 barat laut, 3 timur laut. Batas 312200 dan 9996200 adalah garis tengah area contoh. |
| 34-40 | def uji_silang(lipat): | Fungsi uji silang, dengan satu masukan: nomor lipatan tiap titik. |
| 35-36 | benar = [] dan for k in range(4): | Daftar akurasi, lalu empat putaran. |
| 37 | tr, te = lipat != k, lipat == k | tr (latih) berisi semua titik bukan lipatan k. te (uji) berisi titik lipatan k. |
| 38 | m = RandomForestClassifier(n_estimators=100, random_state=1).fit(X[tr], y[tr]) | Buat hutan 100 pohon dan latih dengan fit. Dua panggilan berantai dalam satu baris. |
| 39 | benar.append((m.predict(X[te]) == y[te]).mean()) | Tebak titik uji, bandingkan dengan kelas sebenarnya, dan catat pecahan yang benar. |
| 40 | return np.array(benar) | Kembalikan empat akurasi. |
| 43-45 | a, b = uji_silang(lipat_acak), uji_silang(lipat_blok) dan dua print | Jalankan uji dengan dua jenis lipatan, dan cetak akurasi tiap lipatan serta rata-ratanya. |
| 48 | model = RandomForestClassifier(n_estimators=200, random_state=1).fit(X, y) | Latih akhir pada seluruh titik, dengan 200 pohon. |
| 49 | urut = np.argsort(model.feature_importances_)[::-1] | Urutkan nomor fitur dari yang paling penting. [::-1] membalik urutan. |
| 50-52 | from osgeo import gdal, ds = ..., nama_fitur = [...] | Baca nama band dari tumpukan fitur, yaitu nama yang ditulis Skrip 26.12. |
| 53 | print("Kepentingan fitur (5 teratas): ...") | Cetak lima fitur terpenting dan skornya. |
| 54-55 | st, gt, prj = U.baca_tif(fitur_tif) dan nb, H, W = st.shape | Baca seluruh tumpukan fitur: 12 band kali 40 kali 40. |
| 56 | peta = model.predict(st.reshape(nb, -1).T).reshape(H, W).astype("uint8") | st.reshape(nb, -1) meratakan tiap band menjadi satu baris panjang, .T menukar baris dan kolom sehingga tiap baris adalah satu piksel dengan 12 fitur. predict menebak kelas semua piksel. reshape(H, W) mengembalikan bentuk peta. |
| 57 | U.tulis_tif(..."peta_rf.tif", peta, gt, prj, nodata=0) | Simpan peta kelas. Byte cukup untuk kelas 1 sampai 8. |
| 58-59 | din, _, _ = ... dan nama = {...} | Peta acuan dan nama kelas. |
| 60-62 | print("Luas hasil peta (ha) / luas acuan (ha):") dan putaran | Cetak luas tiap kelas pada peta dan pada acuan, piksel kali 0,01 hektare. |
| 63 | print("Kesesuaian peta dengan acuan di SEMUA piksel (bukan uji mandiri): %.3f" % (peta == din).mean()) | Pecahan piksel yang sama dengan acuan. Skrip sendiri menandainya "bukan uji mandiri". |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2, tanpa scikit-learn, jadi memakai hutan_mini):
scikit-learn tidak ada; memakai hutan_mini.py
Titik latih: 200, fitur: 12, kelas: {np.int64(1): np.int64(25), np.int64(2): np.int64(25), np.int64(3): np.int64(25), np.int64(4): np.int64(25), np.int64(5): np.int64(25), np.int64(6): np.int64(25), np.int64(7): np.int64(25), np.int64(8): np.int64(25)}
Akurasi uji silang ACAK : [0.98 1.   1.   1.  ] rata-rata 0.995
Akurasi uji silang BLOK : [0.5  0.89 0.63 0.44] rata-rata 0.617
Kepentingan fitur (5 teratas): nbr_rata 0.13, ndvi_rata 0.12, ndvi_maks 0.12, swir1_rata 0.12, nbr_min 0.11
Luas hasil peta (ha) / luas acuan (ha):
  Hutan alam       7.99 /   8.00
  Hutan tanaman    0.96 /   0.96
  Pertanian        1.80 /   1.80
  Air              0.80 /   0.80
  Terbuka          0.43 /   0.43
  Deforestasi      1.30 /   1.30
  Terbakar         1.52 /   1.51
  Panen HTI        1.20 /   1.20
Kesesuaian peta dengan acuan di SEMUA piksel (bukan uji mandiri): 0.999
Baris {np.int64(1): np.int64(25), ...} adalah cara NumPy versi baru menampilkan angka. Artinya tetap: tiap kelas punya 25 titik.
Perhatikan dua baris akurasi. Pada uji silang acak, akurasi 0,995, nyaris sempurna. Pada uji silang blok, akurasi turun jauh menjadi 0,617, dan satu blok hanya 0,44. Mesin tampak hebat saat tetangga dekat boleh ikut belajar, tetapi jauh lebih lemah di tempat yang belum pernah ia lihat. Uji silang acak terlalu optimistis untuk data ruang. Peta akhir sendiri cocok 99,9 persen dengan acuan, tetapi itu bukan ujian mandiri: titik latih ikut dihitung, dan piksel itu juga bagian dari acuan.
Bagian yang boleh diubah.
- Baris 38,
n_estimators. Saya mengubahnya menjadi5: akurasi blok menjadi[0.5 0.62 0.88 0.44](rata-rata 0,612) dan akurasi acak tetap 0,995. Pohon lebih sedikit, hasil sedikit bergeser. - Baris 31, batas blok. Saya mengganti
312200menjadi312100. Akurasi blok menjadi[0.29 0.92 1. 0.63]dengan rata-rata 0,707. Blok yang berbeda memberi angka berbeda, jadi uji blok tergantung cara memotong. - Baris 29, benih. Ganti
5untuk undian lipatan acak yang lain. - Baris 48, 200 pohon. Lebih banyak pohon, lebih lambat tetapi lebih stabil.
Jebakan.
- Pustaka bisa berganti tanpa Anda sadari. Baris pertama keluaran memberi tahu:
scikit-learn tidak ada; memakai hutan_mini.py. Di komputer yang punya scikit-learn, angka akurasi dan peta bisa berbeda [CEK]. Selalu baca baris itu. - Kolom fitur diambil dari awalan
f. Saya mencetak daftar kolom hasil pengambilan nilai:['fid', 'ID', 'KELAS', 'NAMA_KELAS', 'f1', ..., 'f12']. Daftarnama_fberisi tepatf1sampaif12. Bila data Anda punya kolom lain berawalanf(huruf kecil), kolom itu ikut terambil dan merusakX. - Angka empat dan batas blok dikunci.
range(4),% 4, dan dua batas koordinat harus cocok. Saya menggantirange(4)menjadirange(3): layar hanya menampilkan tiga angka akurasi, dan satu lipatan tidak pernah diuji. Skrip tidak mengeluh. - Skrip 26.12 harus sudah jalan. Di folder kosong, layar menampilkan
QgsProcessingException: Unable to execute algorithmdanCould not load source layer for RASTERCOPY: ...fitur_deret.tif not found. from osgeo import gdaldi tengah berkas. Boleh, tetapi biasanya impor ditaruh di atas.- Luas 0,01 hektare per piksel dikunci di baris 62.
Latihan variasi.
- Kurangi pohon uji silang menjadi 5, lalu bandingkan akurasi blok.
- Geser batas blok barat-timur menjadi 312100.
Contoh jawaban, hanya baris yang berubah:
m = RandomForestClassifier(n_estimators=5, random_state=1).fit(X[tr], y[tr])lipat_blok = (xy[:, 0] >= 312100).astype(int) + 2 * (xy[:, 1] >= 9996200).astype(int)Untuk nomor 1, layar menampilkan Akurasi uji silang BLOK : [0.5 0.62 0.88 0.44] rata-rata 0.612. Untuk nomor 2, Akurasi uji silang BLOK : [0.29 0.92 1. 0.63] rata-rata 0.707. Tiap variasi dijalankan terpisah.
Kelompok G: Seberapa boleh peta ini dipercaya? #
Konsep: ujian dengan soal baru #
Validasi itu seperti ujian dengan soal yang belum pernah dilihat murid. Nilai ujian yang soalnya sama dengan bahan belajar tidak membuktikan apa-apa. Anda menarik sampel acak titik di peta, memeriksa kebenarannya dengan data acuan yang lebih tepercaya, lalu menyusun matriks kebingungan. Dari matriks itu keluar akurasi, dan koreksi luas: perkiraan luas yang sudah memperhitungkan kesalahan peta.
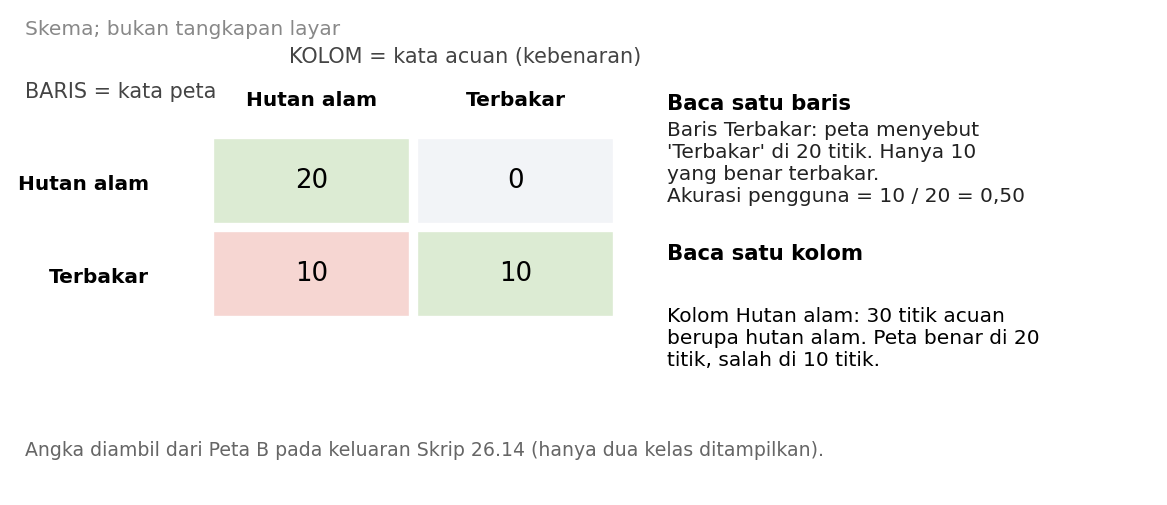
Lima istilah yang perlu Anda kenal sekarang:
- Matriks kebingungan: tabel yang menyilangkan kelas peta (baris) dengan kelas acuan (kolom).
- Akurasi pengguna (UA): dari semua piksel yang peta sebut kelas X, berapa bagian yang benar kelas X. Mengukur kesalahan "terlalu banyak menandai".
- Akurasi produsen (PA): dari semua piksel yang sebenarnya kelas X, berapa bagian yang peta temukan. Mengukur kesalahan "terlewat".
- Sampel acak berstrata: sampel dengan jumlah tetap pada tiap kelas peta, supaya kelas langka ikut terwakili.
- Luas terkoreksi: luas yang disesuaikan dengan kesalahan peta, disertai rentang ketidakpastian (di sini 95 persen).
Skrip 26.14: Validasi dua peta dengan sampel berstrata #
Berkas 7_1_validasi.py. Di dalam berkasnya tertulis "SKRIP 7.1".
Tujuan. Menguji dua peta klasifikasi dengan sampel acak berstrata: matriks kebingungan, akurasi keseluruhan, akurasi pengguna dan produsen, luas terkoreksi dengan rentang 95 persen, dan kestabilan terhadap pengundian sampel.
Bahan. fitur_deret.tif (Skrip 26.12), peta_rf.tif (Skrip 26.13), acuan/Acuan_Dinamika.tif, vektor/Titik_Latih.gpkg, dan m3_umum.py. Dua peta diuji. Peta A memakai 12 fitur. Peta B hanya memakai tujuh fitur NDVI. Dalam praktik, acuan berasal dari tafsir citra resolusi tinggi atau survei lapangan. Di data ini, acuannya kunci jawaban.
Skrip ini yang paling panjang di bab ini, dengan dua fungsi besar.
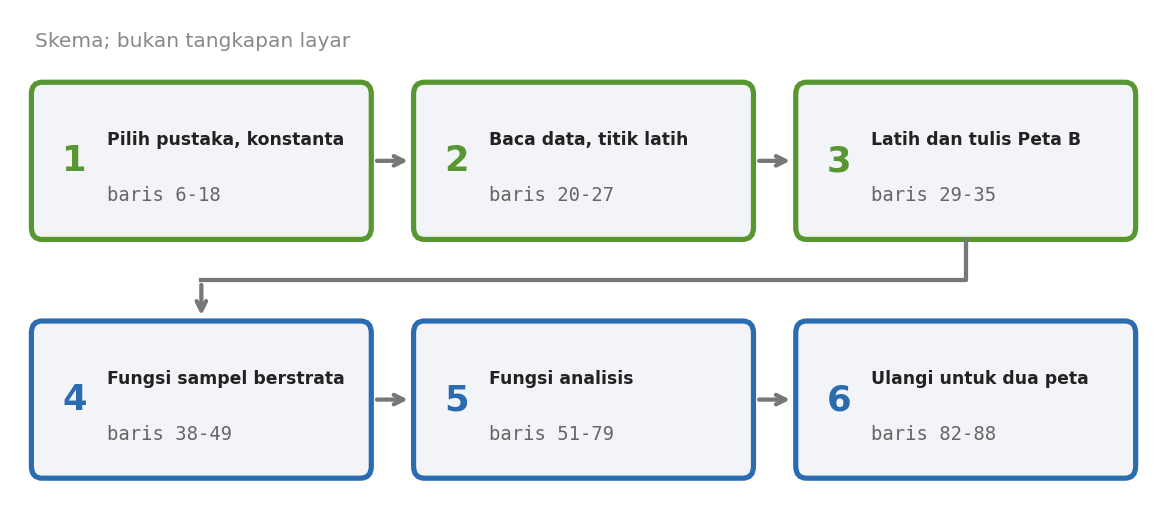
Skrip utuh:
# -*- coding: utf-8 -*-
# SKRIP 7.1: Validasi peta: sampel acak berstrata, matriks kebingungan, akurasi, dan estimasi luas terkoreksi
# Penulis: Badar Mubarok Yogaswara
# Dua peta diuji: (A) hutan acak dengan 12 fitur (hasil Skrip 6.2) dan (B) hutan acak yang hanya memakai fitur NDVI.
# Acuan: Acuan_Dinamika.tif. Dalam praktik, acuan berasal dari tafsir citra resolusi tinggi atau survei lapangan.
import os
import numpy as np
from qgis.core import QgsVectorLayer
import m3_umum as U

try:
    from sklearn.ensemble import RandomForestClassifier
except ImportError:
    from hutan_mini import RandomForestClassifier

NAMA = {1: "Hutan alam", 2: "Hutan tanaman", 3: "Pertanian", 4: "Air", 5: "Terbuka", 6: "Deforestasi", 7: "Terbakar", 8: "Panen HTI"}
N_STRATUM = 20            # sampel per kelas peta
LUAS_PIKSEL = 0.01        # ha

st, gt, prj = U.baca_tif(os.path.join(U.HASIL, "fitur_deret.tif"))
acuan, _, _ = U.baca_tif(os.path.join(U.PAKET, "acuan", "Acuan_Dinamika.tif"))
latih = QgsVectorLayer(os.path.join(U.PAKET, "vektor", "Titik_Latih.gpkg"), "latih")
pl = [(U.xy_ke_piksel(gt, f.geometry().asPoint().x(), f.geometry().asPoint().y()), f["KELAS"]) for f in latih.getFeatures()]
tr = np.array([p[0] for p in pl])
yl = np.array([p[1] for p in pl])
pakai_latih = np.zeros(acuan.shape, bool)
pakai_latih[tr[:, 0], tr[:, 1]] = True

# peta B: hanya 7 fitur NDVI (band 1 sampai 7 pada tumpukan fitur)
idx = list(range(7))
mB = RandomForestClassifier(n_estimators=100, random_state=1).fit(st[idx][:, tr[:, 0], tr[:, 1]].T, yl)
petaB = mB.predict(st[idx].reshape(len(idx), -1).T).reshape(acuan.shape).astype("uint8")
jB = os.path.join(U.HASIL, "peta_ndvi_saja.tif")
U.tulis_tif(jB, petaB, gt, prj, nodata=0)
jA = os.path.join(U.HASIL, "peta_rf.tif")


def sampel_berstrata(peta, seed):
    """Sampel acak berstrata: N_STRATUM piksel acak dari tiap kelas peta, di luar titik latih.
    Padanan di antarmuka QGIS: poligonkan peta, lebur per kelas, lalu Random points in polygons (hasil tiap jalan tidak identik)."""
    rng = np.random.default_rng(seed)
    hasil = {}
    for k in np.unique(peta):
        if k == 0:
            continue
        kand = np.argwhere((peta == k) & ~pakai_latih)
        pilih = rng.choice(len(kand), size=min(N_STRATUM, len(kand)), replace=False)
        hasil[int(k)] = [((int(kand[p][0]), int(kand[p][1])), int(acuan[kand[p][0], kand[p][1]])) for p in pilih]
    return hasil

def analisis(peta, sampel, nama, cetak=True):
    kelas = sorted(sampel)
    pop = peta[~pakai_latih]                          # populasi sampel = piksel di luar titik latih
    A = pop.size * LUAS_PIKSEL
    W = {k: (pop == k).sum() / pop.size for k in kelas}
    n = {k: len(sampel[k]) for k in kelas}
    nij = np.zeros((len(kelas), len(kelas)))
    for a, k in enumerate(kelas):
        for _, r in sampel[k]:
            if r in kelas:
                nij[a, kelas.index(r)] += 1
    p = np.array([[W[k] * nij[a, b] / n[k] for b in range(len(kelas))] for a, k in enumerate(kelas)])
    oa = np.trace(p)
    ua = np.diag(p) / p.sum(1)
    pa = np.diag(p) / np.maximum(p.sum(0), 1e-12)
    # piksel titik latih sudah punya label pasti: luasnya ditambahkan apa adanya
    luas_peta = np.array([(peta == k).sum() * LUAS_PIKSEL for k in kelas])
    luas_adj = p.sum(0) * A + np.array([(acuan[pakai_latih] == k).sum() * LUAS_PIKSEL for k in kelas])
    se = np.array([np.sqrt(sum(W[ki] ** 2 * (nij[a, b] / n[ki]) * (1 - nij[a, b] / n[ki]) / (n[ki] - 1) for a, ki in enumerate(kelas))) for b in range(len(kelas))]) * A
    if cetak:
        print("\n=== %s: %d sampel; baris = kelas peta, kolom = kelas acuan ===" % (nama, nij.sum()))
        print("          " + " ".join("%5d" % k for k in kelas))
        for a, k in enumerate(kelas):
            print("kelas %d   " % k + " ".join("%5d" % v for v in nij[a]) + "   | n=%d" % n[k])
        print("Akurasi keseluruhan (berbobot luas): %.3f" % oa)
        print("%-14s %8s %8s %10s %12s %10s" % ("Kelas", "UA", "PA", "luas peta", "luas terkoreksi", "+/- 95%"))
        for a, k in enumerate(kelas):
            print("%-14s %8.2f %8.2f %9.2f ha %11.2f ha %8.2f ha" % (NAMA[k], ua[a], pa[a], luas_peta[a], luas_adj[a], 1.96 * se[a]))
    return oa, kelas, luas_adj, se


for nama, jalur in (("Peta A (12 fitur)", jA), ("Peta B (NDVI saja)", jB)):
    peta, _, _ = U.baca_tif(jalur)
    oa, kelas, luas_adj, se = analisis(peta, sampel_berstrata(peta, 11), nama)
    print("Luas acuan sebenarnya: " + ", ".join("%s %.2f" % (NAMA[k], (acuan == k).sum() * LUAS_PIKSEL) for k in (6, 7)))
    # kestabilan terhadap pengundian sampel
    oas = [analisis(peta, sampel_berstrata(peta, s), nama, cetak=False)[0] for s in range(21, 26)]
    print("Akurasi keseluruhan pada 5 undian sampel lain: " + ", ".join("%.3f" % v for v in oas))
Penjelasan baris demi baris. Statistiknya sengaja dijelaskan dengan kata-kata dulu, bukan rumus.
| Baris | Tulisan | Artinya |
|---|---|---|
| 6-9 | import os sampai import m3_umum as U | Perkakas. |
| 11-14 | try: ... except ImportError: | Seperti Skrip 26.13, tetapi tanpa pesan. |
| 16 | NAMA = {...} | Kamus nomor kelas ke nama kelas. |
| 17-18 | N_STRATUM = 20 dan LUAS_PIKSEL = 0.01 | Dua konstanta: sampel per kelas peta, dan luas satu piksel (hektare). Angka kedua dikunci untuk piksel 10 meter. |
| 20-21 | st, gt, prj = ... dan acuan, _, _ = ... | Baca tumpukan fitur dan peta acuan. |
| 22 | latih = QgsVectorLayer(...) | Layer titik latih. |
| 23 | pl = [(U.xy_ke_piksel(...), f["KELAS"]) for f in latih.getFeatures()] | Untuk tiap titik latih: pasangan (baris dan kolom piksel, kelas). Hasil: daftar 200 pasangan. |
| 24-25 | tr = np.array([p[0] for p in pl]) dan yl = ... | tr berisi nomor baris dan kolom, yl berisi kelas. |
| 26-27 | pakai_latih = np.zeros(acuan.shape, bool) lalu pakai_latih[tr[:, 0], tr[:, 1]] = True | Larik benar atau salah berukuran peta, benar hanya di 200 piksel titik latih. Piksel itu tidak boleh dipakai sebagai sampel uji. |
| 30 | idx = list(range(7)) | Nomor tujuh fitur pertama: fitur NDVI. |
| 31 | mB = RandomForestClassifier(...).fit(st[idx][:, tr[:, 0], tr[:, 1]].T, yl) | Latih hutan untuk Peta B memakai hanya tujuh fitur, pada piksel titik latih. |
| 32 | petaB = mB.predict(st[idx].reshape(len(idx), -1).T).reshape(acuan.shape).astype("uint8") | Petakan seluruh area dengan hutan itu, pola yang sama seperti Skrip 26.13. |
| 33-35 | jB = ..., U.tulis_tif(...), jA = ... | Simpan Peta B, dan catat jalur Peta A (hasil Skrip 26.13). |
| 38-49 | def sampel_berstrata(peta, seed): | Fungsi pengambil sampel. Docstring baris 39-40 menjelaskan tujuannya. |
| 41-42 | rng = ... dan hasil = {} | Pengacak dengan benih dari masukan, dan kamus hasil. |
| 43-45 | for k in np.unique(peta): lalu if k == 0: continue | Telusuri tiap kelas di peta. Kelas 0 (kosong) dilewati. |
| 46 | kand = np.argwhere((peta == k) & ~pakai_latih) | Daftar piksel kandidat kelas k yang bukan titik latih. |
| 47 | pilih = rng.choice(len(kand), size=min(N_STRATUM, len(kand)), replace=False) | Undi sampai 20 kandidat tanpa pengembalian. min(...) mencegah meminta lebih banyak dari yang ada. |
| 48 | hasil[int(k)] = [((baris, kolom), kelas acuan) for p in pilih] | Simpan, untuk tiap sampel, lokasinya dan kelas acuan-nya. Angka dibungkus int(...) agar jadi bilangan Python biasa. |
| 49 | return hasil | Kembalikan kamus sampel. |
| 51 | def analisis(peta, sampel, nama, cetak=True): | Fungsi analisis. cetak=True adalah nilai bawaan: bila False, tidak ada yang dicetak. |
| 52-54 | kelas = sorted(sampel), pop = peta[~pakai_latih], A = pop.size * LUAS_PIKSEL | Daftar kelas, populasi (semua piksel selain titik latih), dan luas populasi dalam hektare. |
| 55 | W = {k: (pop == k).sum() / pop.size for k in kelas} | Bobot luas tiap kelas: pecahan populasi yang dipetakan sebagai kelas itu. |
| 56 | n = {k: len(sampel[k]) for k in kelas} | Banyak sampel tiap kelas. |
| 57-61 | nij = np.zeros(...) lalu dua putaran | Isi matriks kebingungan: baris kelas peta, kolom kelas acuan. kelas.index(r) mencari nomor kolom. Sampel yang kelas acuannya di luar daftar tidak dihitung. |
| 62 | p = np.array([[W[k] * nij[a, b] / n[k] ...]]) | Ubah hitungan menjadi proporsi luas: tiap sel dikali bobot kelas petanya, lalu dibagi banyak sampelnya. |
| 63-65 | oa = np.trace(p), ua = ..., pa = ... | oa adalah akurasi keseluruhan (jumlah diagonal). ua adalah akurasi pengguna per kelas. pa adalah akurasi produsen per kelas. np.maximum(..., 1e-12) mencegah bagi nol. |
| 66-68 | luas_peta = ... dan luas_adj = ... | Luas menurut peta, dan luas terkoreksi: jumlah kolom p dikali luas populasi, ditambah luas titik latih menurut acuan (apa adanya). |
| 69 | se = np.array([np.sqrt(sum(...)) ...]) * A | Galat baku luas tiap kelas. Rumus panjang, dibentuk dari proporsi tiap sel dan banyak sampel. |
| 70-78 | if cetak: lalu beberapa print | Cetak matriks, akurasi keseluruhan, dan tabel UA, PA, luas, serta rentang 95 persen (1,96 kali galat baku). |
| 79 | return oa, kelas, luas_adj, se | Kembalikan empat hasil. |
| 82 | for nama, jalur in (("Peta A (12 fitur)", jA), ("Peta B (NDVI saja)", jB)): | Ulangi untuk dua peta. |
| 83-85 | peta, _, _ = ..., oa, kelas, luas_adj, se = analisis(peta, sampel_berstrata(peta, 11), nama), print(...) | Baca peta, ambil sampel (benih 11), analisis, dan cetak luas acuan sebenarnya untuk deforestasi dan terbakar. |
| 87-88 | oas = [analisis(..., cetak=False)[0] for s in range(21, 26)] dan print(...) | Ulangi pengambilan sampel dengan lima benih lain, dan kumpulkan hanya akurasi keseluruhannya ([0]). Cetak lima angka itu untuk melihat kestabilan. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2, tanpa scikit-learn):
=== Peta A (12 fitur): 158 sampel; baris = kelas peta, kolom = kelas acuan ===
              1     2     3     4     5     6     7     8
kelas 1      20     0     0     0     0     0     0     0   | n=20
kelas 2       0    20     0     0     0     0     0     0   | n=20
kelas 3       0     0    20     0     0     0     0     0   | n=20
kelas 4       0     0     0    20     0     0     0     0   | n=20
kelas 5       0     0     0     0    18     0     0     0   | n=18
kelas 6       0     0     0     0     0    20     0     0   | n=20
kelas 7       1     0     0     0     0     0    19     0   | n=20
kelas 8       0     0     0     0     0     0     0    20   | n=20
Akurasi keseluruhan (berbobot luas): 0.995
Kelas                UA       PA  luas peta luas terkoreksi    +/- 95%
Hutan alam         1.00     0.99      7.99 ha        8.05 ha     0.12 ha
Hutan tanaman      1.00     1.00      0.96 ha        0.96 ha     0.00 ha
Pertanian          1.00     1.00      1.80 ha        1.80 ha     0.00 ha
Air                1.00     1.00      0.80 ha        0.80 ha     0.00 ha
Terbuka            1.00     1.00      0.43 ha        0.43 ha     0.00 ha
Deforestasi        1.00     1.00      1.30 ha        1.30 ha     0.00 ha
Terbakar           0.95     1.00      1.52 ha        1.46 ha     0.12 ha
Panen HTI          1.00     1.00      1.20 ha        1.20 ha     0.00 ha
Luas acuan sebenarnya: Deforestasi 1.30, Terbakar 1.51
Akurasi keseluruhan pada 5 undian sampel lain: 0.995, 1.000, 1.000, 1.000, 1.000

=== Peta B (NDVI saja): 158 sampel; baris = kelas peta, kolom = kelas acuan ===
              1     2     3     4     5     6     7     8
kelas 1      20     0     0     0     0     0     0     0   | n=20
kelas 2       0    20     0     0     0     0     0     0   | n=20
kelas 3       0     0    20     0     0     0     0     0   | n=20
kelas 4       0     0     0    20     0     0     0     0   | n=20
kelas 5       0     0     0     0    18     0     0     0   | n=18
kelas 6       0     0     0     0     0    20     0     0   | n=20
kelas 7      10     0     0     0     0     0    10     0   | n=20
kelas 8       0     0     0     0     0     0     0    20   | n=20
Akurasi keseluruhan (berbobot luas): 0.915
Kelas                UA       PA  luas peta luas terkoreksi    +/- 95%
Hutan alam         1.00     0.85      6.87 ha        8.07 ha     0.54 ha
Hutan tanaman      1.00     1.00      0.96 ha        0.96 ha     0.00 ha
Pertanian          1.00     1.00      1.80 ha        1.80 ha     0.00 ha
Air                1.00     1.00      0.80 ha        0.80 ha     0.00 ha
Terbuka            1.00     1.00      0.43 ha        0.43 ha     0.00 ha
Deforestasi        1.00     1.00      1.30 ha        1.30 ha     0.00 ha
Terbakar           0.50     1.00      2.64 ha        1.44 ha     0.54 ha
Panen HTI          1.00     1.00      1.20 ha        1.20 ha     0.00 ha
Luas acuan sebenarnya: Deforestasi 1.30, Terbakar 1.51
Akurasi keseluruhan pada 5 undian sampel lain: 0.940, 0.917, 0.874, 0.889, 0.925
Bandingkan dua peta. Peta A hampir sempurna: akurasi keseluruhan 0,995 dan luas terbakar terkoreksi 1,46 hektare, dekat dengan acuan 1,51 hektare. Peta B (hanya NDVI) lebih lemah: akurasi 0,915. Lihat baris kelas 7 pada matriks Peta B: dari 20 sampel yang peta sebut Terbakar, hanya 10 yang benar terbakar dan 10 adalah hutan alam. Akurasi penggunanya 0,50. Luas terbakar menurut peta B adalah 2,64 hektare, sekitar 1,7 kali luas acuan (1,51 hektare). Setelah dikoreksi, luasnya 1,44 hektare dengan rentang plus minus 0,54. Kesimpulan: luas dari peta mentah bisa jauh meleset, dan koreksi luas memperbaikinya. Lima undian ulang menunjukkan Peta B kurang stabil (0,874 sampai 0,940), sedangkan Peta A hampir tidak bergeser.
Bagian yang boleh diubah.
- Baris 17,
N_STRATUM. Jumlah sampel per kelas. Saya mengubahnya menjadi10: sampel Peta A turun menjadi 80 dan akurasi keseluruhan naik menjadi 1,000. Akurasi Peta B menjadi 0,863, dan lima undian ulangnya melebar (0,881 sampai 0,983). Sampel yang lebih sedikit membuat angka lebih goyah. - Baris 84 dan 87, benih. Ganti benih 11 atau rentang
range(21, 26)untuk undian lain. - Baris 30,
range(7). Daftar fitur untuk Peta B. Ganti untuk menguji kelompok fitur lain.
Jebakan.
- Sampel kecil menghasilkan angka
nan. Galat baku membagi dengann - 1. Saya mengubahN_STRATUMmenjadi1: layar tetap menampilkan tabel, tetapi kolom rentang berisinan ha, tanpa galat. Skrip diam. Bila ada kelas dengan satu sampel, jangan percaya rentangnya. - Titik latih dikeluarkan dari populasi. Itu sengaja, supaya tidak menguji dengan soal yang sudah dipelajari. Akibatnya, luas terkoreksi menambah luas titik latih "apa adanya" (baris 68). Bentuk ini tidak persis sama dengan rumus bakunya [CEK].
- Rumus statistik tidak dinamai di skrip. Pendekatannya mirip penaksir berstrata yang dibahas Olofsson dan kawan-kawan (2014, Remote Sensing of Environment 148: 42-57). Saya hanya memastikan artikel itu ada, dan belum mencocokkan rumus baris demi baris dengan skrip [CEK].
- Dua peta, satu pengujian. Peta A harus sudah dibuat Skrip 26.13, dan tumpukan fitur harus sudah dibuat Skrip 26.12.
- Nomor fitur dikunci. Baris 30 mengandaikan tujuh fitur pertama adalah fitur NDVI.
- Luas 0,01 hektare per piksel dikunci.
Latihan variasi.
- Kurangi sampel per kelas menjadi 10.
- Lihat apakah akurasi Peta B bertambah goyah.
Contoh jawaban, hanya baris 17:
N_STRATUM = 10 # sampel per kelas petaLayar menampilkan Akurasi keseluruhan (berbobot luas): 0.863 untuk Peta B, dan lima undian ulang 0.881, 0.915, 0.915, 0.983, 0.915. Rentang undian ulang (0,881 sampai 0,983) lebih lebar daripada yang asli (0,874 sampai 0,940). Jadi, Peta B menjadi lebih goyah.
Cek paham #
- Mengapa grafik NDVI hutan alam di Skrip 26.2 sering jatuh ke nol, padahal hutannya utuh?
- Mengapa uji silang blok (Skrip 26.13) memberi akurasi jauh lebih rendah daripada uji silang acak?
- Skrip 26.9 menyimpan tanggal sebagai bilangan seperti 20241115. Mengapa baris 54 harus menyebut
tipe=gdal.GDT_Int32, dan apa yang terjadi bila Anda membuang bagian itu?
Jawaban.
- Awan dan bayangannya ikut terhitung sebagai permukaan, sehingga NDVI jatuh pada tanggal berawan. Hutannya tidak hilang. Kelompok B membuang atau menambal piksel itu.
- Pada uji acak, tetangga dekat bisa ada di kedua sisi, jadi mesin "mengintip" jawabannya. Pada uji blok, blok yang diuji benar-benar asing bagi mesin. Angka blok lebih jujur untuk data berlokasi.
- Fungsi
U.tulis_tifmemberi tipe Byte (0 sampai 255) untuk semua larik non-desimal, jadi 20241115 terpotong menjadi 255. Dengantipe=gdal.GDT_Int32di baris 54 Skrip 26.9, berkas menyimpan tanggal utuh. Skrip tidak mengeluh dalam kedua kasus, jadi tipe berkas harus diperiksa sendiri.
Kesalahan umum #
- Menjalankan skrip tanpa skrip pendahulunya. Skrip 26.4 berhenti dengan pesan bila masukannya tidak ada, tetapi tidak semua skrip dijaga begitu. Perbaikan: ikuti tabel urutan di awal bab, dan cocokkan angka keluaran dengan contoh di bab.
- Lupa menghapus hasil lama sebelum mengulang. Alat Polygonize menambah poligon ke berkas yang ada. Skrip 26.8 dan 26.11 sudah menghapus
.gpkglama lebih dulu. Bila Anda menulis skrip sendiri dengan alat ini, tambahkan penghapusan yang sama. - Mempercayai satu ambang atau satu akurasi. Ambang literatur belum tentu cocok untuk data Anda (Skrip 26.10), dan uji silang acak terlalu manis (Skrip 26.13). Perbaikan: uji beberapa ambang, dan pakai uji blok serta sampel berstrata.
- Membiarkan angka yang dikunci untuk data contoh. Ukuran 40 kali 40, luas 0,01 hektare per piksel, dan batas koordinat tertulis langsung di kode. Perbaikan: gunakan tabel di bawah ini sebagai daftar periksa saat Anda mengganti data.
| Skrip | Hal yang dikunci | Letak |
|---|---|---|
26.8 (4_1) | Batas area, piksel 10 meter, ukuran 40, luas 0,01 hektare, pembagian KPH tiruan | baris 29, 41, 46-49 |
26.9 (4_2) | Tanggal sebenarnya dua bukaan dan pembagian wilayah | baris 56-57 |
26.10 (5_1) | Nomor tanggal sebelum dan sesudah, ukuran 40, luas 0,01 hektare | baris 34, 37-38, 54, 59, 64 |
26.13 (6_2) | Empat lipatan dan batas blok 312200 dan 9996200, luas 0,01 hektare | baris 31, 36, 62 |
26.14 (7_1) | Luas piksel 0,01 hektare dan tujuh fitur pertama | baris 18, 30 |
m3_umum.py | Jalur cadangan dan tipe data Byte untuk bilangan bulat | baris 14-15, 65-66 |
Ringkasan dan latihan #
- Deret waktu adalah tumpukan citra bertanggal. Tiap piksel punya riwayat angka yang bisa dibaca.
- Pembersihan awan memakai tiga cara: buang (mask), gabung (median), dan tambal (interpolasi).
- Deteksi perubahan punya dua cara: dua waktu (cepat, tanpa tanggal) dan titik patah (menyebut tanggal).
- Kebakaran lebih jelas terlihat di NBR daripada di NDVI. Titik panas adalah petunjuk, bukan peta bekas bakar.
- Mesin belajar butuh fitur. Uji blok memberi angka yang lebih jujur, dan validasi dengan sampel berstrata memberi luas terkoreksi.
- Skrip yang jalan tanpa galat belum tentu benar. Cocokkan angkanya.
Latihan. Gabungkan tiga skrip. Jalankan Skrip 26.1, 26.4, dan 26.5 untuk periode "kemarau2025" (tanggal ke-17 sampai ke-20). Lalu hitung dNDVI antara komposit "sebelum" dan "kemarau2025" dengan pola Skrip 26.8. Bagian mana dari Skrip 26.8 yang harus Anda ganti, dan bagian mana yang boleh dibiarkan?
Tabel perbandingan: pekerjaan, skrip, dan perkakas Python #
| Pekerjaan | Skrip | Perkakas Python yang paling berperan |
|---|---|---|
| Menyusun tumpukan | 26.1 sampai 26.3 | for dan tuple, processing.run, gdal |
| Membersihkan awan | 26.4 sampai 26.6 | ekspresi kalkulator raster, irisan daftar, fungsi buatan sendiri, np.interp |
| Mengukur irama | 26.7 | larik NumPy dan sumbu, kamus kelas, mask benar-salah |
| Hutan hilang | 26.8 dan 26.9 | konstanta, continue dan break, fungsi dengan nilai bawaan |
| Jejak api | 26.10 dan 26.11 | kamus berisi tuple, zip(*...), Counter |
| Mesin belajar | 26.12 dan 26.13 | kamus fitur, try ... except ImportError, kelas dan rekursi (hutan_mini) |
| Validasi | 26.14 | comprehension, fungsi dengan banyak hasil, sampel acak berstrata |