BAB 19: Piksel Bicara Angka: Analisis Raster dan Klasifikasi Citra dengan Skrip
Studi kasus: "Seberapa tinggi, seberapa curam, lahan apa?" #
Kepala Seksi mengirim tiga pertanyaan sekaligus. Seberapa luas tajuk pohon yang tingginya lima meter atau lebih? Petak mana yang terlalu curam? Lalu lahan apa saja yang ada di citra baru, dan seberapa bisa peta lahannya dipercaya? Anda bisa menjawabnya lewat menu QGIS satu per satu. Tetapi bulan depan datang citra baru dan pertanyaannya sama. Dengan skrip, Anda cukup mengganti jalur data.
Konsep: raster dalam skrip, dalam tiga kalimat #
Raster itu kertas berpetak, dan tiap petak menyimpan satu angka, misalnya tinggi tanah atau pantulan cahaya. Skrip mengolah angka-angka itu dengan dua cara. Cara pertama, Anda memanggil alat QGIS lewat processing.run, seperti menekan tombol di Processing Toolbox. Cara kedua, Anda memuat angka ke NumPy lalu menghitungnya sendiri.
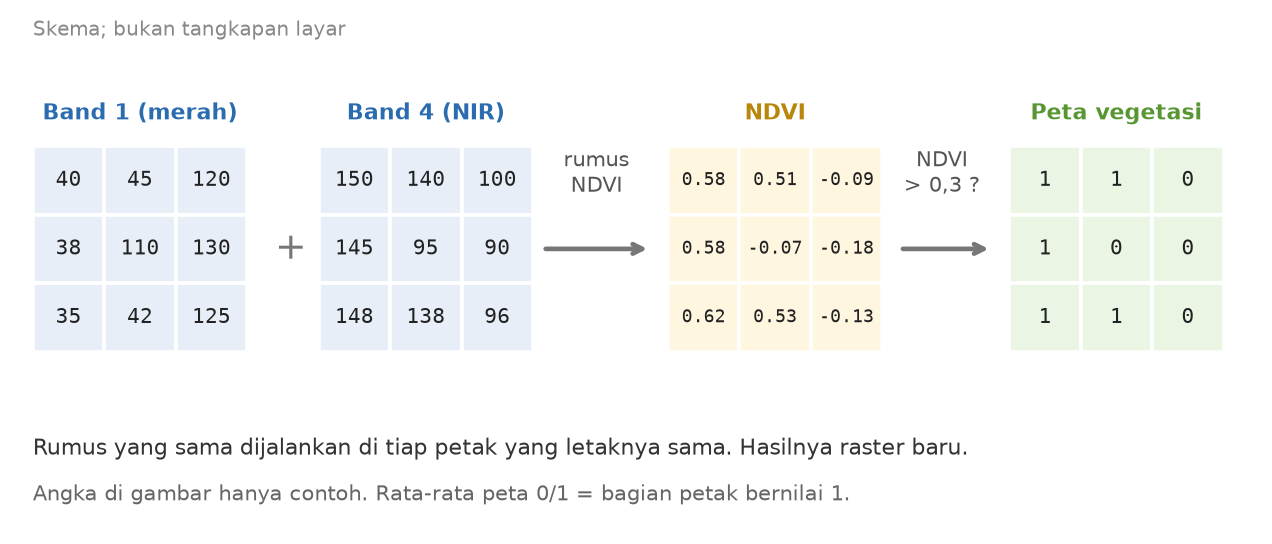
Lima istilah yang perlu Anda kenal sekarang:
- Piksel: satu petak raster, yang menyimpan satu angka.
- Band: satu lapis angka di dalam raster. Citra berwarna punya beberapa band, misalnya merah, hijau, biru, dan inframerah.
processing.run: perintah untuk menjalankan alat Processing QGIS dari skrip.- Array NumPy: tabel angka di memori yang bisa dihitung sekaligus. Pustaka NumPy dibahas di Bab 12.
- GDAL (di Python bernama
osgeo): pustaka pembaca dan penulis berkas raster.
Dua cara bekerja, dan urutan ketujuh skrip #
| Cara kerja | Alat yang dipakai | Dipakai di skrip |
|---|---|---|
| Panggil alat QGIS | processing.run("native:...") | 19.1, 19.2, 19.3, 19.7 |
| Hitung sendiri | NumPy dan GDAL | 19.4, 19.5 |
| Campuran | Alat QGIS dan NumPy bersama | 19.6 |
Skrip 19.1 berdiri sendiri. Skrip lain saling memberi berkas hasil, seperti gambar berikut.
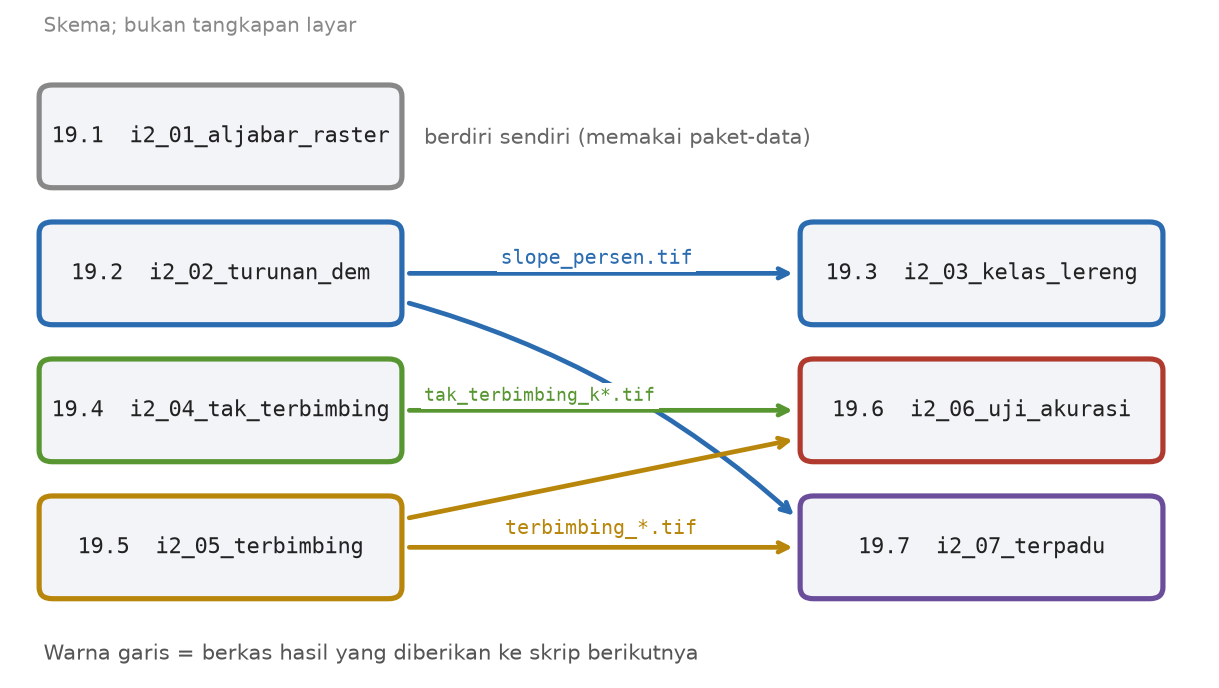
Jalankan berurutan: 19.1, 19.2, 19.3, 19.4, 19.5, 19.6, 19.7. Bila Anda melompat, skrip berikutnya tidak menemukan berkas yang ia butuhkan.
Siapkan dulu: data, folder, dan tempat menjalankan #
- Siapkan dua paket data. Paket
paket-i2memuatDEM_Lereng.tif,Citra_Lahan.tif,Area_Latih.gpkg, danTitik_Uji.gpkg. Paketpaket-datamemuatCitra_Komposit.tif,DSM_Drone.tif,DTM_Drone.tif, danBatas_KPH.gpkg. - Putuskan satu folder hasil di komputer Anda. Skrip menulis semua peta hasil ke sana.
- Buka Plugins ► Python Console, klik Show Editor, lalu buka skrip. Cara ini dijelaskan di Bab 3.
- Ganti jalur di bagian atas skrip, lalu klik Run.
Satu hal lagi: ketujuh skrip memakai modul processing, yang hanya ada di dalam QGIS. Bila Anda menjalankannya dari terminal python-qgis biasa, muncul ModuleNotFoundError: No module named 'processing'. Pakai Editor Skrip QGIS. Nomor skrip di bab ini (19.1 dan seterusnya) mengikuti bab ini. Di dalam berkas, nomor yang tertulis mengikuti Buku I2 (Bab 1 sampai Bab 6).
Skrip 19.1: Berhitung dengan piksel #
Berkas i2_01_aljabar_raster.py. Di dalam berkasnya tertulis "I2 Bab 1".
Tujuan. Menghitung NDVI (indeks kehijauan), menandai piksel bervegetasi, menghitung tinggi tajuk dari dua raster drone, lalu menandai tajuk setinggi lima meter atau lebih.
Bahan. Paket paket-data: Citra_Komposit.tif (300 x 300 piksel, 1 m, empat band), DSM_Drone.tif dan DTM_Drone.tif (masing-masing 800 x 800 piksel, 0,5 m). Skrip dijalankan dari Editor Skrip QGIS.
Lima istilah baru untuk skrip ini:
- NDVI: angka kehijauan tiap piksel, dihitung dari band inframerah dekat (NIR) dan band merah. Makin hijau, makin besar. Rumusnya (NIR dikurangi R) dibagi (NIR ditambah R).
- DSM: model tinggi permukaan, yaitu puncak pohon dan atap. DTM: model tinggi tanah saja.
- CHM: tinggi tajuk, yaitu DSM dikurangi DTM.
- Ekspresi: rumus yang Anda tulis untuk Raster Calculator, misalnya
"A@1" - "B@1". Bentuk"nama@1"berarti layer bernamanama, band 1. - Alat native:rastercalc: nama alat Raster Calculator bila dipanggil dari skrip.
Skrip ini bekerja dalam enam tahap, dengan nomor baris seperti di gambar.
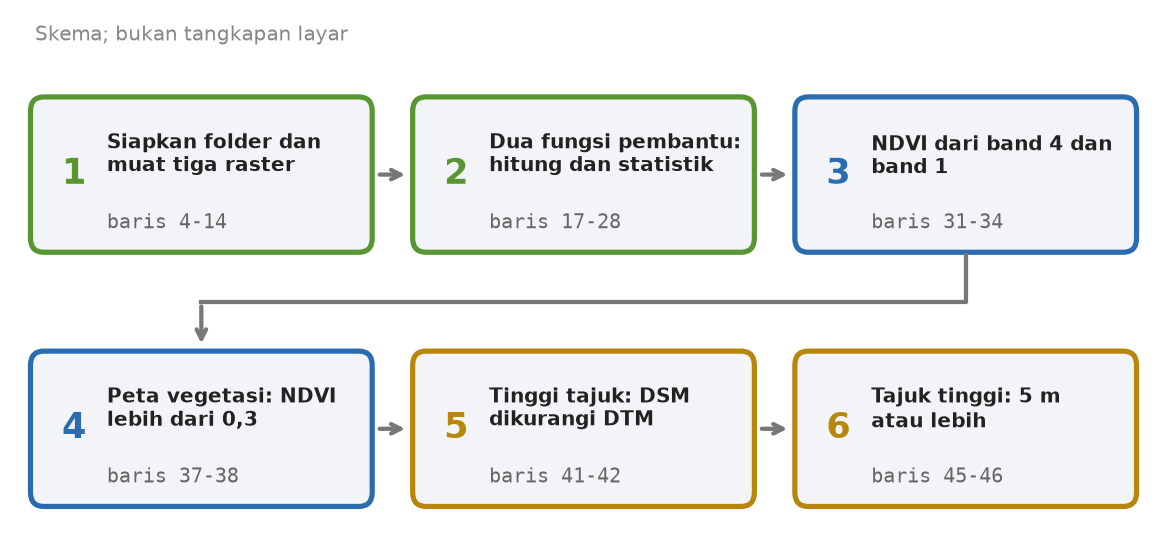
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 1: aljabar raster (NDVI, tinggi tajuk, mask). Penulis: Badar Mubarok Yogaswara
# Jalankan di Python Console QGIS. Ubah dua jalur di bawah sesuai komputer Anda.
import os
import processing
from qgis.core import QgsRasterLayer, QgsProcessingFeedback

PAKET = os.environ.get("I2_DATA", r"C:/KPH_Contoh/paket-data")     # folder paket-data
HASIL = r"C:/temp/hasil_i2"                                                      # folder hasil (dibuat bila belum ada)
os.makedirs(HASIL, exist_ok=True)

citra = QgsRasterLayer(os.path.join(PAKET, "Citra_Komposit.tif"), "Citra_Komposit")
dsm = QgsRasterLayer(os.path.join(PAKET, "DSM_Drone.tif"), "DSM_Drone")
dtm = QgsRasterLayer(os.path.join(PAKET, "DTM_Drone.tif"), "DTM_Drone")


def hitung(ekspresi, layers, keluar, ref):
    """Menjalankan Raster calculator dengan ukuran sel, luas, dan CRS mengikuti layer acuan."""
    return processing.run("native:rastercalc", {
        "EXPRESSION": ekspresi, "LAYERS": layers,
        "CELL_SIZE": ref.rasterUnitsPerPixelX(), "EXTENT": ref.extent(), "CRS": ref.crs(),
        "OUTPUT": os.path.join(HASIL, keluar)})["OUTPUT"]


def statistik(jalur, band=1):
    lyr = QgsRasterLayer(jalur, "x")
    s = lyr.dataProvider().bandStatistics(band)
    return s.minimumValue, s.maximumValue, s.mean, s.stdDev


# 1) NDVI = (NIR - R) / (NIR + R); band 1 = R, band 4 = NIR
ndvi = hitung('("Citra_Komposit@4" - "Citra_Komposit@1") / ("Citra_Komposit@4" + "Citra_Komposit@1")',
              [citra], "ndvi.tif", citra)
print("NDVI min, maks, rata-rata, simpangan baku:", [round(v, 3) for v in statistik(ndvi)])

# 2) NDVI > 0,3 menjadi 1 (vegetasi) dan selain itu 0
veg = hitung('"ndvi@1" > 0.3', [QgsRasterLayer(ndvi, "ndvi")], "veg.tif", citra)
print("Rata-rata veg (=bagian piksel bervegetasi):", round(statistik(veg)[2], 4))

# 3) tinggi tajuk (CHM) = DSM - DTM
chm = hitung('"DSM_Drone@1" - "DTM_Drone@1"', [dsm, dtm], "chm.tif", dsm)
print("CHM min, maks, rata-rata:", [round(v, 2) for v in statistik(chm)[:3]])

# 4) tajuk tinggi: tinggi >= 5 m
tinggi = hitung('"chm@1" >= 5', [QgsRasterLayer(chm, "chm")], "tajuk_tinggi.tif", dsm)
print("Bagian piksel dengan tinggi >= 5 m:", round(statistik(tinggi)[2], 4))
Penjelasan baris demi baris. Skrip ini panjang, jadi penjelasannya dibagi tiga blok. Nomor baris mengikuti berkas di atas.
Blok A: baris 1 sampai 14, persiapan.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-3 | # -*- coding: utf-8 -*- dan dua komentar | Komentar. Baris 1 memberi tahu Python bahwa berkas memakai huruf UTF-8, agar huruf Indonesia terbaca benar. Baris 2-3 memuat judul, nama penulis, dan pesan: ubah dua jalur. |
| 4 | import os | Panggil perkakas os untuk urusan folder dan jalur (Bab 8). |
| 5 | import processing | Panggil modul processing, tempat perintah processing.run. Hanya ada di dalam QGIS. |
| 6 | from qgis.core import QgsRasterLayer, QgsProcessingFeedback | Panggil dua perkakas QGIS. QgsRasterLayer membuka raster. QgsProcessingFeedback tidak dipakai di skrip ini. Ia sisa dan tidak berpengaruh. |
| 8 | PAKET = os.environ.get("I2_DATA", r"C:/KPH_Contoh/paket-data") | Isi kotak PAKET dengan lokasi folder paket-data. os.environ.get membaca variabel lingkungan I2_DATA; bila belum diatur, dipakai alamat bawaan di belakangnya. Huruf r di depan kutip membuat teks dibaca apa adanya. Atur variabelnya atau ganti alamat bawaan. |
| 9 | HASIL = r"C:/temp/hasil_i2" | Lokasi folder hasil. Ganti sesuai komputer Anda. |
| 10 | os.makedirs(HASIL, exist_ok=True) | Buat folder hasil bila belum ada. Bagian exist_ok=True berarti: bila sudah ada, tidak apa-apa. |
| 12-14 | citra = QgsRasterLayer(os.path.join(PAKET, "Citra_Komposit.tif"), "Citra_Komposit") | Buka tiga raster ke kotak citra, dsm, dan dtm. os.path.join menyambung folder dengan nama berkas. Isian kedua adalah nama layer di QGIS. Nama ini dipakai lagi di dalam rumus. |
Blok B: baris 17 sampai 28, dua fungsi pembantu. Fungsi adalah resep bernama yang bisa dipakai berulang (Bab 7). Skrip ini menulis dua resep, lalu memakainya empat kali.
| Baris | Tulisan | Artinya |
|---|---|---|
| 17 | def hitung(ekspresi, layers, keluar, ref): | Mulai resep bernama hitung. Ia menerima empat bahan: rumus, daftar layer, nama berkas hasil, dan layer acuan. |
| 18 | """Menjalankan Raster calculator ...""" | Docstring, yaitu catatan satu kalimat tentang apa yang dikerjakan fungsi. |
| 19-22 | return processing.run("native:rastercalc", {...})["OUTPUT"] | Jalankan alat Raster Calculator. Isi kurung kurawal adalah pengaturan alat. EXPRESSION rumus. LAYERS layer yang dipakai rumus. CELL_SIZE, EXTENT, dan CRS (ukuran piksel, luas area, sistem koordinat) meniru layer acuan. OUTPUT jalur berkas hasil. ["OUTPUT"] di ujung mengambil jalur itu dari jawaban alat, dan return mengirimnya kembali. |
| 25 | def statistik(jalur, band=1): | Resep kedua. Bagian band=1 adalah nilai bawaan: bila Anda tidak menyebut band, ia memakai band 1. |
| 26-27 | lyr = QgsRasterLayer(jalur, "x") dan s = ...bandStatistics(band) | Buka raster hasil, lalu minta QGIS menghitung statistik band. Nama layer x tidak penting di sini. |
| 28 | return s.minimumValue, s.maximumValue, s.mean, s.stdDev | Kembalikan empat angka sekaligus: terkecil, terbesar, rata-rata, dan simpangan baku (ukuran sebaran). Empat angka yang dipisah koma menjadi satu paket, yang disebut tuple (Bab 5). |
Blok C: baris 31 sampai 46, empat perhitungan.
| Baris | Tulisan | Artinya |
|---|---|---|
| 32-33 | ndvi = hitung('(...)', [citra], "ndvi.tif", citra) | Hitung NDVI. Rumus diapit kutip tunggal supaya kutip ganda boleh dipakai di dalamnya. "Citra_Komposit@4" berarti layer Citra_Komposit, band 4 (NIR). Band 1 adalah merah. Hasilnya disimpan sebagai ndvi.tif, dan jalurnya masuk kotak ndvi. |
| 34 | print(..., [round(v, 3) for v in statistik(ndvi)]) | Ambil statistik NDVI, bulatkan tiap angka ke tiga desimal dengan list comprehension (Bab 6), lalu cetak daftarnya. |
| 37 | veg = hitung('"ndvi@1" > 0.3', [QgsRasterLayer(ndvi, "ndvi")], "veg.tif", citra) | Rumus perbandingan: hasilnya 1 bila NDVI lebih dari 0,3, selain itu 0. Layer ndvi dibuka dari berkas hasil tadi. Nama "ndvi" harus sama dengan nama di rumus. |
| 38 | print(..., round(statistik(veg)[2], 4)) | Angka [2] mengambil isi ketiga dari tuple, yaitu rata-rata (hitungan mulai dari 0). Rata-rata peta berisi 0 dan 1 sama dengan bagian piksel yang bernilai 1. |
| 41 | chm = hitung('"DSM_Drone@1" - "DTM_Drone@1"', [dsm, dtm], "chm.tif", dsm) | Kurangkan DTM dari DSM untuk mendapat tinggi tajuk. Ukuran piksel mengikuti dsm (0,5 m). |
| 42 | print(..., [round(v, 2) for v in statistik(chm)[:3]]) | Potongan [:3] mengambil tiga isi pertama: terkecil, terbesar, rata-rata. |
| 45-46 | tinggi = hitung('"chm@1" >= 5', ...) | Tandai piksel bertajuk lima meter atau lebih (1 atau 0), lalu cetak rata-ratanya. |
Hasil. Layar menampilkan (berdasarkan uji pada QGIS 4.0.2):
NDVI min, maks, rata-rata, simpangan baku: [-0.26, 0.899, 0.338, 0.281]
Rata-rata veg (=bagian piksel bervegetasi): 0.6666
CHM min, maks, rata-rata: [0.0, 13.96, 2.6]
Bagian piksel dengan tinggi >= 5 m: 0.1887
Dari hasil ini Anda tahu: sekitar dua pertiga piksel citra bervegetasi (0,6666). Tajuk tertinggi 13,96 m. Dan 18,87% piksel bertajuk lima meter atau lebih. Area drone berukuran 800 x 800 piksel, tiap piksel 0,5 m x 0,5 m, jadi luasnya 16 hektare. Luas tajuk tinggi kira-kira 0,1887 x 16 = 3,02 hektare. Itu jawaban untuk Kepala Seksi. [dihitung dari hasil skrip]
Bagian yang boleh diubah.
- Baris 8 dan 9, jalur. Ganti dengan lokasi
paket-datadan folder hasil di komputer Anda. - Baris 37, angka 0.3. Ambang kehijauan. Pada uji, ambang
0.5menurunkan rata-ratavegdari 0,6666 menjadi 0,4309. - Baris 45, angka 5. Ambang tinggi tajuk. Pada uji, ambang
10menurunkan rata-rata dari 0,1887 menjadi 0,0294. Kata "5 m" di teks baris 46 tidak ikut berubah, jadi ganti juga teksnya. - Baris 32, nomor band. Bila citra Anda menyimpan NIR di band lain, ubah angka setelah tanda
@. - Angka di round(...). Mengatur jumlah desimal yang tampil. Tidak memengaruhi berkas hasil.
Jebakan.
- Jalur data salah. Bila
PAKETmenunjuk folder yang tidak ada, skrip tidak berhenti di baris 12. Ia baru berhenti di baris 32 denganQgsProcessingException: Unable to execute algorithmdanIncorrect parameter value for EXTENT. Penyebabnya: layer tidak terbaca, sehingga luasnya kosong. Pelajarannya: bila galat menyebutEXTENT, curigai jalur data. - Nama layer dalam rumus berbeda. Bila rumus menulis
"Citra@4"padahal layernya bernamaCitra_Komposit, hasilnyaQgsProcessingException: Error occurred while performing calculation.Pesannya tidak menyebut nama yang salah. Samakan nama di baris 12-14 dengan nama di rumus. - Band 4 bertanda "Alpha". GDAL menandai band keempat berkas ini sebagai transparansi. Untuk hitungan, ia tetap angka biasa, jadi rumus NDVI benar. Tetapi saat menampilkan komposit warna, pakai band 1 sampai 3 saja. [CEK di tampilan QGIS Anda]
- Layer yang dibuat di dalam daftar. Pada baris 37 dan 45,
QgsRasterLayer(...)ditaruh langsung di dalam daftar tanpa kotak. Pada uji ini berhasil. Skrip 19.2 baris 28 memberi saran lebih aman: simpan layer di kotak sendiri agar tidak dibuang Python lebih awal. [kemungkinan]
Latihan variasi.
- Ganti ambang NDVI menjadi 0,5 dan ambang tajuk menjadi 10 meter. Lihat bagian piksel yang tersisa.
- Cetak luas tajuk tinggi dalam hektare, bukan bagian piksel.
Contoh jawaban nomor 1, hanya bagian yang berubah:
veg = hitung('"ndvi@1" > 0.5', [QgsRasterLayer(ndvi, "ndvi")], "veg.tif", citra)
tinggi = hitung('"chm@1" >= 10', [QgsRasterLayer(chm, "chm")], "tajuk_tinggi.tif", dsm)
Layar menampilkan 0.4309 untuk vegetasi dan 0.0294 untuk tajuk tinggi (tulisan "5 m" di baris 46 masih lama).
Contoh jawaban nomor 2, satu baris tambahan di akhir skrip asli:
print("Luas tajuk >= 5 m (ha):", round(statistik(tinggi)[2] * 640000 * 0.25 / 10000, 2))Layar menampilkan Luas tajuk >= 5 m (ha): 3.02. Angka 640000 adalah jumlah piksel, dan 0,25 adalah luas satu piksel dalam meter persegi.
Skrip 19.2: Membaca bentuk bumi dari DEM #
Berkas i2_02_turunan_dem.py. Di dalam berkasnya tertulis "I2 Bab 2".
Tujuan. Membuat peta kemiringan, arah lereng, dan bayangan bukit dari satu DEM, lalu mengubah kemiringan dari derajat menjadi persen dan mencetak statistik keempat peta.
Bahan. Paket paket-i2, berkas DEM_Lereng.tif (200 x 200 piksel, 2 m). Skrip dijalankan dari Editor Skrip QGIS.
Lima istilah baru untuk skrip ini:
- DEM: raster yang tiap pikselnya menyimpan tinggi tanah.
- Kemiringan (slope): seberapa miring permukaan, dalam derajat atau persen.
- Arah lereng (aspect): ke mana lereng menghadap, diukur dari utara searah jarum jam (90 derajat = timur, 180 = selatan).
- Bayangan bukit (hillshade): gambar bayangan seolah bukit disinari matahari.
- Faktor Z: pengali tinggi, dipakai bila satuan tinggi dan satuan peta berbeda. Di data ini sama-sama meter, jadi nilainya 1.
Skrip ini bekerja dalam lima tahap.
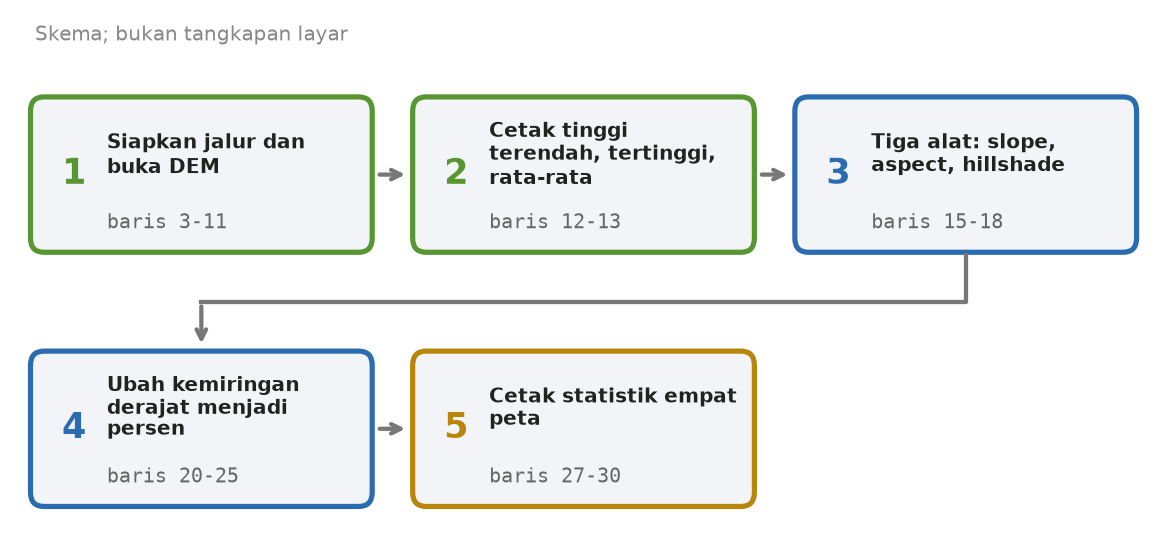
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 2: turunan DEM (kemiringan, arah lereng, bayangan bukit). Penulis: Badar Mubarok Yogaswara
import os
import processing
from qgis.core import QgsRasterLayer

PAKET_I2 = os.environ.get("I2_PAKET", r"C:/KPH_Contoh/paket-i2")     # folder paket-i2
HASIL = r"C:/temp/hasil_i2"
os.makedirs(HASIL, exist_ok=True)

dem = QgsRasterLayer(os.path.join(PAKET_I2, "DEM_Lereng.tif"), "DEM_Lereng")
s = dem.dataProvider().bandStatistics(1)
print("DEM min, maks, rata-rata:", round(s.minimumValue, 1), round(s.maximumValue, 1), round(s.mean, 1))

kemiringan = processing.run("native:slope", {"INPUT": dem, "Z_FACTOR": 1.0, "OUTPUT": os.path.join(HASIL, "slope_derajat.tif")})["OUTPUT"]
arah = processing.run("native:aspect", {"INPUT": dem, "Z_FACTOR": 1.0, "OUTPUT": os.path.join(HASIL, "aspect.tif")})["OUTPUT"]
bayangan = processing.run("native:hillshade", {"INPUT": dem, "Z_FACTOR": 1.0, "AZIMUTH": 315.0, "V_ANGLE": 45.0,
                                               "OUTPUT": os.path.join(HASIL, "hillshade.tif")})["OUTPUT"]

# kemiringan dalam persen = tan(derajat) x 100
lyr = QgsRasterLayer(kemiringan, "slope_derajat")
persen = processing.run("native:rastercalc", {
    "EXPRESSION": 'tan("slope_derajat@1" * 3.14159265358979 / 180) * 100', "LAYERS": [lyr],
    "CELL_SIZE": dem.rasterUnitsPerPixelX(), "EXTENT": dem.extent(), "CRS": dem.crs(),
    "OUTPUT": os.path.join(HASIL, "slope_persen.tif")})["OUTPUT"]

for nama, jalur in (("Slope (derajat)", kemiringan), ("Aspect (derajat dari utara)", arah), ("Hillshade (0-255)", bayangan), ("Slope (persen)", persen)):
    lapisan = QgsRasterLayer(jalur, "x")      # simpan di variabel agar tidak dibuang
    st = lapisan.dataProvider().bandStatistics(1)
    print("%-28s min %.2f  maks %.2f  rata-rata %.2f" % (nama, st.minimumValue, st.maximumValue, st.mean))
Penjelasan baris demi baris. Bagian yang sama dengan Skrip 19.1 (impor, os.makedirs, QgsRasterLayer) tidak diulang. Hanya yang baru dijelaskan.
| Baris | Tulisan | Artinya |
|---|---|---|
| 7-9 | PAKET_I2 = os.environ.get("I2_PAKET", ...), HASIL = ..., os.makedirs(...) | Dua jalur seperti 19.1. PAKET_I2 dibaca dari variabel I2_PAKET, dengan alamat bawaan C:/KPH_Contoh/paket-i2. Folder hasil dibuat bila belum ada. |
| 11 | dem = QgsRasterLayer(..., "DEM_Lereng") | Buka DEM. |
| 12-13 | s = dem.dataProvider().bandStatistics(1) lalu print(...) | Hitung statistik DEM, lalu cetak tinggi terendah, tertinggi, dan rata-rata, dibulatkan satu desimal. Ini cara cepat memeriksa bahwa DEM terbaca. |
| 15 | kemiringan = processing.run("native:slope", {...})["OUTPUT"] | Jalankan alat kemiringan. Z_FACTOR 1.0 berarti satuan sama. Hasilnya berupa derajat, dan jalurnya masuk kotak kemiringan. |
| 16 | arah = processing.run("native:aspect", {...})["OUTPUT"] | Alat arah lereng, dengan pola sama. |
| 17-18 | bayangan = processing.run("native:hillshade", {...})["OUTPUT"] | Alat bayangan bukit. AZIMUTH 315 artinya sinar datang dari barat laut. V_ANGLE 45 adalah tinggi matahari di atas cakrawala. Perintah ini terbagi dua baris karena panjang, dan itu boleh di dalam kurung. |
| 21 | lyr = QgsRasterLayer(kemiringan, "slope_derajat") | Buka peta kemiringan yang baru dibuat. Namanya slope_derajat, dan nama ini muncul di rumus baris 23. |
| 22-25 | persen = processing.run("native:rastercalc", {...})["OUTPUT"] | Ubah derajat menjadi persen dengan rumus tan(derajat x pi / 180) x 100. Kalikan dengan pi per 180 mengubah derajat menjadi radian, satuan yang dipakai fungsi tan. Angka pi diketik langsung. Ukuran piksel dan luas mengikuti DEM. |
| 27 | for nama, jalur in ((...), (...), (...), (...)): | Ulangi empat kali. Tiap isian adalah pasangan: judul dan jalur peta. Kotak nama dan jalur langsung terisi dari pasangan itu. |
| 28-29 | lapisan = QgsRasterLayer(jalur, "x") lalu st = ...bandStatistics(1) | Buka peta, hitung statistiknya. Komentar di baris 28 mengingatkan: simpan layer di kotak agar tidak dibuang. |
| 30 | print("%-28s min %.2f maks %.2f rata-rata %.2f" % (...)) | Cetak satu baris. %-28s memberi judul lebar 28 huruf, rata kiri. %.2f mencetak angka dengan dua desimal. Tanda % di tengah mengisi lubang-lubang itu dengan empat nilai (Bab 9). |
Hasil. Layar menampilkan:
DEM min, maks, rata-rata: 89.6 150.7 114.7
Slope (derajat)              min 0.13  maks 37.34  rata-rata 12.57
Aspect (derajat dari utara)  min 0.01  maks 359.99  rata-rata 200.88
Hillshade (0-255)            min 44.98  maks 248.16  rata-rata 174.62
Slope (persen)               min 0.22  maks 76.30  rata-rata 23.09
Dari hasil ini Anda tahu: tanah di area ini naik dari 89,6 sampai 150,7 m. Lereng paling curam 37,34 derajat, sama dengan 76,30 persen (tan 37,34 derajat sama dengan 0,763). Rata-rata arah lereng (200,88) tidak bermakna sebagai arah, sebab 359 dan 1 derajat sebenarnya berdekatan. Pakai peta aspect untuk melihat sebaran, bukan untuk dirata-ratakan.
Bagian yang boleh diubah.
- Baris 7 dan 8, jalur. Ganti sesuai komputer Anda.
- Baris 15-17, Z_FACTOR. Ubah hanya bila satuan tinggi DEM berbeda dari satuan petanya. Di data ini biarkan 1.0.
- Baris 17, AZIMUTH dan V_ANGLE. Arah sinar dan tinggi matahari. Pada uji, azimut
135.0mengubah hillshade menjadi min 58,68, maks 246,79, rata-rata 172,47. - Baris 27, daftar pasangan. Tambah atau hapus pasangan untuk mengatur peta yang dicetak statistiknya.
Jebakan.
- Jalur DEM salah. Layar menampilkan
ERROR 4: ... No such file or directory. Lalu baris statistik berisi angka aneh:DEM min, maks, rata-rata: 1.7976931348623157e+308 -1.7976931348623157e+308 0.0. Angka raksasa itu tanda layer kosong. Setelahnya skrip berhenti di baris 22 denganIncorrect parameter value for EXTENT. Pelajarannya: baca baris statistik DEM dulu. - Persen bukan derajat. Lereng 45 derajat sama dengan 100 persen, bukan 50 persen. Itu sebabnya skrip memakai
tan, bukan sekadar dikali 100 lalu dibagi 90. - Skrip berikutnya bergantung pada slope_persen.tif. Skrip 19.3 dan 19.7 memakai berkas ini. Jalankan 19.2 lebih dulu.
- Aspect adalah arah, bukan ukuran. Jangan merata-ratakannya.
Latihan variasi.
- Ganti azimut matahari menjadi 135 dan lihat statistik hillshade.
- Cetak statistik hanya untuk dua peta: kemiringan dalam derajat dan dalam persen.
Contoh jawaban nomor 1, hanya bagian yang berubah (baris 17):
bayangan = processing.run("native:hillshade", {"INPUT": dem, "Z_FACTOR": 1.0, "AZIMUTH": 135.0, "V_ANGLE": 45.0,
                                               "OUTPUT": os.path.join(HASIL, "hillshade.tif")})["OUTPUT"]
Layar menampilkan Hillshade (0-255) min 58.68 maks 246.79 rata-rata 172.47.
Contoh jawaban nomor 2, baris 27 menjadi:
for nama, jalur in (("Slope (derajat)", kemiringan), ("Slope (persen)", persen)):Layar hanya menampilkan dua baris Slope di bawah baris DEM.
Skrip 19.3: Dari angka ke kelas lereng #
Berkas i2_03_kelas_lereng.py. Di dalam berkasnya tertulis "I2 Bab 3". Skrip ini memakai slope_persen.tif dari Skrip 19.2, jadi jalankan 19.2 lebih dulu.
Tujuan. Mengelompokkan kemiringan (persen) menjadi lima kelas, lalu menghitung luas tiap kelas di tiap petak KPH.
Bahan. Hasil Skrip 19.2 (slope_persen.tif di folder hasil) dan Batas_KPH.gpkg (layer Batas_KPH, tiga petak) dari paket-data. Skrip dijalankan dari Editor Skrip QGIS.
Lima istilah baru untuk skrip ini:
- Reklasifikasi: mengganti rentang angka menjadi kelas, seperti mengubah nilai ujian 0 sampai 100 menjadi huruf A sampai E.
- Tabel reklasifikasi: daftar tiga isian per kelas: awal rentang, akhir rentang, dan nomor kelas baru.
- Aturan batas: nilai yang tepat di batas masuk kelas bawah atau atas. Di skrip ini masuk kelas bawah.
- Zona dan histogram zonal: zona adalah poligon tempat raster dirangkum (di sini petak KPH). Histogram zonal menghitung jumlah piksel tiap kelas di dalam tiap zona.
- NoData: piksel tanpa nilai.
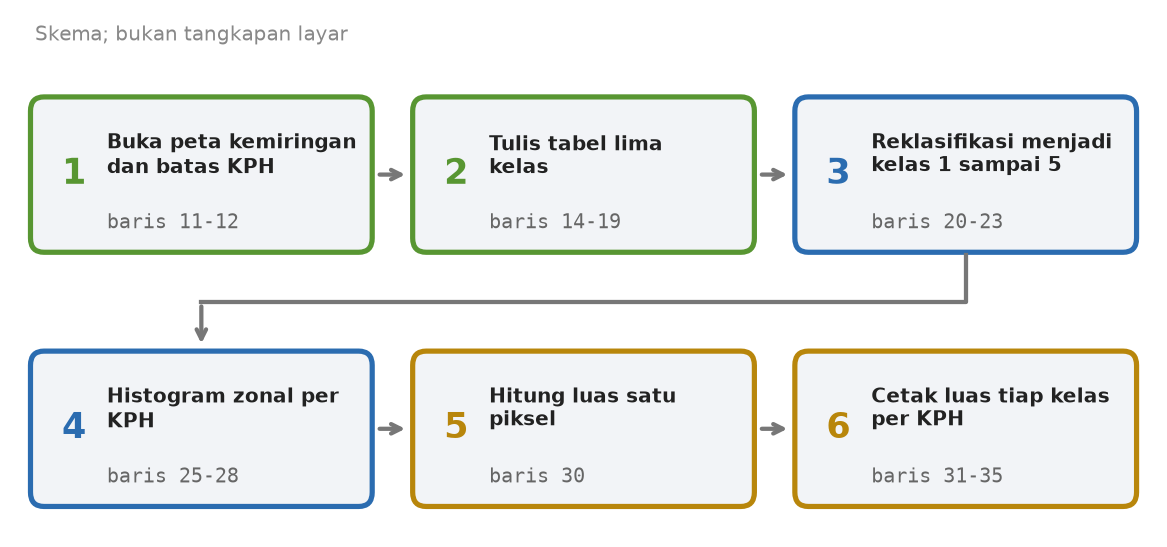
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 3: reklasifikasi kemiringan dan luas kelas lereng per KPH. Penulis: Badar Mubarok Yogaswara
# Jalankan setelah i2_02_turunan_dem.py (memakai slope_persen.tif di folder hasil).
import os
import processing
from qgis.core import QgsRasterLayer, QgsVectorLayer

PAKET = os.environ.get("I2_DATA", r"C:/KPH_Contoh/paket-data")
HASIL = r"C:/temp/hasil_i2"

persen = QgsRasterLayer(os.path.join(HASIL, "slope_persen.tif"), "slope_persen")
batas = QgsVectorLayer(os.path.join(PAKET, "Batas_KPH.gpkg") + "|layername=Batas_KPH", "Batas_KPH", "ogr")

# tabel: awal, akhir, kelas baru. Aturan batas: awal < nilai <= akhir (RANGE_BOUNDARIES = 0)
tabel = [-1, 8, 1,
         8, 15, 2,
         15, 25, 3,
         25, 45, 4,
         45, 1000, 5]
kelas = processing.run("native:reclassifybytable", {
    "INPUT_RASTER": persen, "RASTER_BAND": 1, "TABLE": tabel, "NO_DATA": -9999,
    "RANGE_BOUNDARIES": 0, "NODATA_FOR_MISSING": False, "DATA_TYPE": 5,
    "OUTPUT": os.path.join(HASIL, "kelas_lereng.tif")})["OUTPUT"]

lyr_kelas = QgsRasterLayer(kelas, "kelas_lereng")
hist = processing.run("native:zonalhistogram", {
    "INPUT_RASTER": lyr_kelas, "RASTER_BAND": 1, "INPUT_VECTOR": batas, "COLUMN_PREFIX": "K",
    "OUTPUT": os.path.join(HASIL, "luas_kelas_per_kph.gpkg")})["OUTPUT"]

luas_piksel_ha = lyr_kelas.rasterUnitsPerPixelX() * lyr_kelas.rasterUnitsPerPixelY() / 10000.0
hasil = QgsVectorLayer(hist, "hist", "ogr")
print("Luas kelas lereng (ha) per KPH; piksel = %.4f ha" % luas_piksel_ha)
for f in hasil.getFeatures():
    baris = ["%s=%.2f" % (nm, f[nm] * luas_piksel_ha) for nm in hasil.fields().names() if nm.startswith("K")]
    print(f["NAMA_KPH"], "  ", "  ".join(baris))
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-3 | komentar | Baris 3 mengingatkan: jalankan setelah Skrip 19.2, karena memakai slope_persen.tif. |
| 4-6 | import os, import processing, from qgis.core import QgsRasterLayer, QgsVectorLayer | Panggil perkakas. QgsVectorLayer kali ini dipakai untuk membuka batas KPH (layer titik, garis, atau poligon). |
| 8-9 | PAKET = os.environ.get("I2_DATA", ...), HASIL = ... | Lokasi paket-data (untuk batas KPH; dibaca dari I2_DATA seperti 19.1) dan folder hasil. Sesuaikan keduanya. Folder hasil harus sudah ada dari Skrip 19.2. |
| 11 | persen = QgsRasterLayer(os.path.join(HASIL, "slope_persen.tif"), "slope_persen") | Buka peta kemiringan persen hasil Skrip 19.2. |
| 12 | batas = QgsVectorLayer(..., "Batas_KPH", "ogr") | Buka layer batas. Sumber datanya adalah nama berkas, lalu tanda garis tegak, lalu layername=Batas_KPH. Bagian setelah garis tegak memilih satu layer di dalam GeoPackage. Isian ketiga, "ogr", adalah pembaca data vektor (dibahas di Bab 15). |
| 14 | komentar | Menyebut aturan batas: awal lebih kecil dari nilai, dan nilai kurang dari atau sama dengan akhir. |
| 15-19 | tabel = [-1, 8, 1, 8, 15, 2, ...] | Tabel reklasifikasi. Tiap tiga angka adalah satu kelas: awal, akhir, kelas baru. Misalnya -1, 8, 1 berarti nilai di atas -1 sampai 8 menjadi kelas 1, sehingga nilai 0 ikut kelas 1. Daftar ditulis lima baris agar mudah dibaca, tetapi bagi Python ini satu daftar berisi 15 angka. |
| 20-23 | kelas = processing.run("native:reclassifybytable", {...})["OUTPUT"] | Jalankan alat reklasifikasi. RASTER_BAND 1 memilih band satu. NO_DATA -9999 adalah angka penanda piksel kosong. RANGE_BOUNDARIES 0 memilih aturan batas "awal lebih kecil dari nilai, nilai kurang dari atau sama dengan akhir". NODATA_FOR_MISSING False berarti nilai yang tidak tercakup tabel dibiarkan apa adanya, tidak dijadikan NoData. DATA_TYPE 5 memilih tipe angka hasil. Pada berkas hasil uji, tipenya Float32. |
| 25 | lyr_kelas = QgsRasterLayer(kelas, "kelas_lereng") | Buka peta kelas yang baru dibuat. |
| 26-28 | hist = processing.run("native:zonalhistogram", {...})["OUTPUT"] | Jalankan histogram zonal. INPUT_VECTOR adalah batas KPH sebagai zona. COLUMN_PREFIX "K" membuat kolom bernama K1, K2, dan seterusnya. Isinya jumlah piksel kelas itu di tiap petak. Hasilnya berkas GeoPackage. |
| 30 | luas_piksel_ha = lyr_kelas.rasterUnitsPerPixelX() * lyr_kelas.rasterUnitsPerPixelY() / 10000.0 | Luas satu piksel dalam hektare: lebar kali tinggi dalam meter, dibagi 10.000. Piksel 2 m x 2 m = 4 m persegi = 0,0004 ha. Angka ini dihitung dari raster, jadi menyesuaikan sendiri. |
| 31 | hasil = QgsVectorLayer(hist, "hist", "ogr") | Buka tabel hasil histogram. |
| 32 | print("Luas kelas lereng (ha) per KPH; piksel = %.4f ha" % luas_piksel_ha) | Cetak judul. %.4f mengisi empat desimal. |
| 33 | for f in hasil.getFeatures(): | Ulangi satu kali untuk tiap petak (tiap baris tabel). |
| 34 | baris = ["%s=%.2f" % (nm, f[nm] * luas_piksel_ha) for nm in hasil.fields().names() if nm.startswith("K")] | Satu baris, empat langkah. Ambil semua nama kolom (fields().names()). Simpan hanya yang berawalan K. Kalikan jumlah piksel dengan luas satu piksel. Rakit jadi teks seperti K1=2.71. Hasilnya daftar teks. |
| 35 | print(f["NAMA_KPH"], " ", " ".join(baris)) | Cetak nama petak, lalu semua teks tadi disambung dengan dua spasi (" ".join(...)). |
Hasil. Layar menampilkan:
Luas kelas lereng (ha) per KPH; piksel = 0.0004 ha
KPH Alpha    K1=2.71  K2=0.14  K3=0.18  K4=0.48  K5=0.49
KPH Beta    K1=2.05  K2=0.12  K3=0.20  K4=1.12  K5=0.51
KPH Gamma    K1=0.23  K2=0.91  K3=2.37  K4=3.12  K5=1.37
Dari hasil ini Anda tahu: jumlah tiap baris cocok dengan luas petak, yaitu 4, 4, dan 8 hektare (misalnya KPH Alpha: 2,71 + 0,14 + 0,18 + 0,48 + 0,49 = 4,00). Itu tanda hitungan benar. Kelas 4 dan 5 (di atas 25 persen) memuat 0,97 ha di KPH Alpha, 1,63 ha di KPH Beta, dan 4,49 ha di KPH Gamma. Petak Gamma paling berisiko. [dihitung dari hasil skrip]
Bagian yang boleh diubah.
- Baris 8 dan 9, jalur. Ganti sesuai komputer Anda.
- Baris 15-19, tabel. Ubah batas kelas sesuai aturan instansi Anda. [CEK] Pada uji, tabel tiga kelas (0 sampai 15, 15 sampai 30, 30 sampai 1000) menghasilkan kolom
K1,K2,K3. - Baris 27 dan 34, huruf K. Keduanya harus sepasang. Bila Anda mengganti
COLUMN_PREFIXmenjadi"Kls", ganti jugastartswith("K")menjadistartswith("Kls"). - Baris 35, NAMA_KPH. Nama kolom pengenal petak. Untuk batas lain, ganti dengan nama kolom di layer itu.
- Baris 12, layer zona. Ganti dengan poligon lain, misalnya batas desa, untuk luas kelas per desa.
Jebakan.
- Nilai di luar tabel tidak jadi kelas. Tabel mencakup nilai di atas -1 sampai 1000, jadi nilai 0 ikut kelas 1. Nilai di atas 1000 tidak masuk kelas mana pun. Karena
NODATA_FOR_MISSINGFalse, nilainya dibiarkan. Saya mengujinya pada salinanslope_persen.tifyang saya ubah: 100 piksel di baris ke-11 (kolom ke-11 sampai ke-110) saya isi 0, dan 25 piksel di baris ke-51 (kolom ke-51 sampai ke-75) saya isi 2000. Hasilnya, nilai 0 masukK1, tetapi nilai 2000 membuat kolom tambahanK2000muncul di tabel:
Luas kelas lereng (ha) per KPH; piksel = 0.0004 ha
KPH Alpha    K1=2.71  K2=0.14  K3=0.18  K4=0.48  K5=0.49  K2000=0.00
KPH Beta    K1=2.05  K2=0.12  K3=0.20  K4=1.12  K5=0.51  K2000=0.00
KPH Gamma K1=0.27 K2=0.90 K3=2.36 K4=3.09 K5=1.37 K2000=0.01- Pada data latihan, jebakan ini tidak terjadi. Kemiringan pada data latihan berkisar 0,22 sampai 76,30 persen (40.000 piksel), jauh di bawah 1000, jadi kolom
K2000tidak muncul. Tetapi pada DEM lain dengan tebing yang sangat curam, nilai di atas 1000 bisa ada, dan luasnya terlewat dari kelas 5. Perbaikan: ganti angka1000di baris terakhir tabel (baris 19) dengan angka yang jauh lebih besar, misalnya100000. Pada raster buatan yang sama, kolomK2000lalu hilang dan luasnya pindah keK5(KPH Gamma: K5 naik dari 1,37 menjadi 1,38 ha). Batas bawah-1pada baris pertama tabel memang sengaja: tanpa itu, nilai tepat 0 (dataran yang benar-benar datar) ikut terlewat dari kelas 1. BilaNODATA_FOR_MISSINGdigantiTrue, nilai di luar tabel menjadi-9999(NoData), bukan dibiarkan. Itu juga sah, asal Anda sadar luasnya hilang dari hitungan. - Skrip 19.2 belum dijalankan. Berkas
slope_persen.tiftidak ada. Galatnya:Could not create raster output ...: Attempt to create 0x0 dataset is illegal,sizes must be larger than zero.Pesan ini tidak menyebut berkas yang hilang. Cek dulu isi folder hasil. - Filter huruf K. Baris 34 mengambil semua kolom berawalan
K. Bila tabel batas Anda punya kolom lain berawalanK, ia ikut tercetak sebagai luas. Beri awalan yang unik. [kemungkinan] - Label satuan. Judul di baris 32 menulis "(ha)". Bila Anda mengubah perkalian di baris 34, ubah juga judulnya.
Latihan variasi.
- Ganti tabel menjadi tiga kelas: 0 sampai 15, 15 sampai 30, dan 30 sampai 1000.
- Cetak luas dalam meter persegi, bukan hektare.
Contoh jawaban nomor 1, baris 15-19 menjadi:
tabel = [-1, 15, 1,
         15, 30, 2,
         30, 1000, 3]
Layar menampilkan tiga kolom per petak: KPH Alpha K1=2.84 K2=0.30 K3=0.86, KPH Beta K1=2.17 K2=0.53 K3=1.30, dan KPH Gamma K1=1.14 K2=4.26 K3=2.60.
Contoh jawaban nomor 2, baris 34 menjadi:
baris = ["%s=%.2f" % (nm, f[nm] * luas_piksel_ha * 10000) for nm in hasil.fields().names() if nm.startswith("K")]Layar menampilkan misalnya KPH Alpha K1=27056.00 K2=1388.00 K3=1828.00 K4=4808.00 K5=4920.00. Jumlahnya 40.000 meter persegi, sama dengan 4 hektare. Judul "(ha)" di baris 32 sudah tidak benar, jadi ganti juga.
Skrip 19.4: Biarkan citra yang bicara #
Berkas i2_04_tak_terbimbing.py. Di dalam berkasnya tertulis "I2 Bab 4". Ini skrip terberat di bab ini (69 baris), jadi penjelasannya dibagi lima blok.
Tujuan. Mengelompokkan seluruh piksel citra menjadi 6 kluster, lalu 10 kluster, dengan k-means yang ditulis sendiri memakai NumPy. Setelah itu tiap kluster diberi nama kelas lahan dengan bantuan area latih.
Bahan. Paket paket-i2: Citra_Lahan.tif (300 x 300 piksel, 1 m, band berurutan merah, hijau, biru, NIR) dan Area_Latih.gpkg (24 poligon latih, kolom Kode berisi 1 sampai 4). Skrip dijalankan dari Editor Skrip QGIS. Pada komputer uji, skrip selesai dalam sekitar 10 detik.
Gagasan pokoknya: klasifikasi tak terbimbing mengelompokkan piksel yang angka bandnya mirip, tanpa diberi contoh. Bayangkan Anda menyortir kelereng menurut warna tanpa tahu namanya. Anda hanya tahu mana yang mirip. Baru sesudah itu Anda memberi nama tiap tumpukan.
Lima istilah baru untuk skrip ini:
- Klasifikasi: mengubah citra berisi angka pantulan menjadi peta kelas, misalnya hutan atau sawah.
- Kluster: satu kelompok piksel yang angka bandnya mirip.
- K-means: cara mengelompokkan dengan memindah pusat kelompok berulang kali. Huruf k adalah jumlah kelompok yang Anda minta.
- Area latih: lokasi yang kelas sebenarnya sudah Anda ketahui dari lapangan.
- Rasterisasi: mengubah poligon menjadi raster.
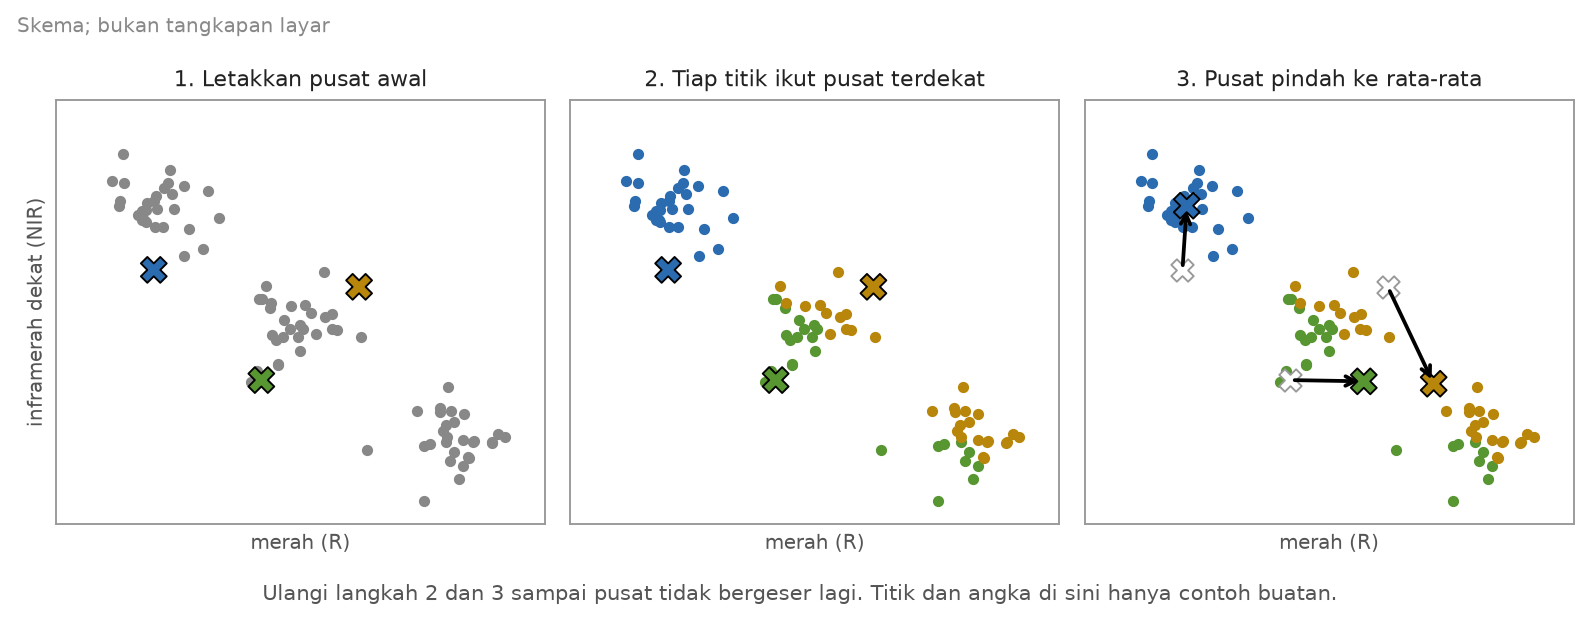
Gambar itu inti k-means. Pusat itu seperti pos jaga. Tiap piksel ikut pos terdekat. Lalu pos pindah ke tengah-tengah para pengikutnya. Ulangi sampai pos tidak bergeser lagi.
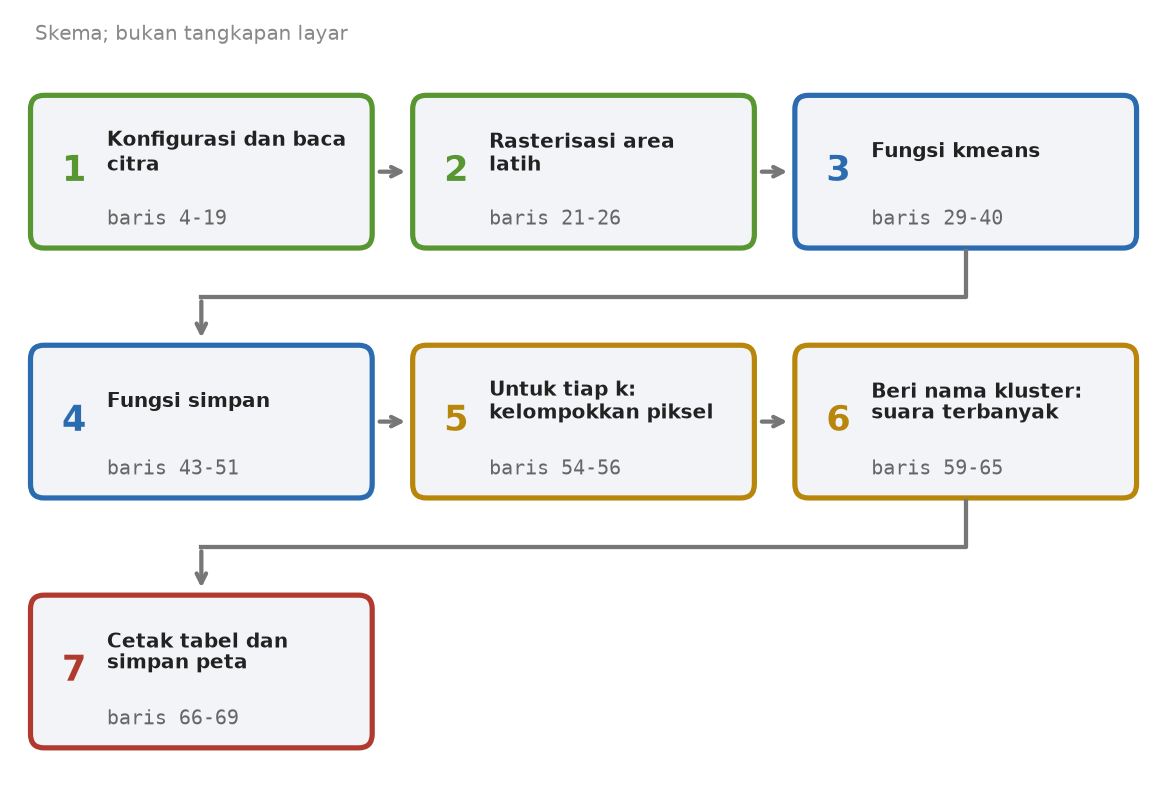
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 4: klasifikasi tak terbimbing dengan k-means (ditulis dengan NumPy). Penulis: Badar Mubarok Yogaswara
# Jalankan di Python Console QGIS. Ubah dua jalur di bawah sesuai komputer Anda.
import os
import numpy as np
import processing
from osgeo import gdal

PAKET_I2 = os.environ.get("I2_PAKET", r"C:/KPH_Contoh/paket-i2")
HASIL = r"C:/temp/hasil_i2"
os.makedirs(HASIL, exist_ok=True)
JUMLAH_KLUSTER = [6, 10]    # dua percobaan: 6 kluster, lalu 10 kluster
NAMA = {1: "Hutan", 2: "Kebun", 3: "Sawah", 4: "Lahan Terbuka"}

ds = gdal.Open(os.path.join(PAKET_I2, "Citra_Lahan.tif"))
gt, proj = ds.GetGeoTransform(), ds.GetProjection()
citra = ds.ReadAsArray().astype("float64")                  # bentuk (4, tinggi, lebar)
_, tinggi, lebar = citra.shape
piksel = citra.reshape(4, -1).T                             # satu baris = satu piksel, empat kolom = empat band

# lokasi yang kelasnya sudah diketahui (area latih) dipakai hanya untuk MEMBERI NAMA kluster
latih_tif = os.path.join(HASIL, "area_latih.tif")
processing.run("gdal:rasterize", {
    "INPUT": os.path.join(PAKET_I2, "Area_Latih.gpkg"), "FIELD": "Kode", "UNITS": 1, "WIDTH": 1.0, "HEIGHT": 1.0,
    "EXTENT": "312000,312300,9996000,9996300 [EPSG:32749]", "NODATA": 0, "DATA_TYPE": 0, "INIT": 0, "OUTPUT": latih_tif})
latih = gdal.Open(latih_tif).ReadAsArray().ravel()


def kmeans(x, k, ulang=30, seed=1):
    """K-means sederhana: pusat awal dipilih acak, lalu dihitung ulang sampai stabil."""
    rng = np.random.default_rng(seed)
    pusat = x[rng.choice(len(x), k, replace=False)]
    for _ in range(ulang):
        jarak = ((x[:, None, :] - pusat[None, :, :]) ** 2).sum(axis=2)     # jarak kuadrat tiap piksel ke tiap pusat
        label = jarak.argmin(axis=1)
        baru = np.array([x[label == i].mean(axis=0) if np.any(label == i) else pusat[i] for i in range(k)])
        if np.allclose(baru, pusat, atol=1e-3):
            break
        pusat = baru
    return label, pusat


def simpan(arr, nama):
    jalur = os.path.join(HASIL, nama)
    out = gdal.GetDriverByName("GTiff").Create(jalur, lebar, tinggi, 1, gdal.GDT_Byte)
    out.SetGeoTransform(gt)
    out.SetProjection(proj)
    out.GetRasterBand(1).WriteArray(arr.astype("uint8"))
    out.FlushCache()
    out = None
    return jalur


for k in JUMLAH_KLUSTER:
    label, pusat = kmeans(piksel, k)
    peta = np.zeros(len(piksel), dtype=int)
    print("\n=== %d kluster ===" % k)
    print("Kluster | piksel  persen |   R     G     B    NIR | piksel latih per kelas (H/Kb/Sw/LT) -> diberi nama")
    for i in np.argsort(-pusat[:, 3]):                       # urut menurut NIR menurun
        n = int((label == i).sum())
        hitung = np.bincount(latih[(label == i) & (latih > 0)], minlength=5)[1:]
        kelas = int(hitung.argmax()) + 1 if hitung.sum() else 0     # suara terbanyak; 0 = tidak ada piksel latih
        if kelas == 0:
            print("  PERINGATAN: kluster %d tidak punya piksel latih; kelasnya 0 (belum bernama)." % (i + 1))
        peta[label == i] = kelas
        r, g, b, nir = pusat[i]
        print("  %2d    | %6d  %5.1f%% | %5.1f %5.1f %5.1f %5.1f | %s -> %s" % (
            i + 1, n, 100.0 * n / label.size, r, g, b, nir, "/".join(str(int(v)) for v in hitung), NAMA.get(kelas, "(belum bernama)")))
    print("Tersimpan:", simpan(peta.reshape(tinggi, lebar), "tak_terbimbing_k%d.tif" % k))
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
Blok A: baris 1 sampai 19, membaca citra menjadi tabel piksel.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-3 | komentar | Judul, penulis, dan pesan: ubah dua jalur di bawah. |
| 4-7 | import os, import numpy as np, import processing, from osgeo import gdal | Panggil empat perkakas. Kata as np memberi NumPy nama pendek np. |
| 9-11 | PAKET_I2, HASIL, os.makedirs(...) | PAKET_I2 dibaca dari I2_PAKET (seperti 19.2), HASIL jalur hasil, dan pembuatan folder hasil. Sesuaikan jalurnya. |
| 12 | JUMLAH_KLUSTER = [6, 10] | Daftar jumlah kluster yang dicoba: dua percobaan. |
| 13 | NAMA = {1: "Hutan", 2: "Kebun", 3: "Sawah", 4: "Lahan Terbuka"} | Kamus (Bab 5): nomor kelas di sebelah kiri, nama kelas di sebelah kanan. |
| 15 | ds = gdal.Open(...) | Buka citra dengan GDAL. |
| 16 | gt, proj = ds.GetGeoTransform(), ds.GetProjection() | Dua nilai dalam satu baris. gt memuat letak dan ukuran piksel. proj adalah sistem koordinat. Keduanya disimpan supaya peta hasil punya lokasi yang sama dengan citra. |
| 17 | citra = ds.ReadAsArray().astype("float64") | Baca semua band menjadi array. Lalu ubah ke angka desimal agar hitungan jarak tidak meluap. |
| 18 | _, tinggi, lebar = citra.shape | Bentuk array adalah (4, 300, 300): empat band, tinggi, lebar. Tanda _ membuang jumlah band karena tidak dipakai. |
| 19 | piksel = citra.reshape(4, -1).T | Ratakan tiap band menjadi satu deret, lalu putar tabel. Hasilnya 90.000 baris (satu baris satu piksel) dan 4 kolom (satu kolom satu band). |
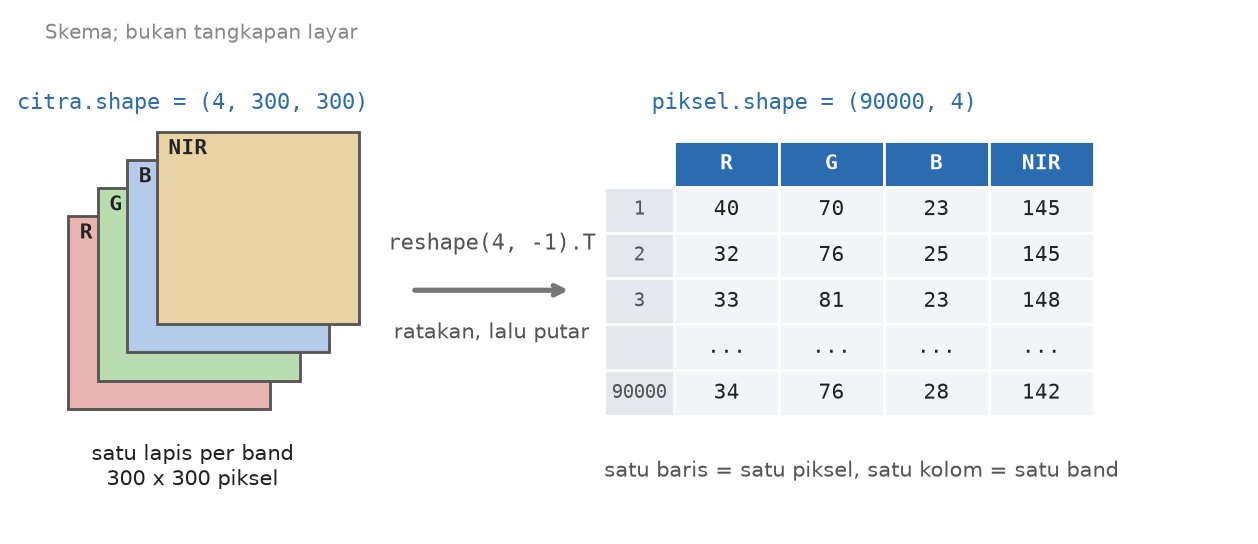
Blok B: baris 21 sampai 26, area latih menjadi raster.
| Baris | Tulisan | Artinya |
|---|---|---|
| 21 | komentar | Area latih di sini hanya dipakai untuk MEMBERI NAMA kluster. Kelompoknya sendiri dibuat tanpa contoh. |
| 22 | latih_tif = os.path.join(HASIL, "area_latih.tif") | Tentukan nama berkas hasil rasterisasi. |
| 23-25 | processing.run("gdal:rasterize", {...}) | Ubah poligon menjadi raster. FIELD "Kode" berarti piksel di dalam poligon bernilai isi kolom Kode. UNITS 1 dan WIDTH, HEIGHT 1.0 memilih ukuran piksel 1 meter. EXTENT adalah luas area, yang harus sama dengan citra. NODATA, INIT, dan DATA_TYPE membuat piksel di luar poligon bernilai 0, dengan tipe Byte. |
| 26 | latih = gdal.Open(latih_tif).ReadAsArray().ravel() | Baca raster itu, lalu .ravel() meratakannya menjadi satu deret 90.000 angka. Urutannya sama dengan urutan baris di piksel. |
Blok C: baris 29 sampai 40, fungsi k-means.
| Baris | Tulisan | Artinya |
|---|---|---|
| 29 | def kmeans(x, k, ulang=30, seed=1): | Resep k-means. x tabel piksel, k jumlah kluster, ulang batas putaran, seed kunci pengacak agar hasil sama tiap kali dijalankan. |
| 30 | docstring | Catatan satu kalimat: pusat awal dipilih acak, lalu dihitung ulang sampai stabil. |
| 31 | rng = np.random.default_rng(seed) | Siapkan pembuat angka acak dengan kunci seed. |
| 32 | pusat = x[rng.choice(len(x), k, replace=False)] | Pilih k piksel acak (tanpa kembar) sebagai pusat awal. |
| 33 | for _ in range(ulang): | Ulangi paling banyak 30 kali. Tanda _ berarti nomor putaran tidak dipakai. |
| 34 | jarak = ((x[:, None, :] - pusat[None, :, :]) ** 2).sum(axis=2) | Hitung jarak kuadrat tiap piksel ke tiap pusat sekaligus. Bagian None hanya menata sumbu agar tiap piksel dibandingkan dengan tiap pusat. Hasilnya tabel 90.000 baris kali k kolom. |
| 35 | label = jarak.argmin(axis=1) | Untuk tiap piksel, ambil nomor pusat yang jaraknya terkecil. Itu "pos" yang ia ikuti. |
| 36 | baru = np.array([x[label == i].mean(axis=0) if np.any(label == i) else pusat[i] for i in range(k)]) | Hitung pusat baru: rata-rata para anggota tiap kluster. Bila sebuah kluster kosong, pusat lamanya dipertahankan. |
| 37-38 | if np.allclose(baru, pusat, atol=1e-3): break | Bila pusat nyaris tidak bergeser (kurang dari 0,001), hentikan perulangan dengan break. |
| 39 | pusat = baru | Pakai pusat baru untuk putaran berikutnya. |
| 40 | return label, pusat | Kembalikan dua hal: kluster tiap piksel dan pusat akhir. |
Blok D: baris 43 sampai 51, fungsi simpan.
| Baris | Tulisan | Artinya |
|---|---|---|
| 43-44 | def simpan(arr, nama): lalu jalur = ... | Resep menyimpan array menjadi berkas. Jalur diambil dari folder hasil dan nama. |
| 45 | out = gdal.GetDriverByName("GTiff").Create(jalur, lebar, tinggi, 1, gdal.GDT_Byte) | Buat berkas GeoTIFF kosong berukuran sama dengan citra, satu band, tipe Byte (angka 0 sampai 255). |
| 46-47 | out.SetGeoTransform(gt) dan out.SetProjection(proj) | Beri lokasi dan sistem koordinat yang sama dengan citra. |
| 48 | out.GetRasterBand(1).WriteArray(arr.astype("uint8")) | Tulis angka ke band pertama, sebagai bilangan bulat kecil. |
| 49-50 | out.FlushCache() dan out = None | Paksa data tertulis ke disk, lalu tutup berkas. Cara menutup berkas di GDAL adalah mengosongkan kotaknya. |
| 51 | return jalur | Kembalikan jalur berkas. |
Blok E: baris 54 sampai 69, perulangan utama.
| Baris | Tulisan | Artinya |
|---|---|---|
| 54-56 | for k in JUMLAH_KLUSTER: lalu label, pusat = kmeans(piksel, k) | Ulangi untuk k = 6, lalu k = 10. Jalankan k-means. peta dibuat sebagai deret 90.000 angka 0. |
| 57-58 | print(...) | Cetak judul dan kepala tabel. |
| 59 | for i in np.argsort(-pusat[:, 3]): | Telusuri kluster dari yang NIR-nya terbesar. pusat[:, 3] adalah kolom keempat (NIR). Tanda minus membalik urutan. |
| 60 | n = int((label == i).sum()) | Hitung jumlah piksel di kluster i. |
| 61 | hitung = np.bincount(latih[(label == i) & (latih > 0)], minlength=5)[1:] | Ambil piksel milik kluster i yang juga ada di area latih, lalu hitung berapa dari tiap kelas 1 sampai 4. Hasilnya empat angka. Nama hitung di sini berarti "hasil hitung", bukan fungsi seperti di Skrip 19.1. |
| 62 | kelas = int(hitung.argmax()) + 1 if hitung.sum() else 0 | Bila ada piksel latih: ambil kelas dengan jumlah terbanyak (suara terbanyak). Tanda + 1 karena nomor urut mulai dari 0. Bila tidak ada, kelasnya 0. |
| 63-64 | if kelas == 0: lalu print(" PERINGATAN: ...") | Pengaman. Bila kluster tidak punya piksel latih (kelas 0), cetak peringatan berisi nomor kluster. Tanpa baris ini, kluster tanpa nama lolos tanpa tanda. |
| 65 | peta[label == i] = kelas | Isi peta untuk seluruh piksel kluster itu dengan kelasnya. |
| 66 | r, g, b, nir = pusat[i] | Pecah empat rata-rata band pusat kluster menjadi empat kotak. |
| 67-68 | print(" %2d ..." % (...)) | Cetak satu baris tabel. "/".join(str(int(v)) for v in hitung) menyambung empat angka jadi teks seperti 335/6/0/0. NAMA.get(kelas, "(belum bernama)") mencari nama kelas, dan bila tidak ada (kelas 0), memakai teks cadangan. |
| 69 | print("Tersimpan:", simpan(peta.reshape(tinggi, lebar), "tak_terbimbing_k%d.tif" % k)) | Bentuk peta kembali menjadi 300 x 300, simpan dengan nama yang memuat k, lalu cetak jalurnya. |
Hasil. Layar menampilkan (nomor kluster boleh berbeda di komputer Anda):
=== 6 kluster ===
Kluster | piksel  persen |   R     G     B    NIR | piksel latih per kelas (H/Kb/Sw/LT) -> diberi nama
   2    |  14051   15.6% |  44.8  86.0  41.0 153.4 | 335/6/0/0 -> Hutan
   3    |  21582   24.0% |  33.5  74.2  28.3 141.4 | 529/3/0/0 -> Hutan
   4    |  43309   48.1% |  60.7 104.1  48.1 119.3 | 0/855/864/0 -> Sawah
   5    |   3131    3.5% | 146.3 128.3 113.6 109.4 | 0/0/0/308 -> Lahan Terbuka
   6    |   5920    6.6% | 126.6 116.5  95.6  92.0 | 0/0/0/486 -> Lahan Terbuka
   1    |   2007    2.2% | 110.1 108.7  82.7  79.3 | 0/0/0/70 -> Lahan Terbuka
Tersimpan: C:/temp/hasil_i2\tak_terbimbing_k6.tif

=== 10 kluster ===
Kluster | piksel  persen |   R     G     B    NIR | piksel latih per kelas (H/Kb/Sw/LT) -> diberi nama
   3    |   7864    8.7% |  45.6  87.6  44.1 156.6 | 240/0/0/0 -> Hutan
   6    |  14670   16.3% |  37.4  77.8  31.9 149.0 | 372/0/0/0 -> Hutan
   9    |   9895   11.0% |  29.6  69.9  25.6 138.6 | 243/0/0/0 -> Hutan
   2    |  10658   11.8% |  60.9 103.5  52.1 134.4 | 1/351/14/0 -> Kebun
   5    |  12387   13.8% |  49.6  93.0  37.9 122.2 | 8/413/9/0 -> Kebun
  10    |  10580   11.8% |  71.8 114.8  56.7 119.6 | 0/57/366/0 -> Sawah
   7    |   3037    3.4% | 146.6 128.5 113.8 109.6 | 0/0/0/297 -> Lahan Terbuka
   1    |  13013   14.5% |  59.1 102.9  45.2 106.5 | 0/43/475/0 -> Sawah
   8    |   5685    6.3% | 127.1 116.9  96.0  92.6 | 0/0/0/453 -> Lahan Terbuka
   4    |   2211    2.5% | 112.4 109.0  84.6  78.3 | 0/0/0/114 -> Lahan Terbuka
Tersimpan: C:/temp/hasil_i2\tak_terbimbing_k10.tif
Cara membaca: tiap baris adalah satu kluster. Kolom H/Kb/Sw/LT adalah jumlah piksel latih Hutan, Kebun, Sawah, dan Lahan Terbuka di kluster itu. Pada 6 kluster, kluster 4 memuat 855 piksel latih Kebun dan 864 piksel latih Sawah, hampir sama banyak. Satu kluster tidak bisa menjadi dua kelas. Skrip memberinya nama Sawah dengan selisih tipis, jadi Kebun hilang dari peta. Pada 10 kluster, Kebun dan Sawah mulai terpisah. Harganya: pekerjaan memberi nama bertambah.
Bagian yang boleh diubah.
- Baris 9 dan 10, jalur. Ganti sesuai komputer Anda.
- Baris 12, jumlah kluster. Pada uji,
[4]menghasilkan empat kluster di mana Kebun dan Sawah menyatu:1 | 43361 48.2% ... | 0/853/864/0 -> Sawah. Kebun tidak punya kluster sendiri. - Baris 29, seed=1. Pada uji,
seed=2dengan 6 kluster menghasilkan kluster yang berbeda, dan sekarang Kebun punya kluster sendiri (10/581/11/0 -> Kebun). Jadi hasil k-means bergantung pada titik awal acak. - Baris 29, ulang=30. Batas putaran. Bila terlalu kecil, pusat belum stabil. Bila besar, tidak merugikan, sebab perulangan berhenti sendiri (
break) saat pusat stabil. - Baris 13 dan 61, nama kelas. Bila jumlah kelas berubah, ubah
NAMA, lalu sesuaikanminlength=5(jumlah kelas ditambah 1) pada baris 61. - Baris 25, EXTENT. Harus sama dengan luas citra Anda.
Jebakan.
- Kluster tanpa piksel latih diberi kelas 0. Pada uji dengan
JUMLAH_KLUSTER = [40], kluster 38 tidak punya satu pun piksel latih. Baris 63-64 mencetakPERINGATAN: kluster 38 tidak punya piksel latih; kelasnya 0 (belum bernama).tepat di atas barisnya, yang berbunyi38 | 784 0.9% | 106.3 106.1 79.3 69.0 | 0/0/0/0 -> (belum bernama). Peta hasil bernilai 0 di tempat itu. Jangan abaikan peringatan itu. Peta berisi 0 tidak bisa dinilai di Skrip 19.6, yang berhenti dengan pesan jelas. Perbaikannya: kurangiJUMLAH_KLUSTER, atau tambah area latih. - Luas EXTENT tidak cocok dengan citra. Pada uji dengan luas 200 m x 200 m, skrip berhenti di baris 61 dengan
ValueError: operands could not be broadcast together with shapes (90000,) (40000,). Artinya: citra punya 90.000 piksel, tetapi area latih hanya 40.000. - Nomor kluster tidak bermakna. Kluster 2 di komputer Anda belum tentu kluster 2 di buku ini. Yang penting pola isinya.
- Menamai kluster memakai area latih membuat cara ini setengah terbimbing. Itu wajar, tetapi jangan pakai titik uji (Skrip 19.6) untuk memberi nama. Titik uji harus tetap "buta" sampai penilaian.
Latihan variasi.
- Jalankan hanya dengan 4 kluster.
- Ubah
seedmenjadi 2 dan jalankan hanya dengan 6 kluster. Apakah Kebun masih hilang?
Contoh jawaban nomor 1, baris 12 menjadi JUMLAH_KLUSTER = [4]. Layar menampilkan:
=== 4 kluster ===
Kluster | piksel  persen |   R     G     B    NIR | piksel latih per kelas (H/Kb/Sw/LT) -> diberi nama
   2    |  14044   15.6% |  44.8  86.0  41.1 153.4 | 335/7/0/0 -> Hutan
   3    |  21637   24.0% |  33.5  74.2  28.3 141.4 | 529/4/0/0 -> Hutan
   1    |  43361   48.2% |  60.8 104.1  48.2 119.2 | 0/853/864/0 -> Sawah
   4    |  10958   12.2% | 129.5 118.5  98.6  94.6 | 0/0/0/864 -> Lahan Terbuka
Contoh jawaban nomor 2, baris 12 menjadi JUMLAH_KLUSTER = [6] dan baris 29 menjadi def kmeans(x, k, ulang=30, seed=2):. Layar menampilkan:
=== 6 kluster ===
Kluster | piksel  persen |   R     G     B    NIR | piksel latih per kelas (H/Kb/Sw/LT) -> diberi nama
   5    |  13312   14.8% |  43.5  84.7  40.4 154.7 | 342/0/0/0 -> Hutan
   4    |  19397   21.6% |  32.6  73.1  27.8 142.6 | 512/0/0/0 -> Hutan
   6    |  15072   16.7% |  68.9 111.7  57.0 127.2 | 0/250/302/0 -> Sawah
   1    |  16833   18.7% |  51.8  95.1  40.6 124.8 | 10/581/11/0 -> Kebun
   2    |  14538   16.2% |  60.3 103.7  45.9 106.7 | 0/33/551/0 -> Sawah
   3    |  10848   12.1% | 129.8 118.6  98.9  94.4 | 0/0/0/864 -> Lahan Terbuka
Kebun muncul lagi, walau hanya karena titik awal acak berbeda. Pelajarannya: jangan percaya satu kali jalan. Ulangi dengan seed berbeda.
Skrip 19.5: Ajari citra mengenal lahan #
Berkas i2_05_terbimbing.py. Di dalam berkasnya tertulis "I2 Bab 5". Skrip ini padat, jadi yang sama dengan Skrip 19.4 dijelaskan singkat dan hanya yang baru yang dibedah.
Tujuan. Melatih komputer dengan area latih, lalu mengklasifikasi seluruh citra dengan dua aturan: jarak minimum dan kemiripan maksimum.
Bahan. Paket paket-i2: Citra_Lahan.tif dan Area_Latih.gpkg, sama seperti Skrip 19.4. Skrip dijalankan dari Editor Skrip QGIS.
Gagasan pokoknya: pada klasifikasi terbimbing, Anda memberi contoh lebih dulu. Komputer mempelajari ciri angka tiap kelas, lalu menerapkannya ke seluruh citra. Seperti melatih petugas baru: tunjukkan beberapa contoh tiap jenis lahan, lalu minta ia menilai sisanya.
Lima istilah baru untuk skrip ini:
- Klasifikasi terbimbing: klasifikasi dengan contoh dari Anda.
- Tanda spektral: ciri angka band satu kelas, yaitu rata-rata dan sebarannya.
- Jarak minimum: piksel masuk kelas yang rata-ratanya paling dekat.
- Kemiripan maksimum: piksel masuk kelas yang paling cocok, dengan memperhitungkan seberapa lebar sebaran kelas itu.
- Kovarians: ukuran sebaran band satu kelas, dan apakah band-band naik turun bersama. Kelas dengan sebaran sempit seperti sekelompok murid yang tingginya seragam. Kelas dengan sebaran lebar seperti murid dengan tinggi beragam.
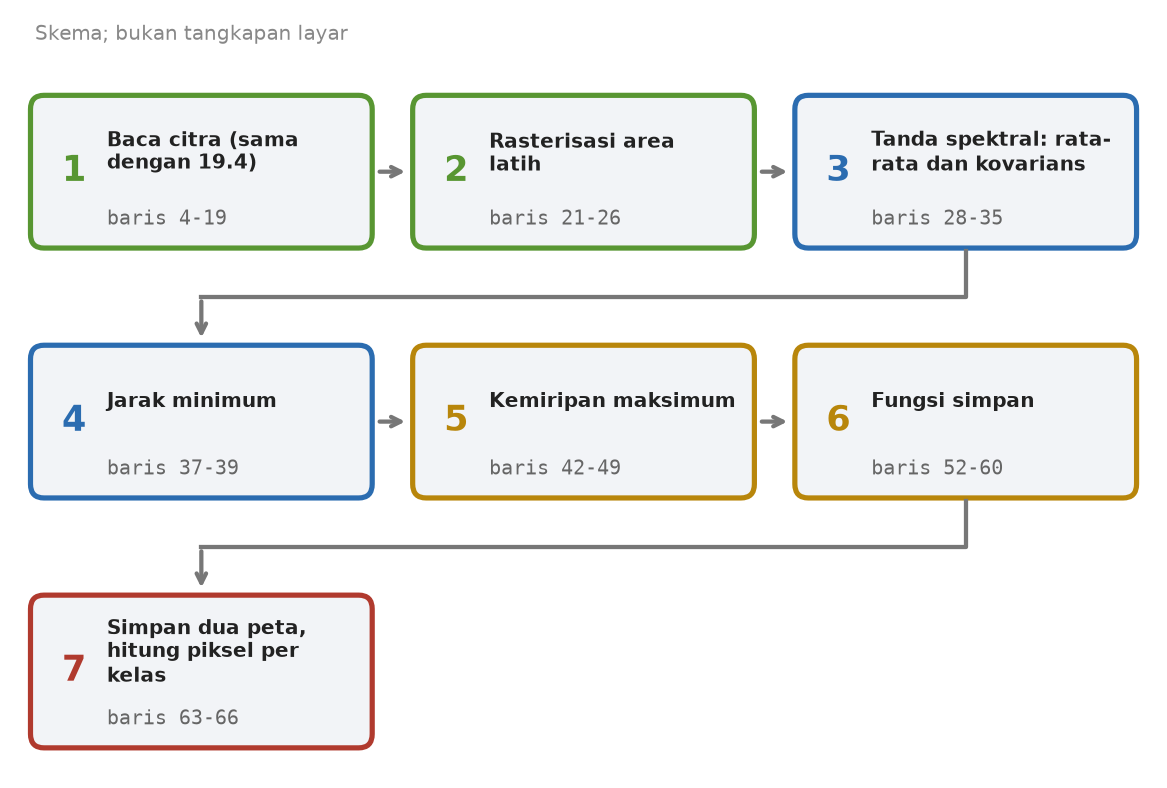
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 5: klasifikasi terbimbing (jarak minimum dan kemiripan maksimum, ditulis dengan NumPy). Penulis: Badar Mubarok Yogaswara
# Jalankan di Python Console QGIS. Ubah dua jalur di bawah sesuai komputer Anda.
import os
import numpy as np
import processing
from osgeo import gdal

PAKET_I2 = os.environ.get("I2_PAKET", r"C:/KPH_Contoh/paket-i2")
HASIL = r"C:/temp/hasil_i2"
os.makedirs(HASIL, exist_ok=True)
NAMA = {1: "Hutan", 2: "Kebun", 3: "Sawah", 4: "Lahan Terbuka"}

citra_tif = os.path.join(PAKET_I2, "Citra_Lahan.tif")
ds = gdal.Open(citra_tif)
gt, proj = ds.GetGeoTransform(), ds.GetProjection()
citra = ds.ReadAsArray().astype("float64")
_, tinggi, lebar = citra.shape
piksel = citra.reshape(4, -1).T

# 1) ubah poligon area latih menjadi raster kelas (piksel di dalam poligon bernilai Kode, lainnya 0)
latih_tif = os.path.join(HASIL, "area_latih.tif")
processing.run("gdal:rasterize", {
    "INPUT": os.path.join(PAKET_I2, "Area_Latih.gpkg"), "FIELD": "Kode", "UNITS": 1, "WIDTH": 1.0, "HEIGHT": 1.0,
    "EXTENT": "312000,312300,9996000,9996300 [EPSG:32749]", "NODATA": 0, "DATA_TYPE": 0, "INIT": 0, "OUTPUT": latih_tif})
latih = gdal.Open(latih_tif).ReadAsArray().ravel()

# 2) tanda spektral: rata-rata dan sebaran (kovarians) tiap kelas dari piksel latihnya
rata, kov = {}, {}
print("Kelas          | piksel latih |   R     G     B    NIR (rata-rata)")
for k in NAMA:
    x = piksel[latih == k]
    assert len(x) > 4, "Area latih kelas %d terlalu sedikit" % k
    rata[k], kov[k] = x.mean(axis=0), np.cov(x.T)
    print("%-14s | %6d       | %5.1f %5.1f %5.1f %5.1f" % (NAMA[k], len(x), *rata[k]))

# 3a) jarak minimum: tiap piksel masuk kelas yang rata-ratanya paling dekat
jarak = np.stack([((piksel - rata[k]) ** 2).sum(axis=1) for k in NAMA], axis=1)
jarak_min = jarak.argmin(axis=1) + 1


# 3b) kemiripan maksimum: seperti jarak minimum, tetapi memperhitungkan sebaran tiap kelas (kovarians)
def skor(x, mu, c):
    d = x - mu
    return -0.5 * np.einsum("ij,jk,ik->i", d, np.linalg.inv(c), d) - 0.5 * np.log(np.linalg.det(c))


kemiripan = np.stack([skor(piksel, rata[k], kov[k]) for k in NAMA], axis=1)
maks_lik = kemiripan.argmax(axis=1) + 1


def simpan(arr, nama):
    jalur = os.path.join(HASIL, nama)
    out = gdal.GetDriverByName("GTiff").Create(jalur, lebar, tinggi, 1, gdal.GDT_Byte)
    out.SetGeoTransform(gt)
    out.SetProjection(proj)
    out.GetRasterBand(1).WriteArray(arr.reshape(tinggi, lebar).astype("uint8"))
    out.FlushCache()
    out = None
    print("Tersimpan:", jalur)


simpan(jarak_min, "terbimbing_jarak_min.tif")
simpan(maks_lik, "terbimbing_maks_lik.tif")
for nama, arr in (("jarak minimum", jarak_min), ("kemiripan maksimum", maks_lik)):
    print(nama, "-> piksel per kelas:", {NAMA[k]: int((arr == k).sum()) for k in NAMA})
Penjelasan baris demi baris. Baris 1-26 hampir sama dengan Skrip 19.4 (impor, jalur, membaca citra menjadi tabel piksel, merasterisasi area latih menjadi latih). Bedanya hanya tidak ada JUMLAH_KLUSTER. Yang baru mulai dari baris 28.
Blok A: baris 28 sampai 35, tanda spektral tiap kelas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 29 | rata, kov = {}, {} | Siapkan dua kamus kosong dalam satu baris: satu untuk rata-rata, satu untuk kovarians. |
| 30 | print("Kelas ...") | Cetak kepala tabel. |
| 31 | for k in NAMA: | Ulangi untuk tiap kelas. Menelusuri kamus berarti menelusuri kuncinya: 1, 2, 3, 4. |
| 32 | x = piksel[latih == k] | Pilih baris piksel yang lokasinya ada di area latih kelas k. |
| 33 | assert len(x) > 4, "Area latih kelas %d terlalu sedikit" % k | Pengaman. assert menghentikan skrip bila syaratnya salah (lihat Bab 10). Di sini syaratnya: kelas punya lebih dari 4 piksel latih. Tanpa itu, kovarians tidak bisa dihitung dan peta rusak tanpa kabar. |
| 34 | rata[k], kov[k] = x.mean(axis=0), np.cov(x.T) | Hitung rata-rata tiap band, dan matriks kovarians 4 x 4. Simpan keduanya di kamus dengan kunci kelas. |
| 35 | print("%-14s ..." % (NAMA[k], len(x), *rata[k])) | Cetak satu baris: nama kelas, jumlah piksel latih, dan empat rata-rata. Tanda bintang * membuka daftar empat angka menjadi empat isian terpisah. |
Blok B: baris 37 sampai 39, jarak minimum.
| Baris | Tulisan | Artinya |
|---|---|---|
| 38 | jarak = np.stack([((piksel - rata[k]) ** 2).sum(axis=1) for k in NAMA], axis=1) | Untuk tiap kelas, hitung jarak kuadrat semua piksel ke rata-rata kelas itu. np.stack menyusun empat hasil menjadi satu tabel 90.000 baris kali 4 kolom. |
| 39 | jarak_min = jarak.argmin(axis=1) + 1 | Pilih kelas dengan jarak terkecil. Tanda + 1 karena nomor kelas mulai dari 1, bukan 0. |
Blok C: baris 42 sampai 49, kemiripan maksimum.
| Baris | Tulisan | Artinya |
|---|---|---|
| 43-45 | def skor(x, mu, c): lalu rumus | Resep yang menghitung "skor kecocokan" tiap piksel dengan satu kelas. Anda tidak perlu menghafal rumusnya. Yang perlu diingat: makin besar skor, makin cocok. Rumus memakai kebalikan matriks kovarians (np.linalg.inv) dan determinannya (np.linalg.det), sehingga kelas yang sebarannya lebar tidak dirugikan. |
| 48 | kemiripan = np.stack([skor(piksel, rata[k], kov[k]) for k in NAMA], axis=1) | Hitung skor tiap piksel untuk tiap kelas, lalu susun menjadi tabel 90.000 kali 4. |
| 49 | maks_lik = kemiripan.argmax(axis=1) + 1 | Pilih kelas dengan skor terbesar (argmax, kebalikan argmin). |
Blok D: baris 52 sampai 66, menyimpan dan menghitung.
| Baris | Tulisan | Artinya |
|---|---|---|
| 52-60 | def simpan(arr, nama): | Mirip fungsi simpan di Skrip 19.4, dengan dua beda. Pembentukan ulang menjadi 300 x 300 (arr.reshape(tinggi, lebar)) dilakukan di dalam fungsi. Dan fungsi mencetak sendiri jalur yang tersimpan, tanpa return. |
| 63-64 | simpan(jarak_min, ...) dan simpan(maks_lik, ...) | Simpan dua peta hasil. |
| 65 | for nama, arr in (("jarak minimum", jarak_min), ("kemiripan maksimum", maks_lik)): | Ulangi untuk dua pasangan: judul dan array hasil. |
| 66 | print(nama, "-> piksel per kelas:", {NAMA[k]: int((arr == k).sum()) for k in NAMA}) | Cetak kamus berisi nama kelas dan jumlah pikselnya. Bentuk {kunci: nilai for ...} adalah kamus yang dibuat dengan satu baris perulangan. |
Hasil. Layar menampilkan:
Kelas          | piksel latih |   R     G     B    NIR (rata-rata)
Hutan          |    864       |  35.4  81.8  35.5 145.8
Kebun          |    864       |  55.7 101.8  46.9 126.5
Sawah          |    864       |  61.3 108.2  50.4 111.3
Lahan Terbuka  |    864       | 133.9 119.3 102.4  96.0
Tersimpan: C:/temp/hasil_i2\terbimbing_jarak_min.tif
Tersimpan: C:/temp/hasil_i2\terbimbing_maks_lik.tif
jarak minimum -> piksel per kelas: {'Hutan': 33484, 'Kebun': 23204, 'Sawah': 22470, 'Lahan Terbuka': 10842}
kemiripan maksimum -> piksel per kelas: {'Hutan': 33415, 'Kebun': 23194, 'Sawah': 22447, 'Lahan Terbuka': 10944}
Dari hasil ini Anda tahu: Kebun dan Sawah memang mirip. Rata-rata keduanya dekat (NIR 126,5 lawan 111,3), yang membuat keduanya menyatu di Skrip 19.4. Kali ini keempat kelas ada di peta. Selisih dua aturan kecil: 4.300 dari 90.000 piksel diberi kelas berbeda. Mana yang benar-benar lebih akurat? Jangan menilainya dari mata. Skrip 19.6 mengukurnya.
Bagian yang boleh diubah.
- Baris 9 dan 10, jalur. Ganti sesuai komputer Anda.
- Baris 12, NAMA. Ubah nama kelas atau jumlahnya, sesuai kolom
Kodepada area latih Anda. - Baris 25, EXTENT. Harus sama dengan luas citra.
- Baris 33, batas minimum piksel latih. Angka 4 adalah batas bawah agar kovarians bisa dihitung. Naikkan bila Anda ingin menuntut area latih yang lebih banyak.
- Baris 63-64, nama berkas. Ganti nama berkas hasil.
- Baris 65, daftar pasangan. Tambahkan metode lain di sini bila Anda menulisnya.
Jebakan.
- Area latih kosong atau terlalu sedikit. Baris 33 menghentikan skrip dengan
AssertionError: Area latih kelas 4 terlalu sedikit. Saya mengosongkan area latih kelas Lahan Terbuka pada salinan skrip untuk mengujinya. Tanpa baris pengaman itu, skrip jalan terus: layar menampilkan beberapaRuntimeWarning(yang pertamaMean of empty slice) dan barisLahan Terbuka | 0 | nan nan nan nan, dan hasilnya{'Hutan': 0, 'Kebun': 0, 'Sawah': 0, 'Lahan Terbuka': 90000}, yaitu seluruh peta menjadi satu kelas. Bila galat ini muncul, periksa kolomKodepada area latih danEXTENT-nya. Jangan menghapus baris 33 supaya galat semacam ini tidak diam-diam lolos. - Luas EXTENT tidak cocok. Sama seperti Skrip 19.4: bentuk array tidak sama dan skrip berhenti dengan
ValueError. - Area latih bukan titik uji. Jangan menilai peta dengan piksel yang sama dengan yang dipakai melatih. Hasilnya terlalu bagus. Skrip 19.6 memakai titik uji yang terpisah.
- Impor tak terpakai. Skrip mengimpor
processingdan memakainya hanya untuk rasterisasi. Tidak ada yang rusak. Ini hanya contoh membaca kode dengan kritis.
Latihan variasi.
- Cetak jumlah piksel per kelas sebagai persen, bukan jumlah.
- Cetak berapa piksel yang kelasnya berbeda antara dua metode.
Contoh jawaban nomor 1, baris 66 menjadi:
print(nama, "-> persen per kelas:", {NAMA[k]: round(100.0 * int((arr == k).sum()) / arr.size, 1) for k in NAMA})Layar menampilkan jarak minimum -> persen per kelas: {'Hutan': 37.2, 'Kebun': 25.8, 'Sawah': 25.0, 'Lahan Terbuka': 12.0} dan kemiripan maksimum -> persen per kelas: {'Hutan': 37.1, 'Kebun': 25.8, 'Sawah': 24.9, 'Lahan Terbuka': 12.2}. Kata int(...) di tengah penting. Tanpa itu, layar menampilkan np.float64(37.2) di tiap nilai.
Contoh jawaban nomor 2, satu baris di akhir skrip:
print("Piksel yang kelasnya beda antara dua metode:", int((jarak_min != maks_lik).sum()))Layar menampilkan Piksel yang kelasnya beda antara dua metode: 4300.
Skrip 19.6: Seberapa benar peta ini? #
Berkas i2_06_uji_akurasi.py. Di dalam berkasnya tertulis "I2 Bab 6". Skrip ini memakai empat peta dari Skrip 19.4 dan 19.5, jadi jalankan keduanya lebih dulu.
Tujuan. Menilai empat peta hasil klasifikasi dengan 100 titik uji: membuat matriks kesalahan, menghitung akurasi keseluruhan dan kappa, merinci akurasi tiap kelas, lalu membandingkannya dengan alat GRASS r.kappa.
Bahan. Titik_Uji.gpkg dari paket-i2 (100 titik, 25 per kelas, kolom Kode_Acuan berisi kelas sebenarnya dari 1 sampai 4), serta empat peta di folder hasil: tak_terbimbing_k6.tif, tak_terbimbing_k10.tif, terbimbing_jarak_min.tif, dan terbimbing_maks_lik.tif. Bagian akhir skrip memanggil alat GRASS. Alat itu harus aktif di Processing QGIS Anda. [CEK]
Gagasan pokoknya seperti ujian. Soal ujian (titik uji) harus berbeda dari soal latihan (area latih). Kunci jawaban (kelas sebenarnya di lapangan) harus bisa dipercaya. Dari perbandingan jawaban peta dan kunci, muncul satu tabel yang disebut matriks kesalahan.
Lima istilah baru untuk skrip ini:
- Titik uji: titik yang kelas sebenarnya Anda ketahui dan tidak ikut melatih.
- Matriks kesalahan: tabel kelas sebenarnya (baris) lawan kelas pada peta (kolom).
- Akurasi keseluruhan: titik yang benar dibagi semua titik.
- Akurasi pembuat dan pengguna: ketepatan dilihat dari sisi lapangan (per baris) dan dari sisi peta (per kolom).
- Kappa: kecocokan setelah dikurangi kecocokan karena kebetulan.
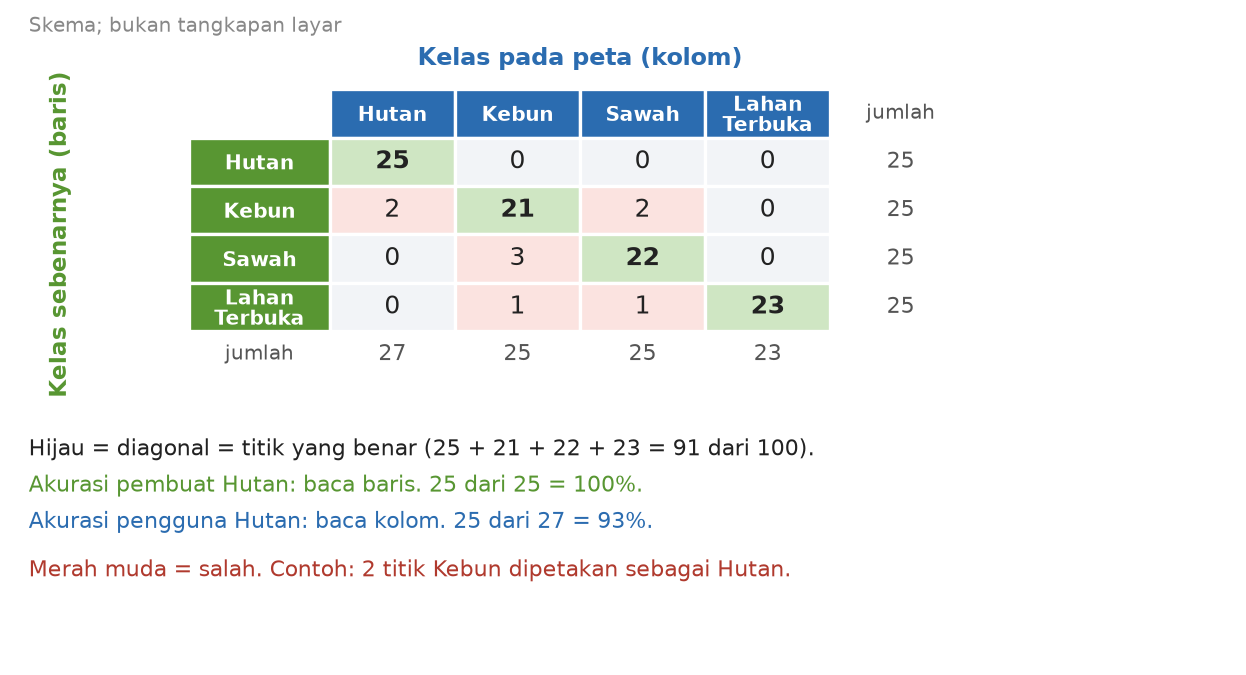
Rumus yang dipakai skrip, dengan angka dari gambar:
- Akurasi keseluruhan = jumlah diagonal dibagi jumlah semua titik = (25 + 21 + 22 + 23) dibagi 100 = 91%.
- Akurasi pembuat kelas X = diagonal dibagi jumlah baris X. Untuk Hutan: 25 dibagi 25 = 100%.
- Akurasi pengguna kelas X = diagonal dibagi jumlah kolom X. Untuk Hutan: 25 dibagi 27 = 93%.
- Kappa = (akurasi keseluruhan dikurangi p) dibagi (1 dikurangi p), dengan p adalah kecocokan yang diharapkan secara kebetulan. Di sini p = 0,25, jadi kappa = (0,91 - 0,25) dibagi 0,75 = 0,88.
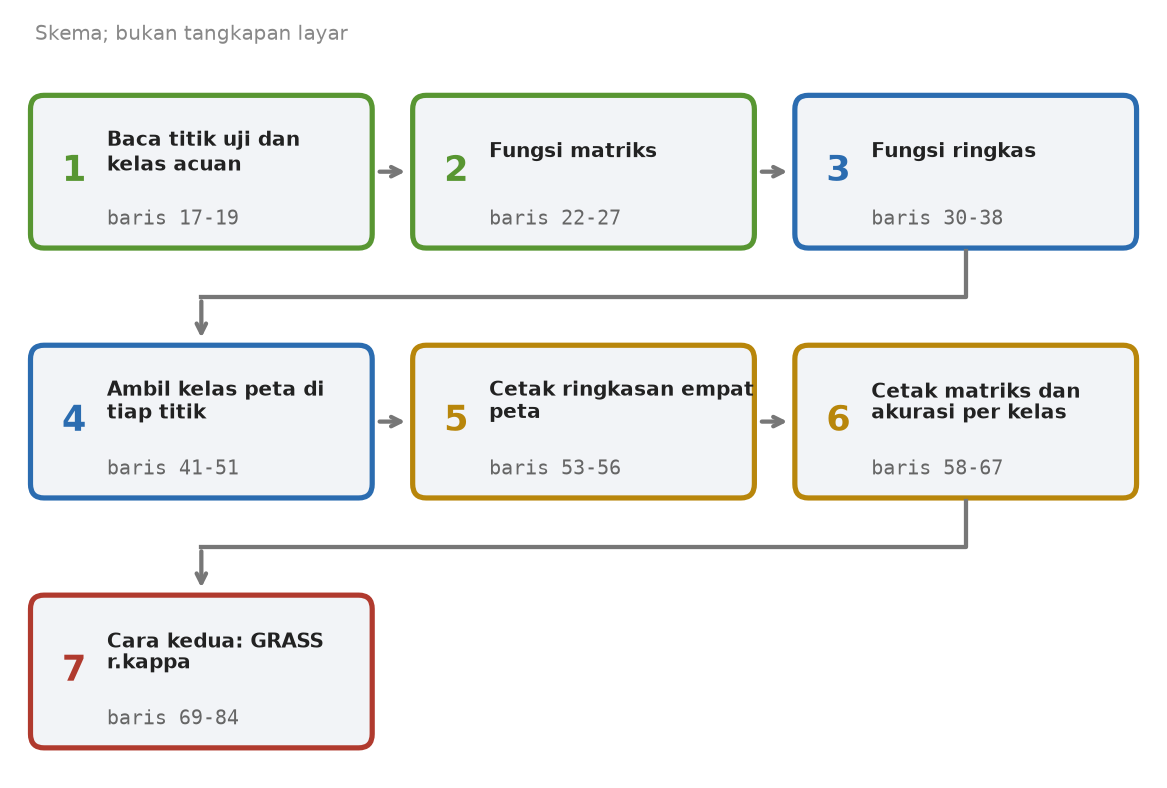
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 6: uji akurasi (matriks kesalahan, akurasi keseluruhan, kappa). Penulis: Badar Mubarok Yogaswara
# Jalankan setelah skrip bab 4 dan bab 5 (memakai peta hasilnya di folder hasil).
import os
import numpy as np
import processing
from qgis.core import QgsRasterLayer, QgsVectorLayer

PAKET_I2 = os.environ.get("I2_PAKET", r"C:/KPH_Contoh/paket-i2")
HASIL = r"C:/temp/hasil_i2"
NAMA = {1: "Hutan", 2: "Kebun", 3: "Sawah", 4: "Lahan Terbuka"}
PETA = [("Tak terbimbing, 6 kluster", "tak_terbimbing_k6.tif"),
        ("Tak terbimbing, 10 kluster", "tak_terbimbing_k10.tif"),
        ("Terbimbing, jarak minimum", "terbimbing_jarak_min.tif"),
        ("Terbimbing, kemiripan maksimum", "terbimbing_maks_lik.tif")]

titik = QgsVectorLayer(os.path.join(PAKET_I2, "Titik_Uji.gpkg") + "|layername=Titik_Uji", "Titik_Uji", "ogr")
acuan = np.array([f["Kode_Acuan"] for f in titik.getFeatures()])
print("Jumlah titik uji:", len(acuan), "| per kelas:", {NAMA[k]: int((acuan == k).sum()) for k in NAMA})


def matriks(acuan, hasil):
    """Baris = kelas acuan (lapangan), kolom = kelas hasil peta."""
    m = np.zeros((4, 4), int)
    for a, h in zip(acuan, hasil):
        m[a - 1, h - 1] += 1
    return m


def ringkas(m):
    n = m.sum()
    oa = np.trace(m) / n
    pe = (m.sum(axis=1) * m.sum(axis=0)).sum() / n ** 2        # kecocokan yang diharapkan karena kebetulan
    kappa = (oa - pe) / (1 - pe)
    with np.errstate(divide="ignore", invalid="ignore"):       # kolom kosong (kelas tidak pernah muncul di peta) menghasilkan nan
        pa = np.diag(m) / m.sum(axis=1)                        # akurasi pembuat: dari yang benar di lapangan, berapa yang terpetakan benar
        ua = np.diag(m) / m.sum(axis=0)                        # akurasi pengguna: dari yang dipetakan kelas X, berapa yang benar
    return oa, kappa, pa, ua


hasil_semua = {}
for judul, berkas in PETA:
    lyr = QgsRasterLayer(os.path.join(HASIL, berkas), "peta")
    sampel = processing.run("native:rastersampling", {"INPUT": titik, "RASTERCOPY": lyr, "COLUMN_PREFIX": "Peta_", "OUTPUT": "TEMPORARY_OUTPUT"})["OUTPUT"]
    pasang = [(a, f["Peta_1"]) for a, f in zip(acuan, sampel.getFeatures())]
    hasil = np.array([int(h) for a, h in pasang if h is not None])
    acuan_ok = np.array([a for a, h in pasang if h is not None])
    if len(hasil) < len(acuan):
        print("PERINGATAN: %d titik uji di luar raster dilewati" % (len(acuan) - len(hasil)))
    assert hasil.min() >= 1, "Peta berisi kelas 0 (kluster tanpa nama)"
    hasil_semua[judul] = (matriks(acuan_ok, hasil), ringkas(matriks(acuan_ok, hasil)))

print("\nRingkasan:")
print("%-34s | akurasi keseluruhan | kappa" % "Peta")
for judul, (m, (oa, kappa, pa, ua)) in hasil_semua.items():
    print("%-34s | %5.0f%% (%d dari %d)    | %.2f" % (judul, 100 * oa, np.trace(m), m.sum(), kappa))

judul = "Terbimbing, kemiripan maksimum"
m, (oa, kappa, pa, ua) = hasil_semua[judul]
print("\nMatriks kesalahan: %s (baris = acuan, kolom = hasil peta)" % judul)
print("%-14s" % "" + "".join("%14s" % NAMA[k] for k in NAMA) + "   jumlah")
for i, k in enumerate(NAMA):
    print("%-14s" % NAMA[k] + "".join("%14d" % v for v in m[i]) + "%8d" % m[i].sum())
print("%-14s" % "jumlah" + "".join("%14d" % v for v in m.sum(axis=0)))
print("\nKelas          | akurasi pembuat | akurasi pengguna")
for i, k in enumerate(NAMA):
    print("%-14s | %6.0f%%          | %6.0f%%" % (NAMA[k], 100 * pa[i], 100 * ua[i]))

# Cara kedua (alat GRASS di Processing QGIS): r.kappa membandingkan dua raster, yaitu peta hasil dan raster acuan.
# Raster acuan dibuat dari titik uji: piksel yang tidak ada titiknya bernilai 0 (kosong) dan diabaikan.
acuan_tif = os.path.join(HASIL, "acuan_titik.tif")
processing.run("gdal:rasterize", {
    "INPUT": os.path.join(PAKET_I2, "Titik_Uji.gpkg"), "FIELD": "Kode_Acuan", "UNITS": 1, "WIDTH": 1.0, "HEIGHT": 1.0,
    "EXTENT": "312000,312300,9996000,9996300 [EPSG:32749]", "NODATA": 0, "DATA_TYPE": 0, "INIT": 0, "OUTPUT": acuan_tif})
laporan = os.path.join(HASIL, "kappa_maks_lik.txt")
processing.run("grass:r.kappa", {"classification": os.path.join(HASIL, "terbimbing_maks_lik.tif"), "reference": acuan_tif,
                                 "title": "Uji akurasi", "-h": False, "-w": False, "output": laporan})
with open(laporan) as f:
    baris = f.read().splitlines()
print("\nLaporan r.kappa (bagian ringkasan):")
for i, b in enumerate(baris):
    if b.startswith(("Kappa\t", "Obs Correct")):
        print(b)
        print(baris[i + 1])
Penjelasan baris demi baris. Skrip ini 84 baris, jadi dibagi empat blok. Nomor baris mengikuti berkas di atas.
Blok A: baris 1 sampai 19, persiapan.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-3 | komentar | Baris 3 mengingatkan: jalankan setelah Skrip 19.4 dan 19.5. |
| 4-7 | import os, import numpy as np, import processing, from qgis.core import ... | Panggil perkakas yang dipakai. |
| 9-11 | PAKET_I2, HASIL, NAMA | PAKET_I2 dibaca dari I2_PAKET, HASIL jalur hasil, dan kamus nama kelas seperti di Skrip 19.4. Sesuaikan jalurnya. |
| 12-15 | PETA = [("Tak terbimbing, 6 kluster", "tak_terbimbing_k6.tif"), ...] | Daftar berisi empat pasangan: judul peta dan nama berkasnya. Daftar ini yang akan dinilai satu per satu. |
| 17 | titik = QgsVectorLayer(..., "Titik_Uji", "ogr") | Buka layer titik uji. Pola sumber datanya sama dengan Skrip 19.3. |
| 18 | acuan = np.array([f["Kode_Acuan"] for f in titik.getFeatures()]) | Ambil kolom Kode_Acuan dari semua titik menjadi satu array. Urutannya sama dengan urutan titik. |
| 19 | print("Jumlah titik uji:", len(acuan), ..., {...}) | Cetak jumlah titik, lalu jumlah titik tiap kelas lewat kamus yang dibuat dalam satu baris. Teks di dalam kutip hanyalah penanda. |
Blok B: baris 22 sampai 38, dua fungsi hitung.
| Baris | Tulisan | Artinya |
|---|---|---|
| 22-23 | def matriks(acuan, hasil): | Resep yang membuat matriks. Docstring mengingatkan: baris adalah kelas acuan (lapangan), kolom adalah kelas hasil peta. |
| 24 | m = np.zeros((4, 4), int) | Siapkan tabel 4 kali 4 berisi bilangan bulat 0. |
| 25-26 | for a, h in zip(acuan, hasil): lalu m[a - 1, h - 1] += 1 | zip menjodohkan titik pertama dengan titik pertama, dan seterusnya. Untuk tiap pasangan, tambah satu di sel (baris a, kolom h). Dikurangi 1 karena nomor sel mulai dari 0, sedangkan nomor kelas mulai dari 1. |
| 27 | return m | Kembalikan matriksnya. |
| 30-31 | def ringkas(m): lalu n = m.sum() | Resep yang merangkum matriks. n adalah jumlah semua titik. |
| 32 | oa = np.trace(m) / n | np.trace menjumlahkan diagonal. Dibagi n memberi akurasi keseluruhan. |
| 33-34 | pe = ... lalu kappa = (oa - pe) / (1 - pe) | pe adalah kecocokan yang diharapkan karena kebetulan (p di rumus). Lalu hitung kappa. |
| 35-37 | with np.errstate(divide="ignore", invalid="ignore"): | Blok dengan aturan khusus: jangan memberi peringatan bila ada pembagian dengan nol. Kolom kosong (kelas yang tidak pernah muncul di peta) akan membagi dengan nol, dan hasilnya nan. pa adalah akurasi pembuat (diagonal dibagi jumlah baris). ua adalah akurasi pengguna (diagonal dibagi jumlah kolom). |
| 38 | return oa, kappa, pa, ua | Kembalikan empat hasil sekaligus. |
Blok C: baris 41 sampai 67, menilai tiap peta dan mencetak.
| Baris | Tulisan | Artinya |
|---|---|---|
| 41-43 | hasil_semua = {}, for judul, berkas in PETA:, lyr = QgsRasterLayer(...) | Siapkan kamus kosong untuk menampung hasil. Untuk tiap peta di daftar, buka rasternya. |
| 44 | sampel = processing.run("native:rastersampling", {...})["OUTPUT"] | Ambil nilai peta di tiap titik uji. COLUMN_PREFIX "Peta_" membuat kolom baru bernama Peta_1 (awalan ditambah nomor band). TEMPORARY_OUTPUT berarti hasil sementara di memori, bukan berkas. |
| 45 | pasang = [(a, f["Peta_1"]) for a, f in zip(acuan, sampel.getFeatures())] | Jodohkan kelas acuan tiap titik dengan kelas peta di titik itu. Hasilnya daftar pasangan. Bila sebuah titik jatuh di luar raster, kelas petanya None (tidak ada nilai, lihat Bab 7). |
| 46 | hasil = np.array([int(h) for a, h in pasang if h is not None]) | Ambil kelas peta dari pasangan, tetapi hanya yang bukan None. Kata if di ujung daftar menyaring: pasangan yang kosong dilewati. |
| 47 | acuan_ok = np.array([a for a, h in pasang if h is not None]) | Saringan yang sama untuk kelas acuan. Hasilnya acuan_ok selalu sepanjang hasil, sehingga keduanya tetap berpasangan. |
| 48-49 | if len(hasil) < len(acuan): lalu print("PERINGATAN: ...") | Bila ada titik yang terbuang karena di luar raster, cetak berapa banyak. Titik yang dilewati tidak hilang diam-diam. |
| 50 | assert hasil.min() >= 1, "Peta berisi kelas 0 (kluster tanpa nama)" | Pengaman. assert menghentikan skrip bila syaratnya salah (lihat Bab 10). Syaratnya: kelas terkecil di peta minimal 1. Nilai 0 berarti ada kluster yang belum bernama (lihat Skrip 19.4). |
| 51 | hasil_semua[judul] = (matriks(acuan_ok, hasil), ringkas(matriks(acuan_ok, hasil))) | Simpan satu pasangan di kamus: matriksnya, dan ringkasannya. Fungsi matriks dipanggil dua kali untuk hasil yang sama. Boleh disederhanakan, tetapi tidak salah. |
| 53-56 | for judul, (m, (oa, kappa, pa, ua)) in hasil_semua.items(): | Cetak ringkasan tiap peta. Bagian dalam kurung membongkar pasangan bersarang menjadi lima kotak. Format %5.0f%% mencetak persen tanpa desimal, dan %% mencetak tanda persen. |
| 58-59 | judul = "Terbimbing, kemiripan maksimum" lalu m, (...) = hasil_semua[judul] | Pilih satu peta untuk dirinci, lalu ambil matriks dan ringkasannya dari kamus. |
| 60-64 | print(...) dan for i, k in enumerate(NAMA): | Cetak matriks sebagai tabel. enumerate(NAMA) memberi nomor baris i (mulai 0) dan nomor kelas k (mulai 1). "%14d" % v memberi lebar 14 huruf pada tiap angka. Baris terakhir mencetak jumlah per kolom. |
| 65-67 | print(...) dan for i, k in enumerate(NAMA): | Cetak akurasi pembuat dan pengguna tiap kelas. |
Blok D: baris 69 sampai 84, cara kedua dengan GRASS.
| Baris | Tulisan | Artinya |
|---|---|---|
| 69-70 | komentar | Cara kedua memakai alat GRASS r.kappa, yang membandingkan dua raster: peta hasil dan raster acuan. |
| 71-74 | processing.run("gdal:rasterize", {...}) | Ubah titik uji menjadi raster acuan. Piksel tanpa titik bernilai 0, dan diabaikan oleh r.kappa. Pengaturannya sama dengan di Skrip 19.4. |
| 75 | laporan = os.path.join(HASIL, "kappa_maks_lik.txt") | Nama berkas teks untuk laporan. |
| 76-77 | processing.run("grass:r.kappa", {...}) | Jalankan alat. classification adalah peta yang dinilai, reference adalah raster acuan, dan output adalah berkas laporan. |
| 78-79 | with open(laporan) as f: lalu baris = f.read().splitlines() | Buka berkas teks, baca seluruhnya, lalu pecah menjadi daftar baris. Blok with menutup berkas sendiri (Bab 9). |
| 80-84 | print(...), for i, b in enumerate(baris): lalu if b.startswith((..., ...)): | Telusuri baris laporan. Bila sebuah baris diawali kata "Kappa" yang diikuti karakter tab, atau diawali "Obs Correct", cetak baris itu dan baris sesudahnya (baris[i + 1]), tempat angkanya berada. Dua awalan ditulis dalam kurung sebagai satu pasangan. Karakter tab ditulis \t (garis miring terbalik lalu huruf t), jadi tidak bisa berubah menjadi spasi saat disalin. |
Hasil. Layar menampilkan:
Jumlah titik uji: 100 | per kelas: {'Hutan': 25, 'Kebun': 25, 'Sawah': 25, 'Lahan Terbuka': 25}

Ringkasan:
Peta                               | akurasi keseluruhan | kappa
Tak terbimbing, 6 kluster          |    75% (75 dari 100)    | 0.67
Tak terbimbing, 10 kluster         |    98% (98 dari 100)    | 0.97
Terbimbing, jarak minimum          |    88% (88 dari 100)    | 0.84
Terbimbing, kemiripan maksimum     |    91% (91 dari 100)    | 0.88

Matriks kesalahan: Terbimbing, kemiripan maksimum (baris = acuan, kolom = hasil peta)
                       Hutan         Kebun         Sawah Lahan Terbuka   jumlah
Hutan                     25             0             0             0      25
Kebun                      2            21             2             0      25
Sawah                      0             3            22             0      25
Lahan Terbuka              0             1             1            23      25
jumlah                    27            25            25            23

Kelas          | akurasi pembuat | akurasi pengguna
Hutan          |    100%          |     93%
Kebun          |     84%          |     84%
Sawah          |     88%          |     88%
Lahan Terbuka  |     92%          |    100%

Laporan r.kappa (bagian ringkasan):
Kappa		Kappa Variance	MCC
0.880000	0.001455	0.880470
Obs Correct	Total Obs	% Observed Correct
91		100		91.000000
Dari hasil ini Anda tahu empat hal. Pertama, peta kemiripan maksimum benar di 91 dari 100 titik, dengan kappa 0,88. Kedua, hitungan NumPy dan r.kappa memberi angka sama (kappa 0,88; 91 dari 100), jadi dua cara saling membenarkan. Ketiga, Kebun dan Sawah paling sering tertukar (baris Kebun: 2 jadi Hutan, 2 jadi Sawah). Keempat, peta 10 kluster tampak paling baik (98%), tetapi ada tiga catatan di bawah.
Hati-hati membaca angka.
- Satu angka keseluruhan bisa menipu. Peta 6 kluster mendapat 75%, tetapi Kebun hilang dari peta. Akurasi pembuat Kebun 0%. Dari 25 titik Kebun, 18 menjadi Sawah dan 7 menjadi Hutan. [terbukti: lihat Latihan variasi]
- Selisih kecil belum tentu nyata. Hanya ada 100 titik, jadi satu titik berarti satu poin persen. Selang kepercayaan 95% yang kasar (rumus p ± 1,96 x akar dari p(1-p)/n) untuk 91% kira-kira 85% sampai 97%. Untuk 98%, kira-kira 95% sampai 100%. Kedua selang itu bertumpang tindih. [dihitung dari rumus]
- Peta 10 kluster diberi nama dengan area latih. Caranya setengah terbimbing. Data ini juga sintetis dan bersih. Pada data sungguhan, selisih tak terbimbing dan terbimbing jarang sekecil ini.
Bagian yang boleh diubah.
- Baris 9 dan 10, jalur. Ganti sesuai komputer Anda.
- Baris 12-15, daftar PETA. Tambah atau hapus pasangan untuk menilai peta lain, asal berkasnya ada di folder hasil dan kelasnya bernomor 1 sampai 4.
- Baris 58, judul peta yang dirinci. Harus persis sama dengan salah satu judul di
PETA. Pada uji,"Terbimbing, jarak minimum"menghasilkan matriks dengan Kebun: 5 titik jadi Hutan dan 20 benar. - Baris 11 dan 24, jumlah kelas. Bila jumlah kelas bukan empat, ubah
NAMAdan ukuran(4, 4)di baris 24. - Baris 71-74, luas EXTENT. Harus sama dengan luas citra.
Jebakan.
- Nilai 0 pada peta menghentikan skrip. Peta tak terbimbing bisa bernilai 0 bila sebuah kluster tidak punya piksel latih (lihat Jebakan Skrip 19.4). Baris 50 menangkapnya: skrip berhenti dengan
AssertionError: Peta berisi kelas 0 (kluster tanpa nama). Pengaman ini perlu karena tanpanya hasilnya diam-diam salah. Pada baris 26,m[a - 1, h - 1]untukh= 0 berarti kolom nomor -1. Python menghitung -1 dari belakang, yaitu kolom terakhir, Lahan Terbuka. Titik itu terhitung salah ke Lahan Terbuka, tanpa pesan galat. Saya mengujinya pada peta buatan yang menjadikan kelas Hutan bernilai 0, dengan baris 50 dilepas. Seluruh 25 titik Hutan masuk kolom Lahan Terbuka:
Matriks kesalahan: Uji nol (baris = acuan, kolom = hasil peta)
                       Hutan         Kebun         Sawah Lahan Terbuka   jumlah
Hutan                      0             0             0            25      25
Kebun                      0            21             2             2      25
Sawah                      0             3            22             0      25
Lahan Terbuka              0             1             1            23      25
jumlah                     0            25            25            50
Kolom Hutan kosong, dan akurasi pengguna Hutan tercetak nan%. Petunjuknya: ada kolom yang kosong, atau jumlah kolom Lahan Terbuka membengkak. Dengan baris 50 terpasang, Anda tidak sampai ke tampilan ini.
- Titik di luar raster dilewati, bukan dihitung. Bila ada titik uji yang jatuh di luar peta,
Peta_1kosong (None). Baris 45-47 membuang titik itu, dan baris 48-49 mencetakPERINGATAN: 1 titik uji di luar raster dilewati. Saya mengujinya dengan menambah satu titik di luar area. Skrip selesai, dan hasilnya sama dengan 100 titik asli. Peringatan muncul satu kali per peta. Bacalah peringatan itu: titik yang terbuang berarti penilaian memakai titik lebih sedikit. - Alat GRASS tidak ada. Bagian baris 69-84 butuh penyedia GRASS aktif di Processing. Bila tidak ada, bagian itu gagal, sedangkan cetakan sebelum baris 69 tetap tampil. [CEK di QGIS Anda]
- Karakter tab ditulis
\t. Pada baris 82, awalan"Kappa\t"memakai\tuntuk karakter tab, sebab laporan GRASS memisahkan kolom dengan tab. Bila awalan ini berisi tab asli, lalu editor mengubah tab menjadi spasi saat Anda menyalin, baris Kappa tidak ditemukan dan hanya barisObs Correctyang tercetak, tanpa galat. Penulisan\taman dari masalah itu. Jangan mengganti\tdengan spasi. - Berkas laporan dibuka tanpa encoding. Di baris 78 tidak ada pengaturan huruf. Untuk laporan berisi angka dan huruf Latin, ini aman.
Latihan variasi.
- Cetak matriks kesalahan peta 6 kluster, bukan peta kemiripan maksimum.
- Cetak akurasi pembuat Kebun untuk keempat peta.
Contoh jawaban nomor 1, baris 58 menjadi:
judul = "Tak terbimbing, 6 kluster"Layar menampilkan matriks berikut. Baris Kebun menunjukkan masalahnya: 7 titik jadi Hutan, 0 benar, dan 18 jadi Sawah.
Matriks kesalahan: Tak terbimbing, 6 kluster (baris = acuan, kolom = hasil peta)
                       Hutan         Kebun         Sawah Lahan Terbuka   jumlah
Hutan                     25             0             0             0      25
Kebun                      7             0            18             0      25
Sawah                      0             0            25             0      25
Lahan Terbuka              0             0             0            25      25
jumlah                    32             0            43            25
Contoh jawaban nomor 2, tambahkan di akhir bagian cetak (sebelum baris 69):
for judul, (m, (oa, kappa, pa, ua)) in hasil_semua.items():
    print("%-34s akurasi pembuat Kebun: %3.0f%%" % (judul, 100 * pa[1]))
Layar menampilkan 0% untuk peta 6 kluster, 100% untuk 10 kluster, 80% untuk jarak minimum, dan 84% untuk kemiripan maksimum. Angka pa[1] adalah isi kedua, yaitu kelas Kebun (hitungan mulai dari 0).
Skrip 19.7: Lahan terbuka di lereng curam #
Berkas i2_07_terpadu.py. Di dalam berkasnya tertulis "I2 Bab 6 (latihan terpadu)". Skrip ini memakai terbimbing_maks_lik.tif (Skrip 19.5) dan slope_persen.tif (Skrip 19.2).
Tujuan. Menghitung luas lahan terbuka yang berada di lereng curam (di atas 25 persen), dan berapa persen dari seluruh lahan terbuka pada peta.
Bahan. Dua hasil sebelumnya di folder hasil. Peta kelas berpiksel 1 m dan berukuran 300 m x 300 m. Peta kemiringan berpiksel 2 m dan berukuran 400 m x 400 m. Keduanya berbagi sudut kiri bawah yang sama.
Lima istilah baru untuk skrip ini:
- Perbandingan logika: rumus yang hasilnya benar (1) atau salah (0), misalnya
"x@1" > 25. - AND: operator "dan". Hasilnya 1 hanya bila kedua syarat benar di piksel yang sama.
- Piksel beda ukuran: dua raster yang pikselnya tidak sama besar. Raster Calculator tetap bisa menggabungkannya bila Anda menentukan ukuran hasil.
- Array benar-salah: array yang isinya
TrueatauFalse, hasil perbandingan sepertiarr == 4. - Menjumlahkan benar-salah:
arr.sum()pada array 0 dan 1 (atau benar dan salah) menghitung berapa piksel yang bernilai 1.
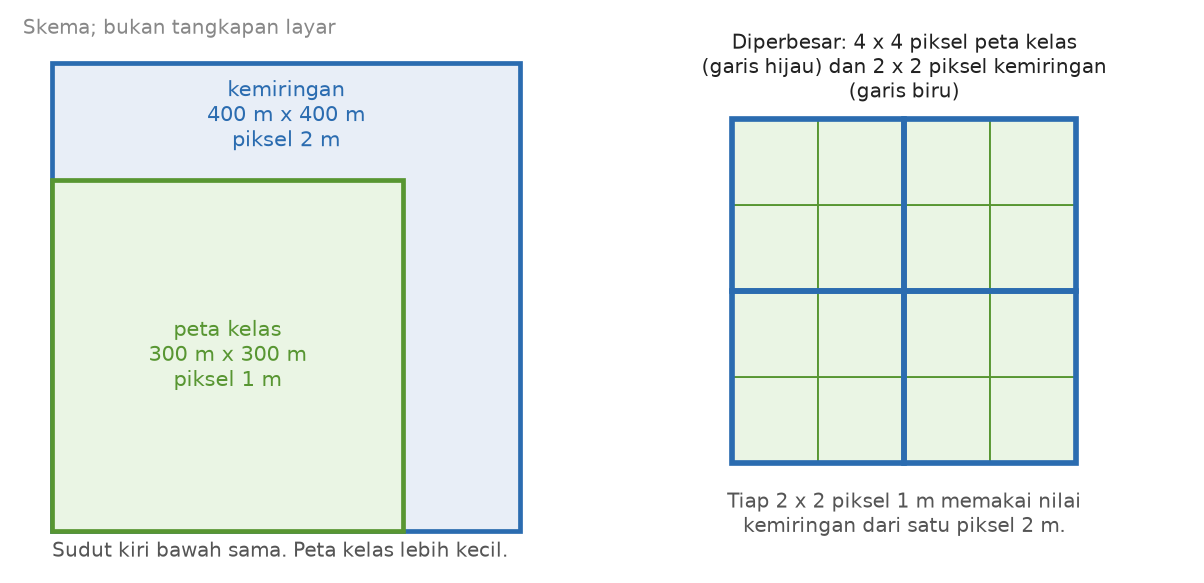
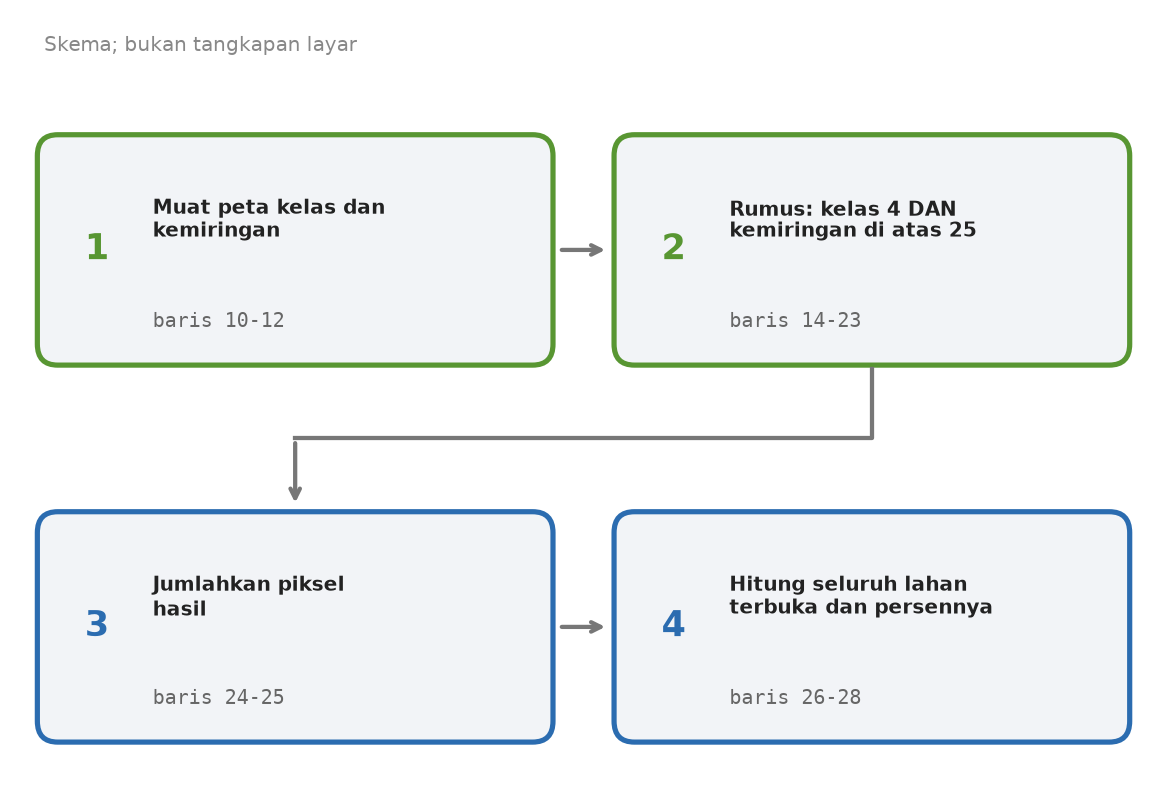
Skrip utuh:
# -*- coding: utf-8 -*-
# I2 Bab 6 (latihan terpadu): lahan terbuka di lereng curam, dari peta kelas (1 m) dan kemiringan (2 m).
# Jalankan setelah skrip bab 2 dan bab 5. Penulis: Badar Mubarok Yogaswara
import os
import numpy as np
import processing
from osgeo import gdal
from qgis.core import QgsRasterLayer

HASIL = r"C:/temp/hasil_i2"
kelas = QgsRasterLayer(os.path.join(HASIL, "terbimbing_maks_lik.tif"), "peta_kelas")
persen = QgsRasterLayer(os.path.join(HASIL, "slope_persen.tif"), "slope_persen")

# Dua raster berbeda ukuran piksel (1 m dan 2 m). Raster calculator memakai ukuran dan luas yang Anda tentukan,
# di sini mengikuti peta kelas: piksel 1 m, area 300 m x 300 m. Nilai kemiringan diambil dari piksel 2 m yang menutupinya.
AMBANG = 25                       # batas kemiringan (persen)
KELAS_UJI = 4                     # kelas yang dicari (4 = Lahan Terbuka)
NAMA_KELAS = {1: "hutan", 2: "kebun", 3: "sawah", 4: "lahan terbuka"}[KELAS_UJI]
luas_ha = kelas.rasterUnitsPerPixelX() * kelas.rasterUnitsPerPixelY() / 10000.0     # luas satu piksel (ha)
keluar = os.path.join(HASIL, "terbuka_curam.tif")
processing.run("native:rastercalc", {
    "EXPRESSION": '("peta_kelas@1" = %d) AND ("slope_persen@1" > %d)' % (KELAS_UJI, AMBANG), "LAYERS": [kelas, persen],
    "CELL_SIZE": kelas.rasterUnitsPerPixelX(), "EXTENT": kelas.extent(), "CRS": kelas.crs(), "OUTPUT": keluar})
arr = gdal.Open(keluar).ReadAsArray()
print("Piksel %s di lereng > %d persen:" % (NAMA_KELAS, AMBANG), int(arr.sum()), "= %.3f ha" % (arr.sum() * luas_ha))
terbuka = gdal.Open(os.path.join(HASIL, "terbimbing_maks_lik.tif")).ReadAsArray() == KELAS_UJI
print("Seluruh %s pada peta: %d piksel = %.3f ha; bagian di lereng curam: %.1f%%" % (
    NAMA_KELAS, terbuka.sum(), terbuka.sum() * luas_ha, 100.0 * arr.sum() / terbuka.sum()))
Penjelasan baris demi baris. Nomor baris mengikuti berkas di atas.
| Baris | Tulisan | Artinya |
|---|---|---|
| 1-3 | komentar | Judul, penulis, dan pesan: jalankan setelah skrip kemiringan (19.2) dan klasifikasi terbimbing (19.5). |
| 4-8 | import os, import numpy as np, import processing, from osgeo import gdal, from qgis.core import QgsRasterLayer | Panggil perkakas. Kotak np sebenarnya tidak dipakai langsung di skrip ini (sisa impor). Tidak berpengaruh. |
| 10 | HASIL = r"C:/temp/hasil_i2" | Satu-satunya jalur di skrip ini. Ganti sesuai komputer Anda. |
| 11-12 | kelas = QgsRasterLayer(...) dan persen = QgsRasterLayer(...) | Buka dua peta hasil. Nama layer peta_kelas dan slope_persen harus sama dengan nama di rumus baris 22. |
| 14-15 | komentar | Menjelaskan bahwa dua raster berbeda ukuran piksel. Hasil mengikuti peta kelas (piksel 1 m, area 300 m x 300 m). Nilai kemiringan diambil dari piksel 2 m yang menutupinya. |
| 16 | AMBANG = 25 | Batas kemiringan dalam persen. Semua pengaturan analisis kini ada di sini, bukan terselip di dalam rumus. |
| 17 | KELAS_UJI = 4 | Nomor kelas yang dicari. Angka 4 berarti Lahan Terbuka. |
| 18 | NAMA_KELAS = {1: "hutan", 2: "kebun", 3: "sawah", 4: "lahan terbuka"}[KELAS_UJI] | Kamus nama kelas (Bab 5), lalu langsung diambil isinya dengan kunci KELAS_UJI. Hasilnya teks "lahan terbuka". Teks ini dipakai pada hasil cetakan supaya selalu cocok dengan kelas yang dicari. |
| 19 | luas_ha = kelas.rasterUnitsPerPixelX() * kelas.rasterUnitsPerPixelY() / 10000.0 | Luas satu piksel dalam hektare: lebar piksel kali tinggi piksel, dibagi 10.000 (1 hektare = 10.000 meter persegi). Ukuran piksel dibaca dari peta kelas, jadi hitungan tetap benar bila pikselnya bukan 1 m. |
| 20 | keluar = os.path.join(HASIL, "terbuka_curam.tif") | Nama berkas hasil. |
| 21-23 | processing.run("native:rastercalc", {...}) | Jalankan Raster Calculator. Rumus dirakit dengan %d, yang diisi KELAS_UJI dan AMBANG. Dengan nilai bawaan, rumusnya ("peta_kelas@1" = 4) AND ("slope_persen@1" > 25): bernilai 1 di piksel yang kelasnya 4 (Lahan Terbuka) dan kemiringannya lebih dari 25 persen. Di dalam rumus ini, satu tanda = berarti "sama dengan". Ukuran piksel, luas, dan CRS mengikuti peta kelas. |
| 24 | arr = gdal.Open(keluar).ReadAsArray() | Baca hasil menjadi array berisi 0 dan 1. |
| 25 | print("Piksel %s di lereng > %d persen:" % (NAMA_KELAS, AMBANG), int(arr.sum()), "= %.3f ha" % (arr.sum() * luas_ha)) | arr.sum() menjumlahkan semua nilai, yang berarti menghitung piksel bernilai 1. Dikali luas_ha memberi luas dalam hektare. Nama kelas dan ambang di teks diisi dari NAMA_KELAS dan AMBANG. |
| 26 | terbuka = gdal.Open(...).ReadAsArray() == KELAS_UJI | Baca peta kelas, lalu bandingkan dengan KELAS_UJI. Hasilnya array benar-salah: True di piksel kelas yang dicari. |
| 27-28 | print("Seluruh %s pada peta: ..." % (...)) | Cetak jumlah piksel kelas itu, luasnya (terbuka.sum() * luas_ha), dan persen yang berada di lereng curam: 100.0 * arr.sum() / terbuka.sum(). |
Hasil. Layar menampilkan:
Piksel lahan terbuka di lereng > 25 persen: 7709 = 0.771 ha
Seluruh lahan terbuka pada peta: 10944 piksel = 1.094 ha; bagian di lereng curam: 70.4%
Dari hasil ini Anda tahu: sekitar 0,77 hektare lahan terbuka berada di lereng curam. Itu 70,4% dari seluruh lahan terbuka pada peta (1,094 ha). Jawaban untuk Kepala Seksi: sekitar tujuh dari sepuluh bagian lahan terbuka ada di lereng curam, sehingga ia kandidat pertama untuk kegiatan rehabilitasi. Saya memeriksa angka ini dengan hitungan mandiri NumPy yang mencocokkan koordinat tiap piksel 1 m ke piksel 2 m yang menutupinya. Hasilnya sama: 7.709 dari 10.944 piksel. Ingat, ini data sintetis, jadi angkanya hanya untuk belajar.
Bagian yang boleh diubah.
- Baris 17, nomor kelas. Cukup ganti di satu tempat. Rumus, pembanding di baris 26, dan teks cetakan ikut berubah. Pada uji, kelas 1 (Hutan) dengan kemiringan lebih dari 15 menghasilkan 14.612 piksel (1,461 ha) dari 33.415 piksel hutan (43,7%).
- Baris 16, angka 25. Ambang kemiringan. Ganti sesuai aturan instansi Anda. [CEK]
- Baris 18, kamus nama. Bila kelas Anda bukan empat, ubah kamus ini.
- Baris 19, luas satu piksel. Dihitung otomatis dari ukuran piksel peta kelas. Untuk piksel 0,5 m, luas satu piksel 0,25 meter persegi, dan skrip menghitungnya sendiri. Tidak ada angka yang perlu Anda ganti.
Jebakan.
- Nomor kelas di luar kamus. Bila
KELAS_UJIbukan 1 sampai 4, baris 18 berhenti denganKeyError, sebab kamus tidak punya kunci itu. Itu pengaman yang disengaja: skrip tidak mencetak laporan dengan nama kelas yang salah. Tambahkan kelas baru ke kamus lebih dulu. - Kelas ada di kamus tetapi tidak ada di peta. Bila
terbuka.sum()bernilai 0, skrip tidak berhenti denganZeroDivisionError. Ia mencetakRuntimeWarning: invalid value encountered in dividedan persennya tertulisnan%. - Skrip sebelumnya belum dijalankan. Bila
terbimbing_maks_lik.tiftidak ada, skrip berhenti di baris 21 denganQgsProcessingException: Unable to execute algorithm, laluIncorrect parameter value for EXTENT. Galat yang sama muncul karena layer kosong tidak punya luas (lihat Jebakan Skrip 19.1). Bila hanyaslope_persen.tifyang tidak ada, skrip TIDAK berhenti dan tidak memberi pesan apa pun, tetapi angkanya ngawur dan bisa berbeda tiap kali dijalankan (pada uji tercetak10863 = 1.086 ha ... 99.3%, lalu10728 = 1.073 ha ... 98.0%, padahal yang benar7709 = 0.771 ha ... 70.4%). Jalankan Skrip 19.2 dan 19.5 lebih dulu, dan periksa bahwa kedua berkas ada. - Dua raster tidak saling menutupi. Peta kelas hanya sebagian dari area kemiringan. Hasil hanya berlaku di area yang dimiliki kedua raster. [kemungkinan] Di data ini, area peta kelas berada seluruhnya di dalam area kemiringan (cocok dengan ukuran masing-masing raster).
- Impor tak terpakai.
nptidak dipakai. Impor yang tidak terpakai bisa dihapus, dan skrip tetap berjalan sama.
Latihan variasi.
- Hitung hutan (kelas 1) yang berada di lereng lebih dari 15 persen.
- Hitung sawah (kelas 3) yang berada di lereng 8 persen atau kurang.
Contoh jawaban nomor 1, baris 16 dan 17 menjadi:
AMBANG = 15                       # batas kemiringan (persen)
KELAS_UJI = 1                     # kelas yang dicari (1 = Hutan)
Layar menampilkan Piksel hutan di lereng > 15 persen: 14612 = 1.461 ha, lalu Seluruh hutan pada peta: 33415 piksel = 3.342 ha; bagian di lereng curam: 43.7%. Kata "hutan" muncul sendiri dari kamus di baris 18.
Contoh jawaban nomor 2: ubah baris 16 menjadi AMBANG = 8 dan baris 17 menjadi KELAS_UJI = 3. Ganti juga tanda > pada rumus (baris 22) menjadi <=, dan pada teks baris 25 menjadi <=. Layar menampilkan 6511 = 0.651 ha dan sawah seluruhnya 22447 piksel = 2.245 ha, dengan bagian di lereng datar 29.0%. Kata "lereng curam" di baris 28 tidak lagi tepat, jadi ubah sesuai kebutuhan.
Cek paham #
- Mengapa rata-rata peta berisi 0 dan 1 sama dengan bagian piksel yang bernilai 1?
- Pada hasil 6 kluster di Skrip 19.4, mengapa kelas Kebun tidak ada di peta?
- Mengapa uji akurasi memakai titik uji, bukan area latih?
Jawaban.
- Karena menjumlahkan 0 dan 1 sama dengan menghitung jumlah angka 1, dan membaginya dengan jumlah semua piksel memberi bagiannya. Contoh: rata-rata
vegsebesar 0,6666 berarti sekitar dua pertiga piksel bervegetasi. - Satu kluster (kluster 4) memuat hampir sama banyak piksel latih Kebun dan Sawah. Satu kluster hanya bisa diberi satu nama, jadi Sawah menang dan Kebun hilang.
- Menilai peta dengan piksel yang dipakai melatihnya membuat hasil terlalu bagus, seperti murid diuji dengan soal latihannya sendiri. Titik uji berada di luar area latih.
Kesalahan umum #
- Melompati urutan skrip. Perbaikan: jalankan 19.2 sebelum 19.3 dan 19.7, serta 19.4 dan 19.5 sebelum 19.6.
- Membiarkan jalur contoh. Jalur bawaan hanyalah alamat contoh. Perbaikan: ganti jalur di bagian atas tiap skrip.
- Menjalankan dari terminal python-qgis biasa. Muncul
ModuleNotFoundError: No module named 'processing'. Perbaikan: pakai Editor Skrip di dalam QGIS. - Percaya satu angka. Akurasi keseluruhan bagus tidak berarti semua kelas ada. Perbaikan: baca juga matriks, akurasi per kelas, dan jumlah piksel per kelas.
Ringkasan dan latihan #
- Skrip raster bekerja dengan dua cara: memanggil alat QGIS (
processing.run) atau menghitung sendiri dengan NumPy dan GDAL. - Aljabar raster menjalankan rumus di tiap piksel. Rata-rata peta 0/1 adalah bagian piksel bernilai 1.
- Turunan DEM (kemiringan, arah lereng, bayangan bukit) lahir dari satu DEM. Kemiringan persen sama dengan tan derajat dikali 100.
- K-means mengelompokkan piksel tanpa contoh, dan hasilnya bergantung pada titik awal acak. Klasifikasi terbimbing memakai area latih.
- Uji akurasi memakai titik uji yang terpisah. Waspadai kolom kosong dan nilai 0 pada peta.
Latihan. Ubah Skrip 19.1 agar menghitung NDVI pada Citra_Lahan.tif dari paket-i2. Band berurutan sama (R, G, B, NIR). Bagian mana yang Anda ganti, dan bagian mana yang boleh dihapus karena tidak dipakai lagi?
Tabel perbandingan: tujuh skrip sekilas #
| Skrip | Masukan | Keluaran utama | Butuh dulu |
|---|---|---|---|
| 19.1 aljabar raster | Citra_Komposit.tif, DSM_Drone.tif, DTM_Drone.tif | ndvi.tif, veg.tif, chm.tif, tajuk_tinggi.tif | tidak ada |
| 19.2 turunan DEM | DEM_Lereng.tif | slope_derajat.tif, aspect.tif, hillshade.tif, slope_persen.tif | tidak ada |
| 19.3 kelas lereng | slope_persen.tif, Batas_KPH.gpkg | kelas_lereng.tif, luas_kelas_per_kph.gpkg | 19.2 |
| 19.4 tak terbimbing | Citra_Lahan.tif, Area_Latih.gpkg | area_latih.tif, tak_terbimbing_k6.tif, tak_terbimbing_k10.tif | tidak ada |
| 19.5 terbimbing | Citra_Lahan.tif, Area_Latih.gpkg | terbimbing_jarak_min.tif, terbimbing_maks_lik.tif | tidak ada |
| 19.6 uji akurasi | Titik_Uji.gpkg, empat peta hasil | acuan_titik.tif, kappa_maks_lik.txt | 19.4 dan 19.5 |
| 19.7 terpadu | terbimbing_maks_lik.tif, slope_persen.tif | terbuka_curam.tif | 19.2 dan 19.5 |